GPT-6 Sol と Luna が API に:料金は半額、ただし272K超は全体が割増(Chat Completions の制約も)
AI開発者の手帖
OpenAI が GPT-6 Sol と GPT-6 Luna を公開しました。API の changelog の日付は9月22日で、API では gpt-6-sol と gpt-6-luna の名前で使えます。OpenAI の API や Codex を仕事で使っていて、GPT-5.6 からの切り替えを考えている方に関係します。OpenAI のモデルを使っていない方には、まだ関係しません。筆者は AI モデルの API 仕様や、モデルを移るときの注意点を公式資料と照らして追い、有料記事でも扱ってきました。本稿は、発表記事・changelog・2つのモデルページ・プロンプトキャッシュの記事を9月25日に突き合わせてまとめたものです。筆者は API を呼んで確かめてはいません。
何が出たか
発表記事によると、Sol と Luna は、今月出た最上位の GPT-6 Astra と同じような方法で学習した、速くて安いモデルです。Sol のモデルページは Sol を複雑なコーディングとエージェント向け、Luna のモデルページは Luna を用途を絞った大量の処理向けと位置づけています。どちらもテキストと画像を受け取り、テキストを返す推論モデルです。コンテキストは1,050,000トークン(入力は最大922,000、出力は最大128,000)で、reasoning.effort は none から max までの6段階、既定は medium です。
料金は GPT-5.6 の半額、ただし境目がある
100万トークンあたりの料金は、Sol が入力2ドル・出力10ドル、Luna が入力0.10ドル・出力0.50ドルです。発表記事は、GPT-5.6 の Sol と Luna の料金から50%下げたと書いています。ただし比べている相手は GPT-5.6 のプロモーション価格(promotional pricing)です。
モデルページには、発表記事より細かい条件が並んでいます。
- キャッシュから読んだ入力は通常の10%、キャッシュへの書き込みは1.25倍
- 入力が272Kトークンを超えるプロンプトは、入力とキャッシュが2倍、出力が1.5倍になり、割増はリクエスト全体にかかる
- Batch と Flex は半額、fast mode は2倍
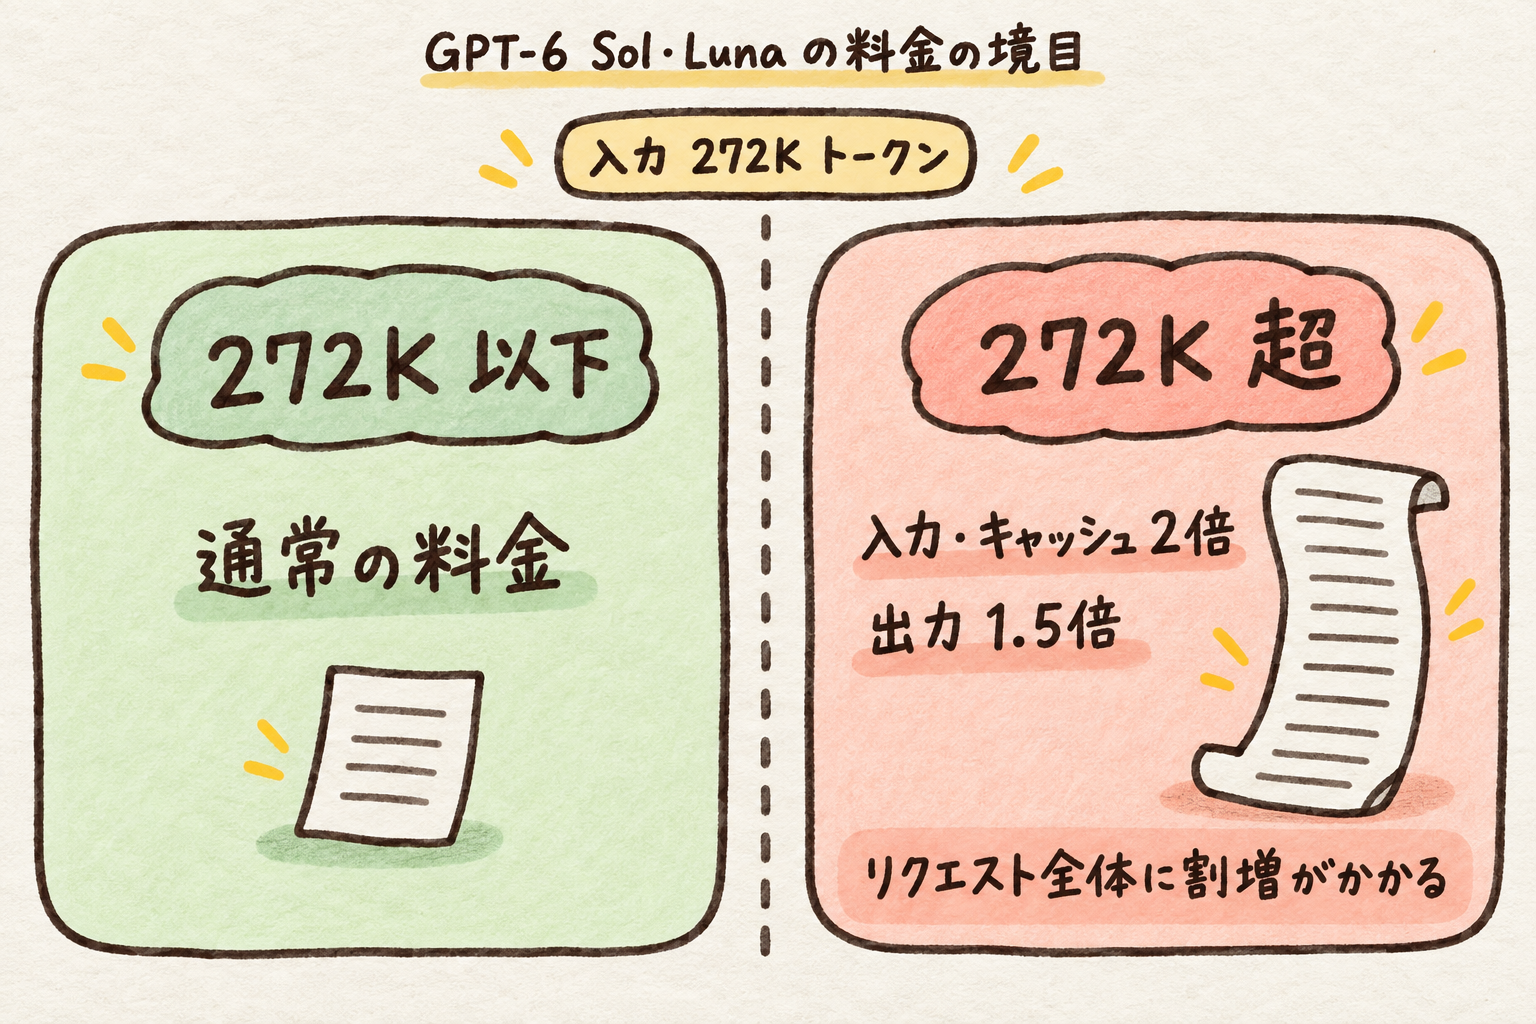
モデルページの料金の条件を筆者が図にしたものです。入力が272Kトークンを超えると、超えた分だけでなくリクエスト全体に割増がかかります。
長い資料を丸ごと渡す使い方では、272K を超えた時点で、それまでの分まで割増になります。コンテキストの上限が大きいことと、安く使える長さは別に考える必要があります。
Chat Completions では制約がある
Sol のモデルページによると、組み込みツールと function calling を使うなら Responses API を使います。Chat Completions で function calling を使えるのは、reasoning_effort が none のときだけです。Chat Completions のまま関数呼び出しを使っている既存のコードは、モデル名だけ差し替えると、この条件に当たります。Realtime・Assistants・fine-tuning には対応していません。
キャッシュの変更点
プロンプトキャッシュの記事によると、30分以内に再利用された対象の共有プレフィックスにキャッシュ割引が付きます。キャッシュを保ったまま推論量を変えるには、リクエストごとの推論量の指定は変えずに configuration_update を足します。ツールを使い分けたいときは、定義・スキーマ・順序を固定したまま allowed_tools で呼べるツールを絞るか、tool_choice を none にします。定義そのものを消すと再利用の前提が崩れるので、この記事は消さずに絞る使い方を勧めています。途中で指示を変えるときは、末尾に新しい developer メッセージを足します。どこまでをキャッシュするかを選ぶ明示的なブレークポイントと、キャッシュの状況を見るダッシュボード、ミスの原因を示す診断ツールも加わりました。
使える場所と、まだ分からないこと
ChatGPT Work と Codex では、Plus・Pro・Business・Enterprise・Edu のユーザーが使えます。Free と Go のユーザーは、デスクトップアプリで Luna を使えます。ChatGPT の Chat ではまだ使えません。
発表記事には、Claude Opus 5 や Claude Fable 5.1 と比べて、同じくらいの点数をずっと安い費用で出したというベンチマークが並んでいます。注記によると、GPT のスコアは OpenAI の研究環境か API で測ったもので、競合のスコアは公開されたレポートの数値です(Fable 5.1 の数値が無い項目は Fable 5 で代えています)。筆者はどれも確かめていません。自分の処理でどちらが安く済むかは、実際のプロンプトで測らないと分かりません。
次にやること
モデル名を差し替える前に、3つを見ておくと安全だと筆者は考えます。プロンプトが272Kを超えることがあるか、Chat Completions で function calling を使っているか、会話の途中でツールの定義を消していないか、の3つです。OpenAI への切り替えそのものを扱った有料記事はまだありません。既刊の有料記事は Claude のモデル移行を題材にしていますが、エラーを出さずに挙動が変わる箇所を、コードの中の文字列から探して直す手順の組み立ては同じです。
参考になったら、記事下部のライクとXの共有ボタンから応援してもらえるとうれしいです。
 この記事のライター