止まった時計は、1日に2回だけ正しい時刻を示します。
それ以外の時間は、ずっと間違ったまま静止しています。
壁にかかっていると、ぱっと見ただけでは止まっているとわかりません。
「まだ14時か」と思いながら、22時間以上ずっと間違った時刻で動いてしまいます。
データの計測でも、まったく同じことが起きていました。Lilyの話を、今日はしようと思います。
あなたは今、こうなっていませんか?
• 自動でデータを集めるツールを使っているが、「今日も動いたか」を確認したのは最初の1回だけ • エラーのメールや通知が来ていないから、正常に動いていると思っている • 「最近この記事が伸びていないな」という判断が、実は数日前の古いデータに基づいている • 自動化した仕組みが止まっても、誰も教えてくれない状況になっている
先に結論を言います。エラーが出なくても、データは静かに止まります。そして誰も、気づかせてくれません。
この記事では、Lilyが26時間以上データが更新されていなかったことに気づかず、古い数字で記事のパフォーマンスを判断し続けていた実話と、どう直したかを書きます。
26時間、数字が止まっていた話
その日、何がおかしかったか
ある朝、いつものようにnoteのデータをチェックしていました。
「最近この記事への反応が落ちているかも」と感じながら、過去7日分の数字を眺めていたんです。
前の週と比べて伸びていない気がして、記事の方向性を変えるべきか、少し悩んでいました。
でも実は、その時点からさかのぼって26時間以上、データが止まっていたんです。
「伸び悩んでいる」という判断そのものが、昨日のスナップショットに基づいたものでした。
何かを判断しているつもりで、判断の土台が揺れていたことになります。
何も動いていなかったのに、見た目は「普通」だった
データ収集のツールは、毎日自動で動くように設定しています。
問題は、動いた形跡はあるのに、中身が更新されていなかったことでした。
画面には昨日のデータがそのまま表示されていて、エラーのメッセージも何もありません。
「これ、止まってるな」と気づいたのは、別の作業中にたまたまログを見たときです。
ログには status: waiting とだけ書かれていました。
「待機中」という状態で、ジョブ自体は生きているんですよね。
これがいちばん厄介です。
止まっているのではなく、ただずっと「並んで待っている」状態なので、エラー扱いにはなりません。
その場で背筋がすっとしました。
「じゃあ今朝の判断は、1日前のデータに基づいていたのか」と思って。
📕 AIエージェントと自動化の全工程をまとめた総集編 手順・コード・テンプレをそのまま渡しています
🤖【完全版】月商160万円の「寝てても回る仕組み」をゼロから30日で組む全工程|2026年10月版・Claude Code×AIエージェント・特典40ファイル・毎月更新
原因は「ブラウザ待ち」の行列だった
データ収集にブラウザは要らなかった
Lilyが使っているデータ収集は、noteの情報をAPIというルート(公式の出入り口)から直接取ってきます。
ブラウザで画面を開く必要は、本来まったくありません。
ところが仕組みを組んだときに、ブラウザを使う別の作業と同じキューに入れてしまっていました。
Playwright(ブラウザ自動化ツール)を使う別の処理のキューに、APIアクセスだけで完結する処理が混在していた、ということです。
ブラウザを使わない作業なのに、ブラウザが空くのを待っている状態になっていたんです!
行列の前が詰まると、後ろも全部止まる
Playwrightのブラウザインスタンスは、同時に立ち上げられる数に上限があります。
設定ファイルの concurrency の値が小さく、実質1本しか並列で動かせない状態でした。
ブラウザを使う別の処理が何かの拍子に時間をかけると、後ろに並んでいたものも動けなくなります。
これ、エラーではないんですよね。
「失敗した」わけじゃなくて「まだ待っている」という状態なので、アラートが出ません。
スーパーのレジに例えるなら、前の人の会計がずっと終わらないまま、後ろの人が何時間も並び続けている状態です。
誰も怒っていないし、店員さんもエラーを出していない。でもレジは全然進んでいません。
キューに「タイムアウトなし」という盲点があった
もっと言うと、そのキューには timeout の設定がありませんでした。
「何分待っても応答がなければ諦める」という動作をしないんです。
前のジョブが終わるまで、理論上は何時間でも待ち続けます。
これが26時間という時間につながった直接の原因でした。
timeout を設定しておけば、一定時間後にエラーとしてログに記録されます。
エラーが記録されれば、通知を設定してある場合はSlackやメールに飛ばせます。
timeout: 300(5分)のように設定しておくだけで、気づくタイミングが「26時間後」ではなく「5分後」になります。
「タイムアウトなし」のまま動かし続けることは、詰まったときに誰も気づかない仕組みを作っているのと同じです。
なぜ26時間も気づけなかったのか
「最近は正常だった」という思い込み
データ収集の仕組みは、設定してから毎日動いていました。
1週間も2週間も問題なく動いていたので、「今日も動いているはず」という前提が固まっていたんです。
昨日動いた。一昨日も動いた。だから今日も動いている。
この推論、論理的に見えるんですが、これが盲点になりました。
継続的に動いていた実績があるほど、「今日も大丈夫」という感覚は強くなります。
でも実績は過去のことで、今日の動作を保証するものではありません。
確認コストがゼロに近いのに、「大丈夫だろう」という思い込みで確認を省いていたんです。
データが「それっぽく見える」のが一番こわい
止まっていても、画面に表示されているのは直近のデータです。
昨日の数字がそのまま今日の数字として見えていて、違和感がありません。
「今週は伸び悩んでいるな」「この記事は反応が薄いな」という判断を、26時間分古いデータで行っていました。
正確なデータを集めているつもりで、実は昨日のスナップショットを見ていたんです。
これを知ったとき、しんどかったです、、、
何かを判断している気分でいたのに、判断の土台が揺れていたことになるので。
「伸び悩んでいる」という判断も、実際には確認できない
もっと困ったのは、26時間止まっていた間の判断が「正しかったのかどうか」を確かめる方法がない点です。
古いデータを見て「この記事は今週反応が薄い」と判断した内容は、そのまま次の行動に影響します。
「もう少し別のテーマで書いてみようか」という思考が、古いデータを土台にして進んでいました。
気づいて直したから良かったものの、1週間気づかなかったとしたら、判断のずれがもっと大きくなっていたと思います。
データが古かった期間のログは残っていますが、その間に何が起きていたかは「本当は分からない」ままです。
「あのときの判断は正しかったのか」という問いに、答えを出す方法がないんです。
ひとり運営に「監視者」はいない
チームがあった頃は、誰かが止まったことに気づいた
Lilyは以前、月3,000万円規模の広告運用をチームでやっていました。
そのときは、計測ツールが止まれば誰かが気づきました。
「今日のレポートが来ていないけど、どうした?」とSlackで声がかかります。
「昨日から数字が動いていないね、何かあった?」と誰かが指摘してくれます。
チームで動いていると、データを見る人間が複数いるので、1人が気づかなくても誰かが気づきます。
チーム自体が、計測インフラの「監視機能」を担っていたんです。
ひとりだと、気づいてくれる人がいない
ひとり運営では、その仕組みが丸ごとありません。
止まっても、怒ってくれる人も、指摘してくれる人も、いないんです。
自動化した仕組みが静かに詰まっていて、誰も何も言わない。
画面には昨日のデータが表示されていて、見た目は正常に見える。
これが、ひとり運営の構造的な盲点だと思います。
自動化の密度を上げるほど、「止まっても気づかない」リスクが上がっていくんです。
「誰も確認しない」は組織ではありえない状態
組織でマーケをやっていた頃、計測インフラの担保はチームが分業でやっていました。
データエンジニアが集めて、マーケがチェックして、マネージャーがレポートを承認する。
どこかで止まれば、誰かがおかしいと感じます。
このフローが、意図せず「監視」の役割を果たしていたんです。
ひとりで回すと、その流れが全部1人に集まります。
設定するのも自分、使うのも自分、確認するのも自分。
どこかが抜けても、誰も補完してくれません。
自動化によって「全部自分でできる」ようになるのは良いことです。
でも同時に、「全部自分で確認しなければならない」という責任も生まれるんですよね。
どう直したか
ブラウザ待ちの行列から切り離して動かす
対処は比較的シンプルでした。
データ収集の処理を、Playwrightのキューから外して、独立したスクリプトとして動かすようにしました。
APIにアクセスするだけの処理には、ブラウザのセッションが不要です。
requests や httpx といったHTTPクライアントのライブラリを使えば、ブラウザの状態にまったく左右されません。
設定ファイルから browser_context: playwright の指定を消して、APIクライアントのみで動く構成に変えました。
修正後すぐに確認すると、当日分のデータが正しく更新されていました!
「作業の種類」で動かす仕組みを分ける
今回の失敗を一言で言うと、「ブラウザが必要な作業」と「必要ない作業」を同じキューに混ぜていたことです。
片方が詰まれば全部が止まる、という構造になっていました。
料理で言えば、電子レンジを使う料理と、鍋を使う料理を、同じ「電子レンジが空いてから」というルールで順番待ちさせていたようなものです(笑)
鍋は鍋で独立して動かせるのに、わざわざ電子レンジを待たせていました。
作業の種類によって、動かす仕組みを分けておく。
これ、動いている間はなかなか気づかないことです。
うまく動いているからこそ、構造の問題に気づきにくいんですよね。
直した後の確認の仕方
修正後、最初にやったのは「今日のデータが今日の日付で入っているか」の確認です。
具体的には、データストアの updated_at フィールドと、スクリプトの実行ログの completed_at を照合しました。
両方が当日のタイムスタンプになっていれば、正常に収集されたということです。
このとき、ログファイルに status: completed と出力されていることも合わせて確認しました。
status: waiting のまま終わっていたら、また同じ問題が再現しています。
この確認作業そのものは1分もかかりません。
でもこれをやっていなかったから、26時間分の盲点が生まれました。
計測を「信頼できる状態」に保つための習慣
「最終更新日時」を必ず表示する
Lilyが最初に追加したのは、データに「最後に更新された時刻」を表示することです。
「このデータは本日12:35時点のものです」という表示を、ダッシュボードの上部に追加しました。
更新日時が昨日のままなら、「あ、止まっているかも」とすぐ気づけます。
たったこれだけで、見落としのリスクが大きく下がります。
数字が気になって確認を開いたとき、最初に目に入るのがこの更新時刻です。
「今日のデータ」として見ていたものが、実は12時間前のものだった、ということを防げます。
実装としては、データを書き込むスクリプトの最後で last_fetched_at を更新し、表示側でその値を読むだけです。
データベースでも、JSONファイルでも、仕組みは変わりません。
週に1回、「本当に動いているか」を確認する
自動化は設定したら終わり、ではないと今回で実感しました。
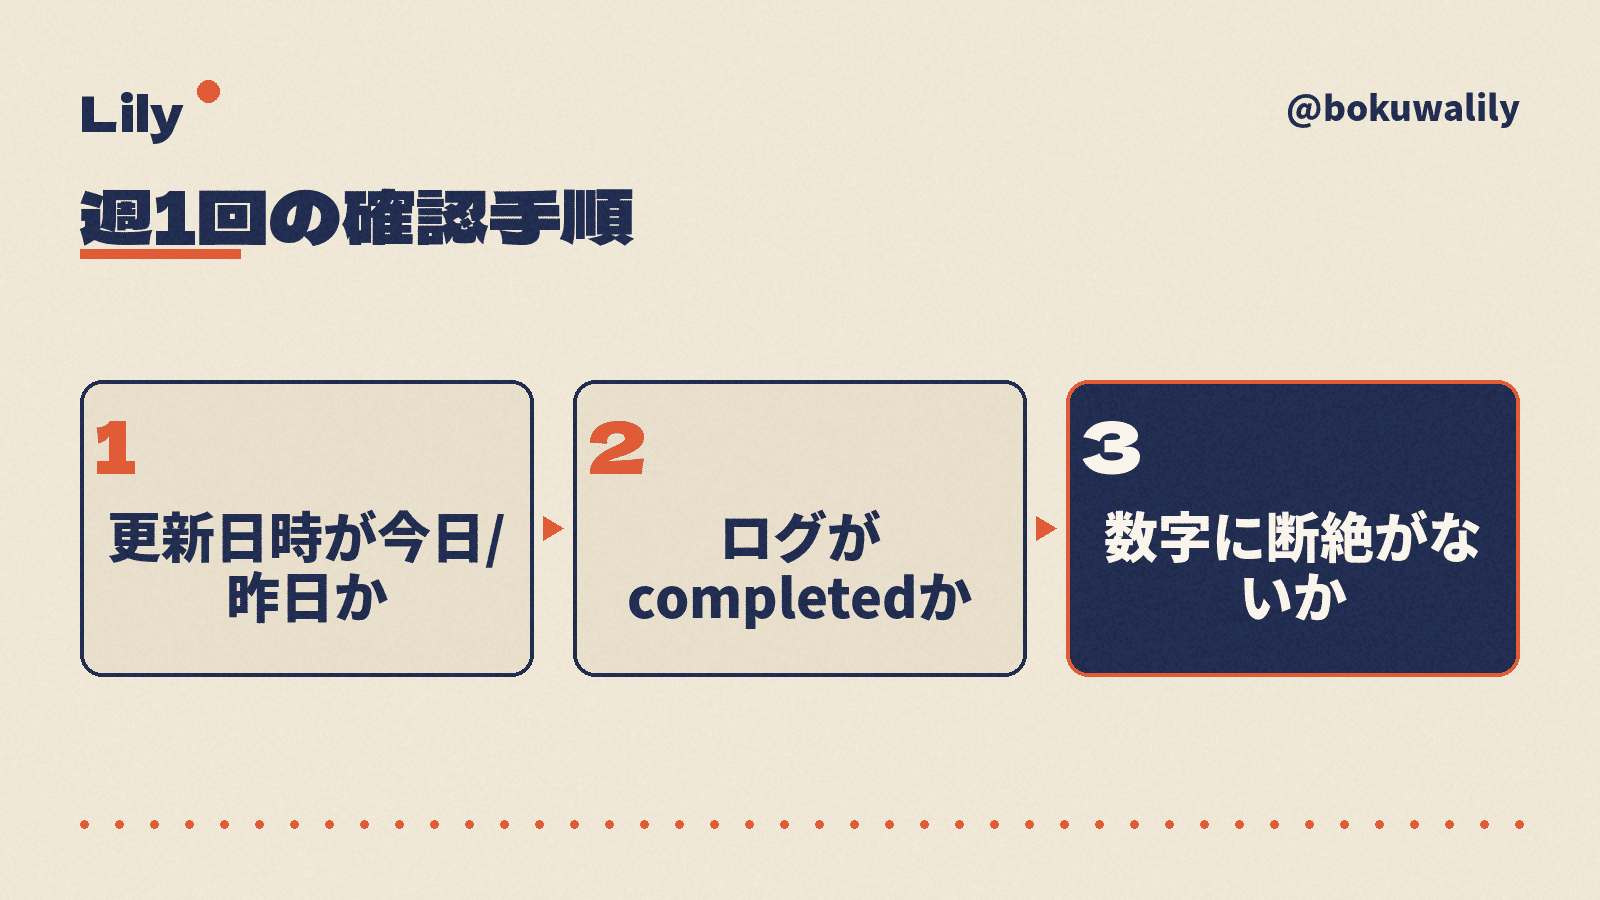
少なくとも週に1回、「今週分のデータが正しく入っているか」を確認する習慣を作りました。
確認の内容は3点です。
1つ目は、updated_at が今日や昨日の日付になっているか。
2つ目は、実行ログに status: completed が残っているか。
3つ目は、数字に極端な断絶がないか(前日比ゼロや、突然2倍になっていないか)。
この3点を確認するのに、慣れれば5分かかりません。
1週間に1度、5分かけて確認するだけで、168時間分の盲点を防げます。
自動化の恩恵を受けながら、手動確認のタイミングを定期的に入れておく。
手間に見えますが、これがないと「自動化を信じすぎて気づかない」という状況を繰り返します。
自動化が増えるほど、「止まったときの設計」が大事になる
エラーが出ない失敗が、一番こわい
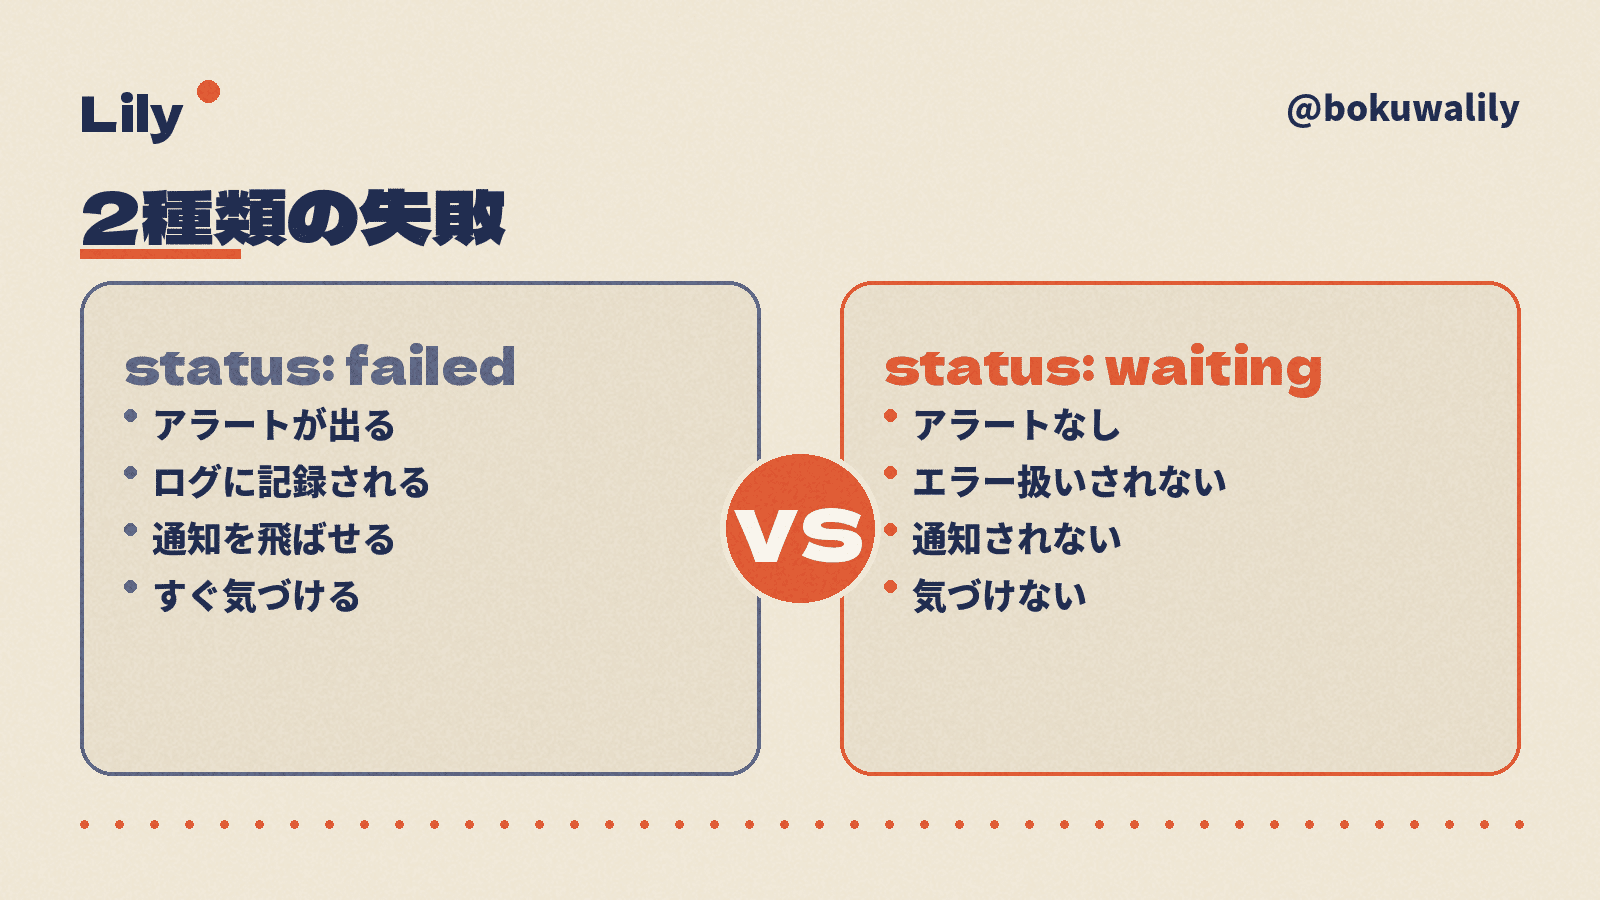
エラーが出る失敗は、すぐわかります。
赤い文字や警告が出れば、「何かおかしい」とすぐ気づけます。
でも今回のように、エラーが出ないまま止まっている失敗は、気づくのが難しいです。
静かに、見た目は正常なまま、データだけが古くなっていきます。
自動化した仕組みが増えるほど、この「静かな失敗」が起きる可能性も増えます。
1つの仕組みを作るたびに、「これが止まったとき、どう気づくか」を同時に設計しておく必要があります。
status: waiting と status: failed は、どちらも「正常に完了していない」という意味では同じです。
でも status: failed はアラートが出て、status: waiting は何も通知しない。
この非対称を意識しておくだけで、見落としのリスクが大きく変わります。
「動いているはず」を疑うタイミングを意識的に作る
毎日同じ時間に動いていると、「今日も動いているはず」という前提が強くなります。
これ自体は悪いことじゃないんですが、「疑うタイミング」を意識的に作っておかないと、今回みたいなことが起きます。
Lilyが今やっているのは、週1回の確認に加えて、数字が「いつもと違うな」と感じたときに「データが止まっていないか」を最初に疑うことです。
「パフォーマンスが落ちた」より先に「計測が止まっていないか」を確かめる、という順番の入れ替えです。
数字がおかしいとき、原因は2種類あります。
「本当にパフォーマンスが変わった」か、「計測が壊れている」かです。
後者を先に潰す癖をつけると、誤った前提で次の施策を打つリスクがなくなります。
「タイムアウト」と「完了通知」を最初から組み込む
今回の教訓で一番実装に直結するのは、「タイムアウト設定」と「完了通知」の2つです。
タイムアウトは、処理が一定時間以内に終わらなかったら強制的にエラーにする設定です。
timeout: 300 と設定しておくと、5分以内に終わらないジョブはエラー扱いになります。
エラーになれば、ログに記録されるし、通知を設定しておけばSlackやメールにも飛ばせます。
完了通知は、逆に「正常に終わったときに通知する」仕組みです。
「今日も動いた」という記録が残るので、「最後に通知が来たのはいつだっけ?」
という確認ができるようになります。
タイムアウトが「止まりを検出する網」で、完了通知が「動いた証拠の蓄積」です。
この2つを組み込んでおくだけで、「止まっても気づかない」という状況を大きく減らせます。
Lilyがこういう自動化の仕組みをどう作っているか、全体の構造はClaude Codeで作った自律環境の記事にまとめています。
興味のある方はフッターのリンクからどうぞ。
26時間が教えてくれたこと
「信頼できるデータ」は、意識しないと崩れる
データに基づいて判断する。マーケティングを長くやってきたLilyには、当たり前のことです。
でもそのデータ自体が正しいかどうかを、26時間も見落としていました。
正しいデータを集めることと、集めたデータが今日のものかを確かめることは、別の話なんです。
後者を怠ると、どれだけ丁寧に集めたデータも、判断の根拠にはなりません。
止まった時計が、そのことを教えてくれました。
「自動化しているから大丈夫」の油断が、一番静かに精度を下げる
今回の件を通じて、Lilyが一番学んだのはここです。
「自動化している」という事実が、確認の動機を消してしまうんです。
手作業でやっていれば、「今日はまだやっていないな」という感覚が残ります。
自動化すると、「どこかで動いているはず」という感覚に変わって、確認の意欲が落ちます。
自動化の恩恵は本物です。毎日同じ作業を手でやるより、ずっと効率的です。
でも「自動化=安心」ではなく、「自動化=確認を忘れやすくなる」と捉え直すことが、ひとり運営では大事だと思います。
今日、できる1つのこと
もし自動でデータを集めるツールや仕組みを使っているなら、今日一度「最後に動いた時刻」を確認してみてください。
想定通りの時刻になっていますか?
確認の方法がわからなければ、「最近このツールが正しく動いているか、怪しいと思ったことはあるか」を自分に問いかけてみてください。
「そういえば最近確認していないな」という感覚があるなら、それが確認のタイミングです。
Lilyが今回学んだのは、「動いているはず」という思い込みが、一番静かに判断精度を下げる、ということです。
まず今日のデータが今日のものかを確かめる。それだけで、26時間分の盲点を防げます。
📕 この記事の内容を、実装まで全部まとめた有料記事があります
手順・コード・テンプレをそのまま渡しています
AIで「寝てても回る仕組み」を30日で組む全手順|コード不要・特典40ファイル・毎月更新
 この記事の販売者