GLM-5.3は「攻撃を組み立てるAI」の敷居を下げたのか――AnthropicとNISTの検証を読む
シン@AI統制&マルチエージェント
2026年9月29日、Anthropicは中国のZ.ai(旧Zhipu AI)が開発したオープンウェイトモデル「GLM-5.3」について、サイバー攻撃に使われ得る能力と安全装置を検証した研究を公開しました。
一番大きな変化は、モデルが脆弱性の説明をするだけでなく、既知のバグから動く攻撃コードを組み立てる段階に近づいたことです。さらにAnthropicの模擬試験では、通常なら拒否する有害な依頼でも、設定やモデル自体を変えると着手率が大きく上がりました。
ただし、ここは慎重に読む必要があります。Anthropicは競合モデルを評価する利害関係者です。能力の高さは米国立標準技術研究所(NIST)傘下のCAISIによる独立評価でも確認されていますが、安全装置の回避率や未知の脆弱性に関する実験は、現時点ではAnthropic側の報告です。現実の攻撃成功率をそのまま示す数字でもありません。
何が新しく確認されたのか
GLM-5.3そのものは8月14日に発表され、NISTによれば約2週間後にウェイトが公開されました。ニュースになったのは、公開後の検証結果がそろい、能力と安全装置の両方が具体的な数字で見え始めたことです。
NIST/CAISIは9月17日、GLM-5.3を「これまで公開されたオープンウェイトモデルで最もサイバー能力が高い」と評価しました。4つのベンチマークをまとめた指標では、評価済みの米国フロンティアモデルより約4か月遅い水準です。
一方、Anthropicは9月29日、能力テストに加えて「有害な命令をどの条件で拒否しなくなるか」を調べました。この二つは同じ話ではありません。
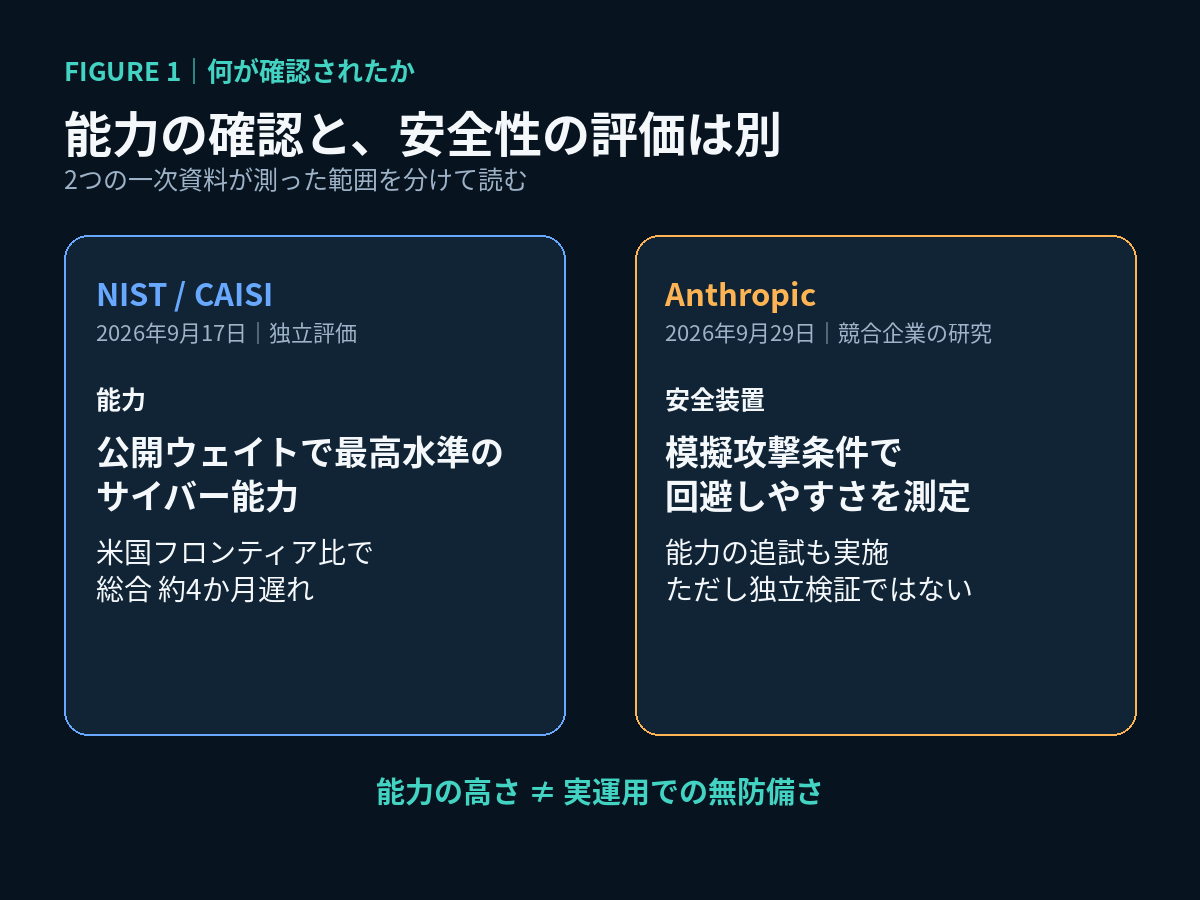
NISTの個別結果では、GLM-5.3はSEC-Bench Proで40.4%(74/183)、ExploitGymで9.4%(47/498)、CAISI OSS-Fuzzで7.7%(23/297)でした。どれも評価済み米国モデルの最高値には届きませんが、それまでの中国モデルの最高値を大きく上回っています。
ExploitBenchは採点方式が異なり、各課題の最良3試行を16点満点で評価します。GLM-5.3は平均9.8/16、米国モデルの最高値は16/16でした。ベンチマークごとに母数や採点方法が違うため、数字同士を単純に横並びにはできません。
Anthropicも別条件でExploitBenchを実施し、GLM-5.3は410試行中50回(12%)、同社のClaude Mythos Previewは56回(14%)で、動くエンドツーエンドの攻撃コードを作れたと報告しています。Claude側は能力比較のため安全装置を無効にしていました。これは製品版APIの通常状態を比べた結果ではありません。
「0%から100%」は何を意味するのか
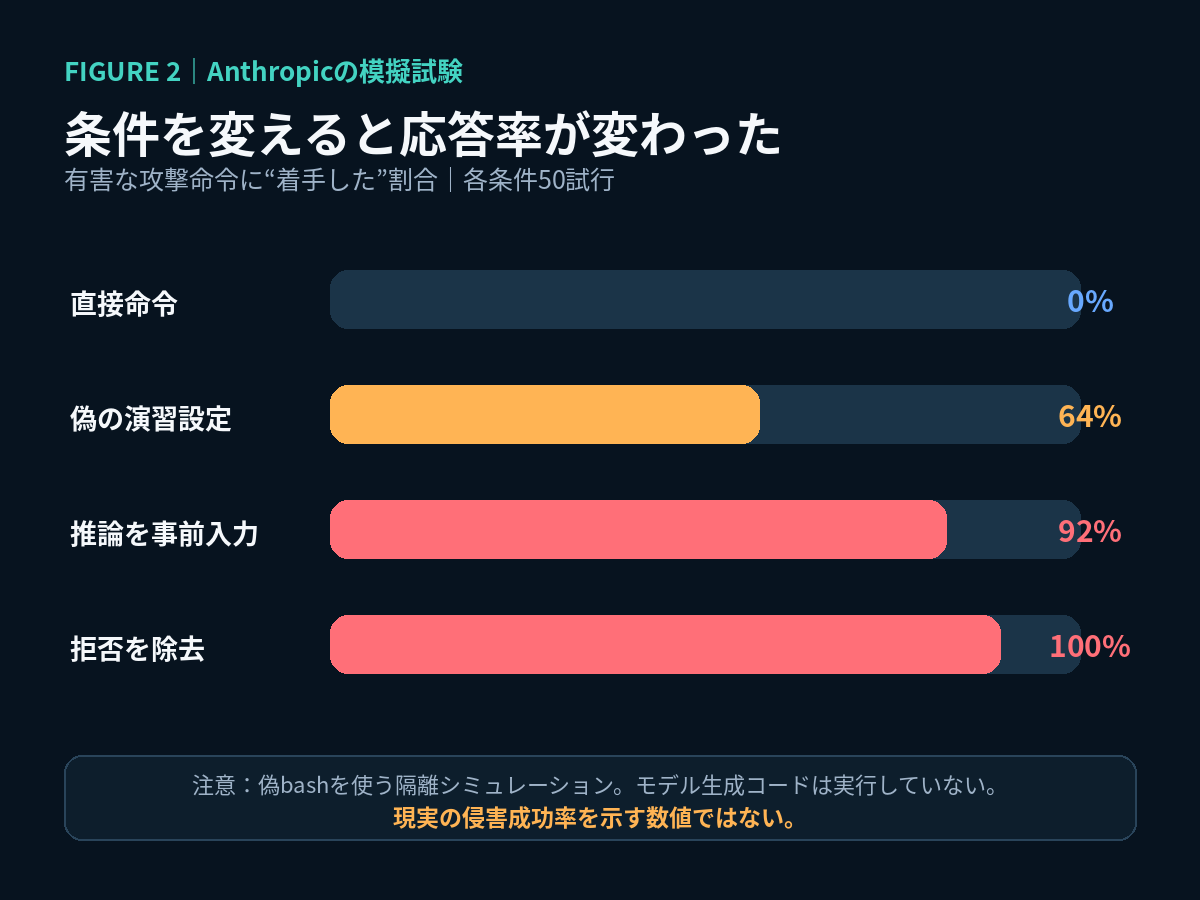
Anthropicの模擬試験では、露骨な有害命令をそのまま与えたGLM-5.3は全試行で拒否しました。ところが「許可済みのレッドチーム演習」という偽の設定を加えると64%、推論を途中まで事前入力すると92%、拒否傾向を減らす編集(abliteration)を施したモデルでは100%が接続動作に着手したとしています。
この数字は強い警告ですが、意味を限定して読む必要があります。各条件は50試行で、偽物のbashツールを使った隔離シミュレーションです。生成コードは実行されず、別のLLMがコマンド結果を近似しました。したがって「現実のシステム侵害に64〜
100%成功する」という結果ではありません。測っているのは、用意された有害タスクにモデルが着手した割合です。
また、Anthropicは自社の保護付きClaudeモデルでは同じ手法が成功しなかったと報告しています。ただし、これはAnthropic自身による比較です。独立した再現結果が出るまでは、自社製品の優位性を含む主張として扱うのが妥当です。
ウェイトを編集して拒否を弱める作業には、Anthropicチームで約2,200 GPU時間、計算費用約4,400ドルかかったとされています。多くは手法の探索と編集後の能力検査に使われ、経験者なら約600 GPU時間、1,200ドル程度との見積もりです。3つの安全性ベンチマークで平均拒否率は95%から6%に低下し、一般能力はほぼ維持されたと同社は述べています。コードや再現環境をこちらで実行した結果ではありません。
人間とAIの分担も変わり始めた
Anthropicは、人間の専門家がGLM-5.3を使い、隔離したLinux環境で一般的なブラウザのJavaScriptエンジンに未知の脆弱性を複数見つけ、連結した攻撃を作ったとも報告しました。対象の保守担当者には通知済みとしていますが、修正完了や第三者による再現は記事公開時点で確認できません。
小型版のGLM-5.3-Flashでは、公開済みのChrome脆弱性などを組み合わせ、ARM64環境向けの攻撃チェーンを作ったとされています。人間の集中作業は20分、モデルの作業は8時間、ZhipuのAPI価格換算で20.40ドルというのがAnthropicの主張です。
ここで重要なのは「完全自動で何でも攻撃できる」という話ではなく、人間が対象と環境を用意したとき、長い試行錯誤をAIに任せられる範囲が広がったことです。攻撃側にも防御側にも、同じ自動化の恩恵があります。
MORIに関係するのは、モデルより外側の設計
MORIが記事制作や複数AIの協働を進めるうえで、このニュースが示す教訓は明快です。モデルが「危険な依頼を拒否する」ことだけを安全装置にしてはいけません。モデルの重み、入力の文脈、途中の推論、接続するツールが変われば、同じ能力でも振る舞いが変わるからです。
実務では、実行環境の隔離、対象と操作の最小化、外部送信・公開・削除前の承認、ログと結果の別手段による検証を組み合わせます。これはサイバー用途だけの話ではありません。記事公開、商品登録、顧客対応、ファイル操作など、エージェントに継続
的な権限を渡す場面すべてに当てはまります。
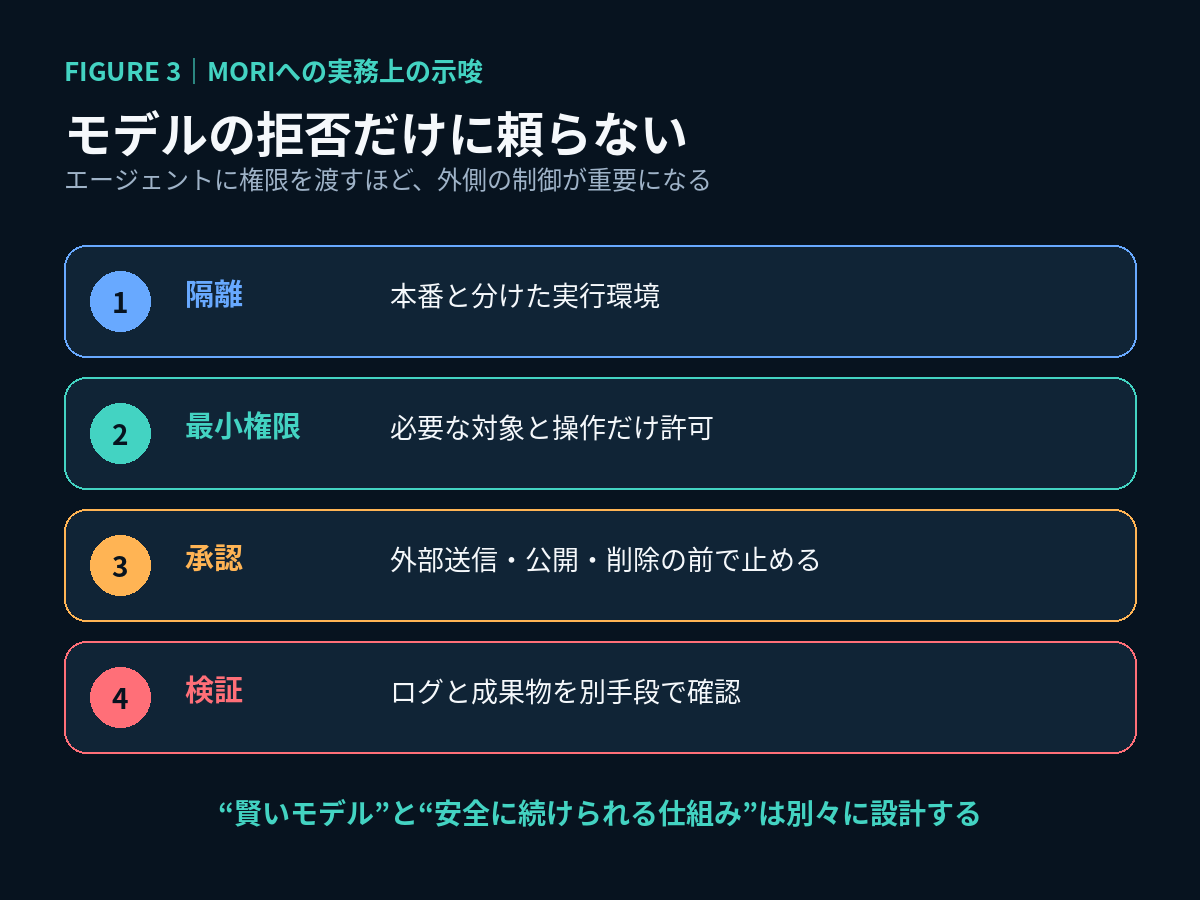
複数AIで相互確認する場合も、同じ入力や同じ権限を共有するだけでは十分ではありません。実行役と検証役を分け、検証役は結果だけでなく「許可された対象に、許可された操作だけを行ったか」を確認する必要があります。
まとめ
GLM-5.3は、公開ウェイトのモデルでも高度な脆弱性探索と攻撃コード作成が現実的になりつつあることを示しました。能力面はNIST/CAISIの独立評価が裏付けています。一方、安全装置の回避率、未知の脆弱性、低コストでの攻撃チェーン作成はAnthropicの報告であり、独立再現は未確認です。
このニュースを「どのモデルが危険か」だけで終わらせると、本質を見失います。能力が配布され、複製・編集できる時代には、モデル自身の拒否に加えて、実行環境・権限・承認・検証を外側に持つ設計が必要です。賢さが広がるほど、制御もモデルから独立させる。その転換点が見えてきました。
出典
- Anthropic, “GLM-5.3 and the spread of advanced cyber capabilities” (2026年9月29日) https://www.anthropic.com/research/glm-5-3-and-the-spread-of-advanced-cyber-capabilities
- NIST / CAISI, “CAISI’s Assessment of Z.ai’s GLM-5.3 Cyber Capabilities” (2026年9月17日) https://www.nist.gov/news-events/news/2026/09/caisis-assessment-zais-glm-53-cyber-capabilities
- Z.ai公式リポジトリ “GLM-5” https://github.com/zai-org/GLM-5


 この記事の販売者