Claude Sonnet 5.5を公式情報で解説|Opus 5.5とほぼ同点で単価は半分。ただし「Max」にすると高くつく
オービット
2026年9月28日、AnthropicがClaudeの新モデル「Claude Sonnet 5.5」を発表しました。
公式の一文は「前のSonnet 5から30%以上速く、ほとんどの仕事で最大30%安い」です。
ただ、読み進めると、見落とすと損をする注意点があります。たとえば、いちばん上の設定「Max」で使うと、第三者の測定では1問あたり7.6ドル。前のSonnet 5の約1.5倍かかっています。
この記事では、Anthropicの発表ページ、公式ドキュメント(日本語版)、第三者の評価機関Artificial Analysisの測定から、Opus 5.5との違い、料金が安くなる使いかた、長い資料の料金差、公式ガイドの「困ったときに足す一文」、新しい安全対策を整理します。
※数字は2026年9月29日時点のものです。料金や仕様は変わることがあります。
※料金の話は、API(使った量で支払う方式)で使う場合のものです。月額プランは、決まった利用枠の中で使います。
先に結論
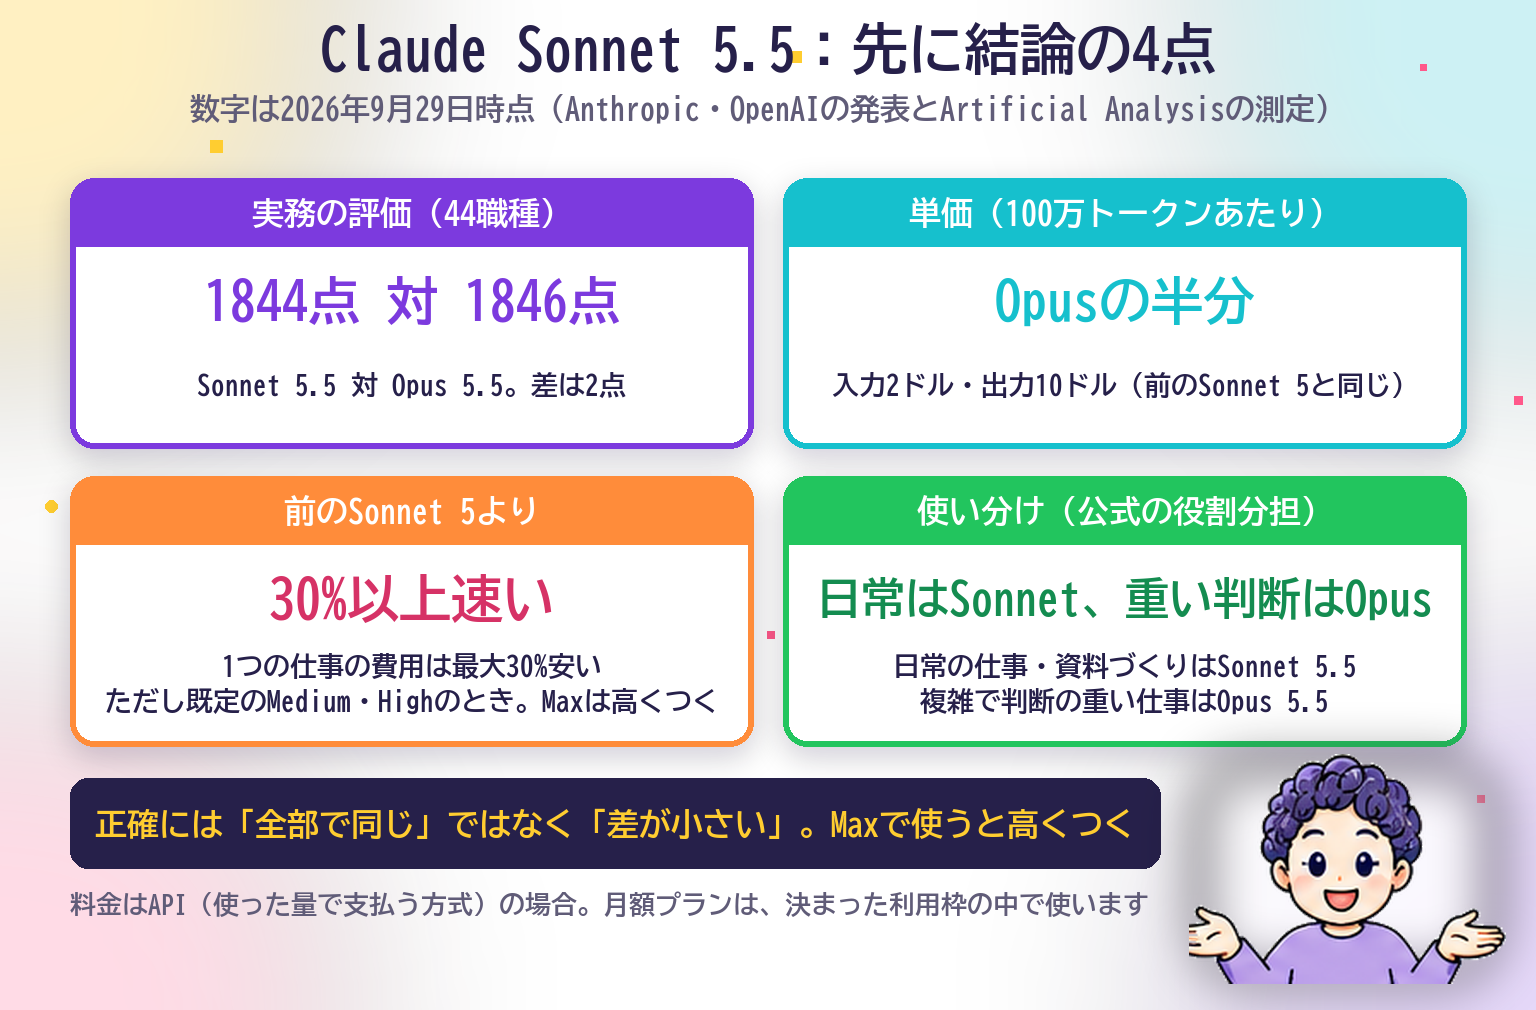
- 44職種の実務を測る評価で、Sonnet 5.5は1844点。上位のOpus 5.5(1846点)と2点差
- 単価はOpus 5.5の半分(100万トークンあたり入力2ドル・出力10ドル)。前のSonnet 5と同じ
- 前のSonnet 5より、出力は30%以上速く、1つの仕事の費用は最大30%安い。ただし安いのは既定のMedium・Highのとき。Maxは高くつく
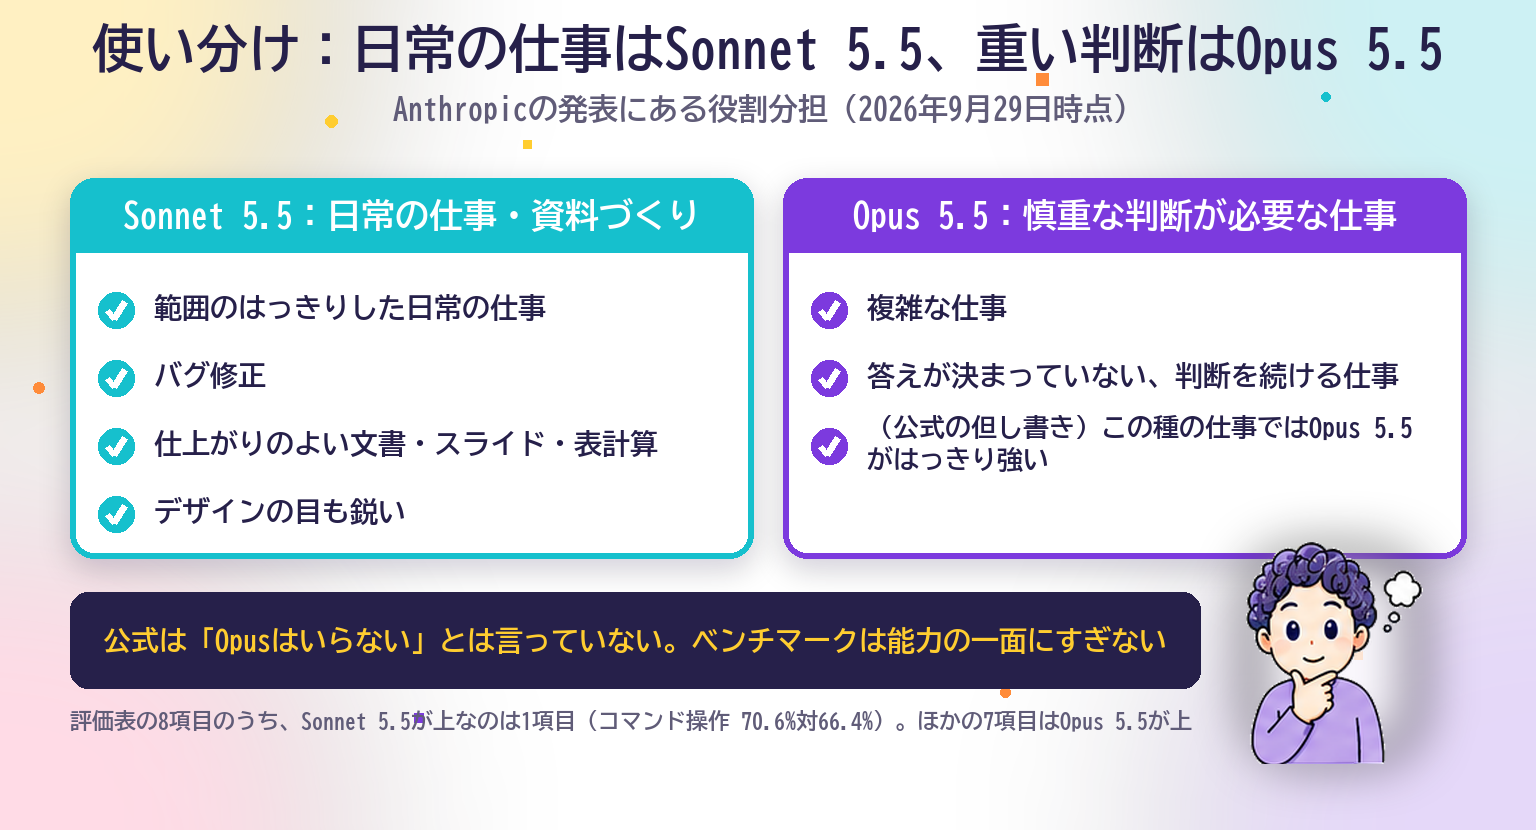
- 使い分けは、日常の仕事と資料づくりはSonnet 5.5、重い判断はOpus 5.5(公式の役割分担)
Sonnet 5.5とは:Claude 5.5ファミリーの2番目
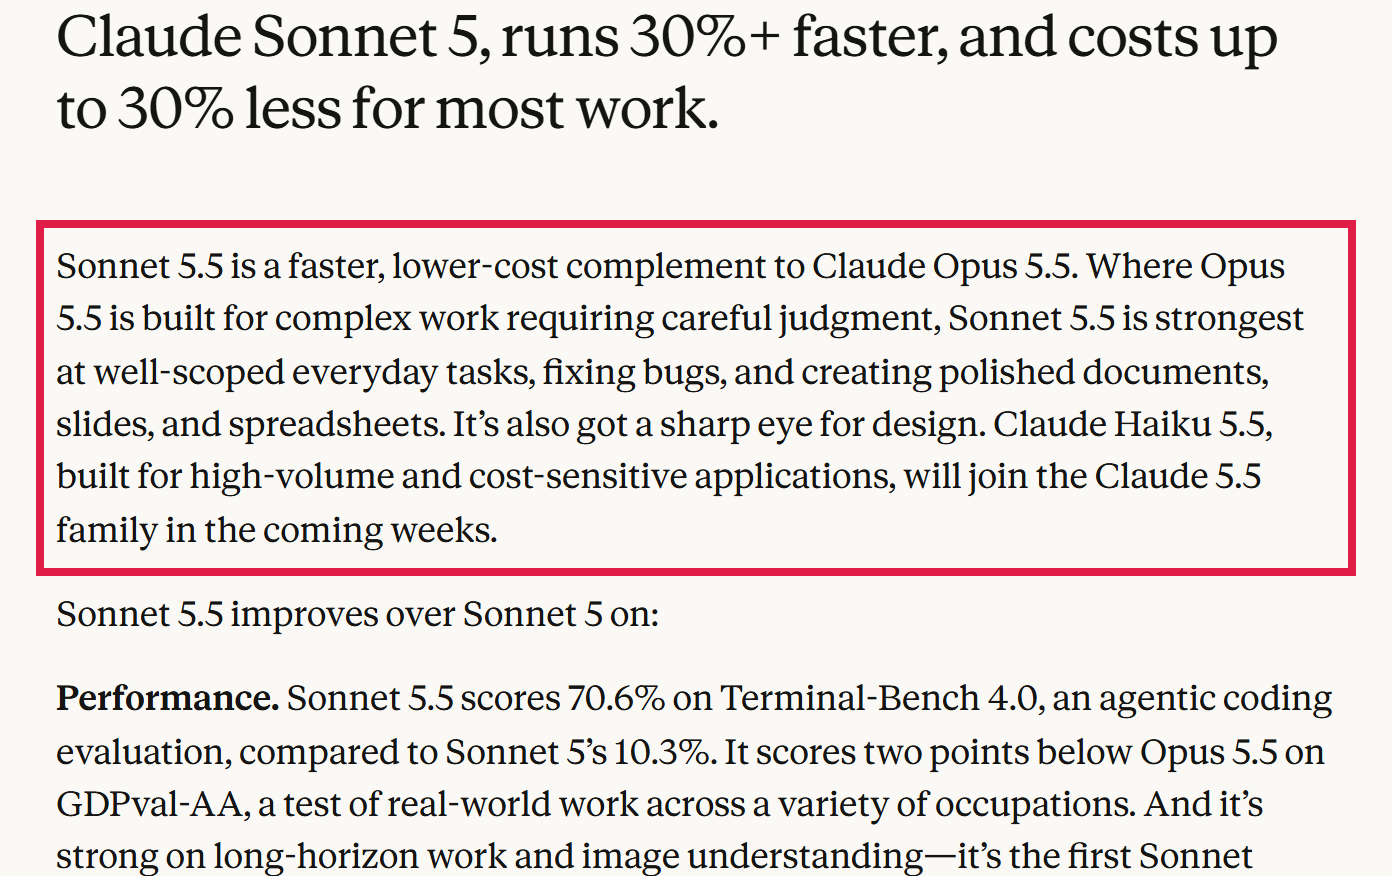
1番目は9月22日に出たOpus 5.5です(Haiku 5.5は「数週間のうちに」)。
公式が書いている役割分担は、はっきりしています。
- Opus 5.5:慎重な判断が必要な、複雑な仕事向け
- Sonnet 5.5:範囲のはっきりした日常の仕事、バグ修正、仕上がりのよい文書・スライド・スプレッドシートがいちばん得意。デザインの目も鋭い
出典:Anthropic「Introducing Claude Sonnet 5.5」(anthropic.com/claude-sonnet-5-5・2026年9月29日撮影)
資料づくりでは、公式の社内テストが紹介されています。上場企業の四半期決算資料と説明会の書き起こし、スライドのひな形を渡して、10枚の事業レビューを依頼。専門家2人が「1回目の下書きをそのまま送れる」と判断したそうです。ただし、これは社内テストの1例です。数字の確認は、今までどおり自分でしてください。
性能:Opus 5.5とほぼ同点、ただし全部ではない
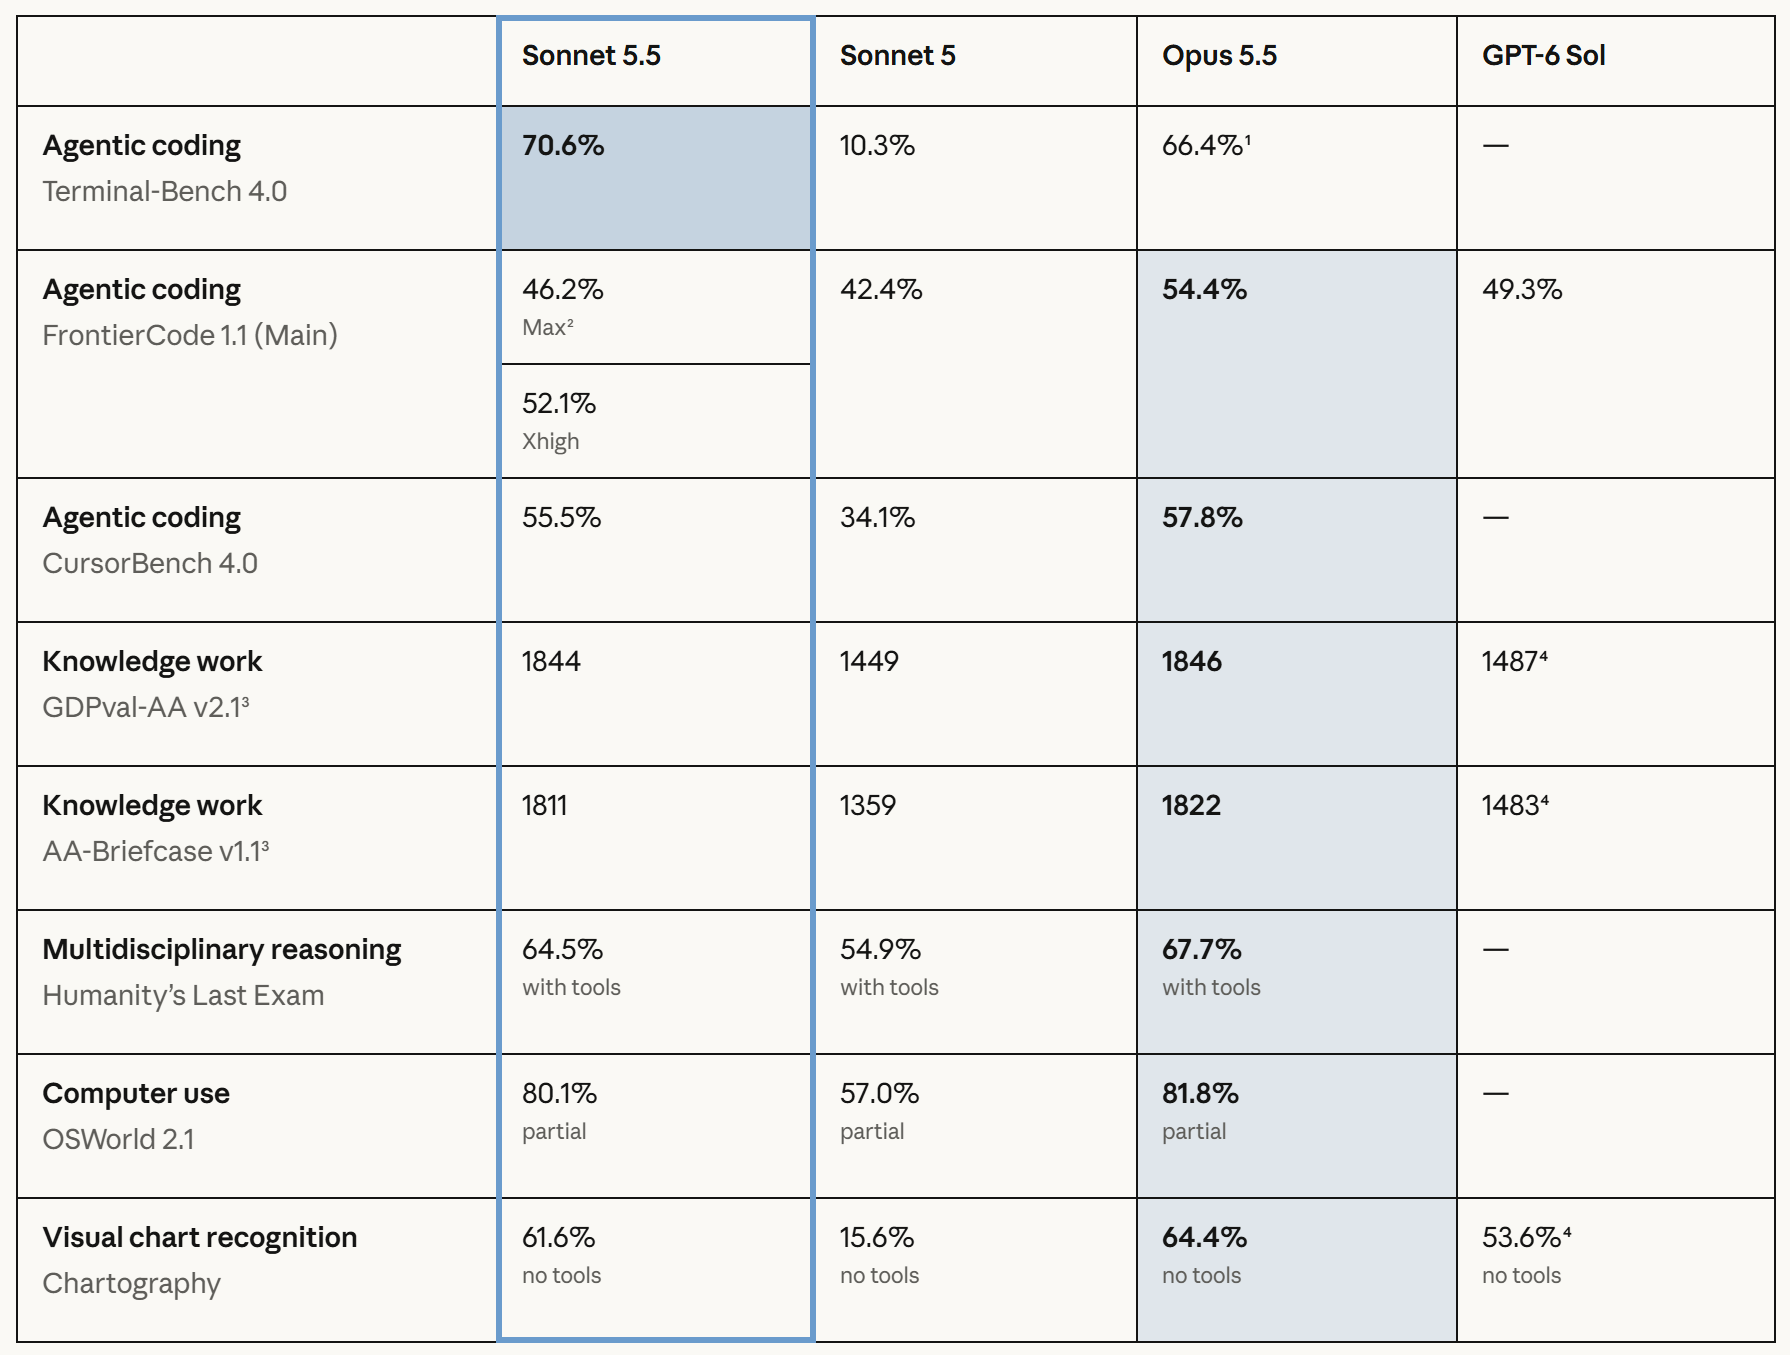
出典:Anthropic「Introducing Claude Sonnet 5.5」の比較表(2026年9月29日撮影・表の部分を切り出し)
公式の比較表から、注目点を3つ拾います。
1. 前のSonnet 5からの伸びが大きい
- コマンドを打って開発を進める評価(Terminal-Bench 4.0):10.3%から70.6%へ
- 44職種の実務の評価(GDPval-AA):1449点から1844点へ。約400点の伸び
- グラフの読み取り:15.6%から61.6%へ。約4倍
2. Opus 5.5との差は、数点
- 44職種の実務:1844点対1846点
- パソコン操作:80.1%対81.8%
公式の比較表の8項目のうち、7項目でOpus 5.5が上です。Sonnet 5.5が上なのは、コマンド操作の評価(70.6%対66.4%)だけ。しかもOpus 5.5の点は、最も高く出た設定(xhigh)での数字です。正確な言いかたは「全部で同じ」ではなく「差が小さい」です。
3. 「Opusはいらない」とは、公式は言っていない
発表ページには、こういう趣旨の但し書きがあります。ベンチマークは能力の一面にすぎない。社内・外部のテストでは、複雑で答えの決まっていない、判断を続ける仕事ではOpus 5.5がはっきり強い、と。私は、この但し書きこそ、使い分けの根拠だと考えています。
第三者の評価と、OpenAIのGPT-6 Sol
Artificial Analysisの総合指標では、Sonnet 5.5(Max)は56点。Opus 5.5(Max)の58点に次ぐ2位で、Sonnet 5から18点上がっています。
同じ単価のOpenAIのGPT-6 Solとは、公式の比較表で両方の数字がある4項目のうち、3項目(44職種の実務・長い知識労働・グラフの読み取り)でSonnet 5.5が上です。コードの評価は設定しだいで、MaxだとGPT-6 Solが上(49.3対46.2)、xhighだとSonnet 5.5が上(52.1)です。
ただし、これは各社発表の数字です。Artificial Analysisは、HighではGPT-6 Solとほぼ同じ費用で、知能はわずかに下、と見ています。自分の仕事で試すのが確実です。
料金:単価はOpusの半分。でも「設定しだい」
APIの料金は、100万トークンあたりで決まります。トークンは、AIが文字を数える単位です。
- Sonnet 5.5:入力2ドル・出力10ドル
- Opus 5.5:入力4ドル・出力20ドル
Opus 5.5のちょうど半分で、前のSonnet 5とも同じ単価です。バッチ処理は半額になります。
では、なぜ「1つの仕事は最大30%安い」のか。単価は同じでも、必要なトークンの量が減るからです。利用企業の例は、次のとおりです。
- Balyasny(資産運用):金融の2,441問で、1回答あたり約12.1万トークン。Sonnet 5は約49.7万でした(約4分の1)
- Base44(アプリ作成):118本で、出来はOpus 5と同水準。やり直しの平均は3.6回(Opus 5は7.7回)。比べた相手はOpus 5.5ではなく、1つ前のOpus 5です
コードの評価では、同じHigh設定どうしで、Sonnet 5より点が10点高く、1問あたりの費用は約15分の1。いくつかの評価では、LowかMediumのSonnet 5.5が、Sonnet 5の最高点を約10分の1の費用で上回る、とも書かれています。
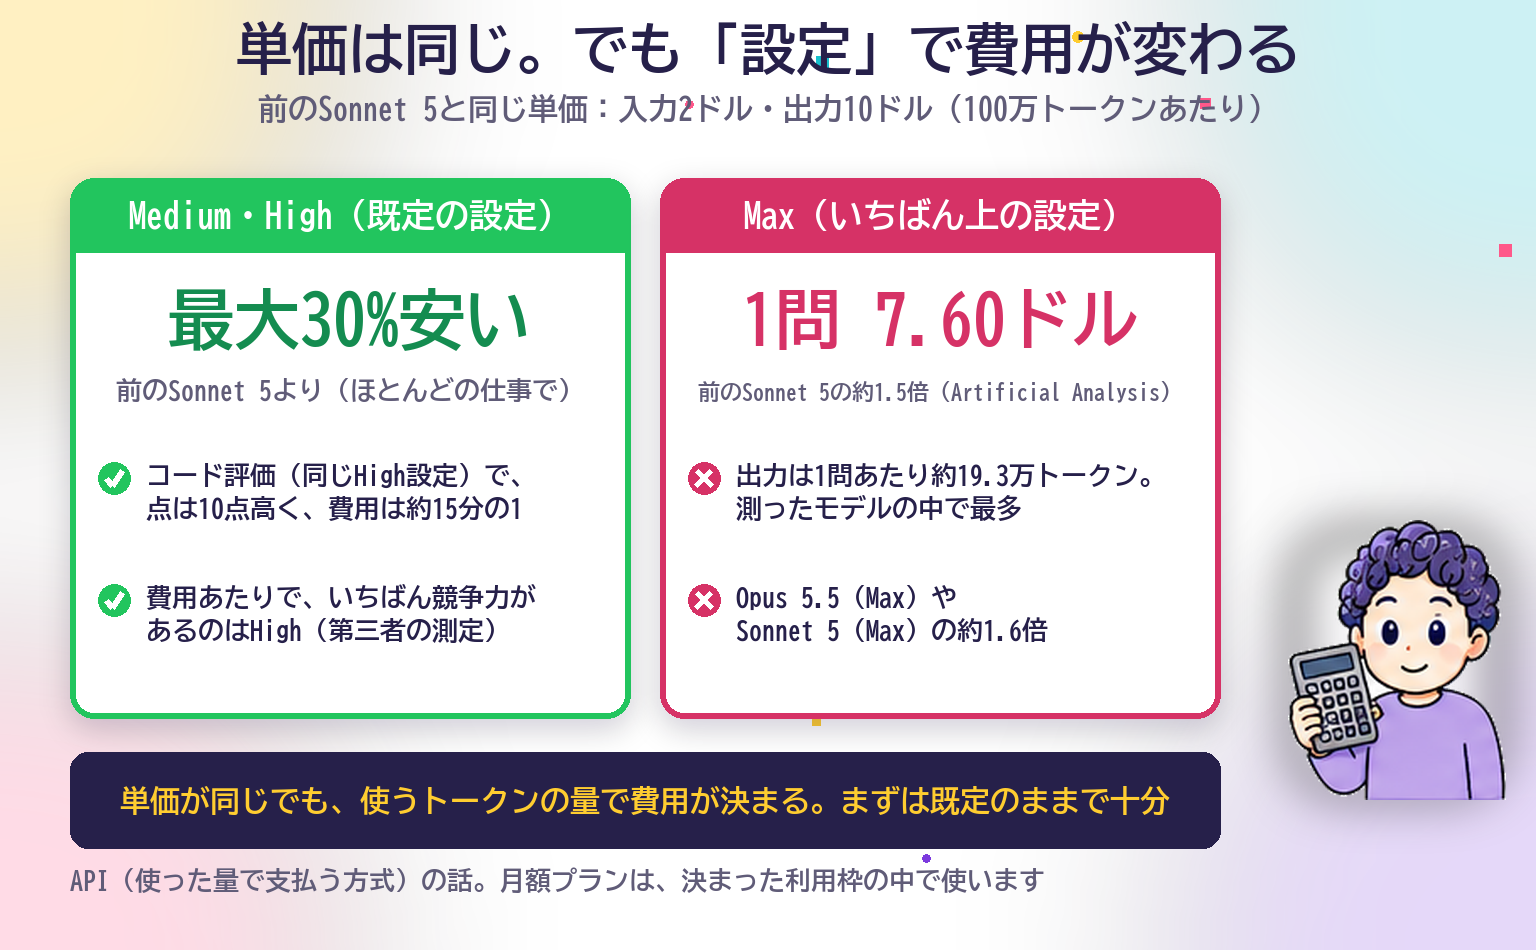
落とし穴:Maxだと1問7.6ドル
ここが、この記事でいちばん伝えたい点です。
Artificial Analysisの測定では、Maxで使ったSonnet 5.5は1問あたり7.60ドル。Sonnet 5の約1.5倍です。単価は同じでも、出力が多いためです。Maxの出力は1問あたり約19.3万トークンで、同社が測ったモデルの中で最多。Opus 5.5(Max)やSonnet 5(Max)の約1.6倍です。
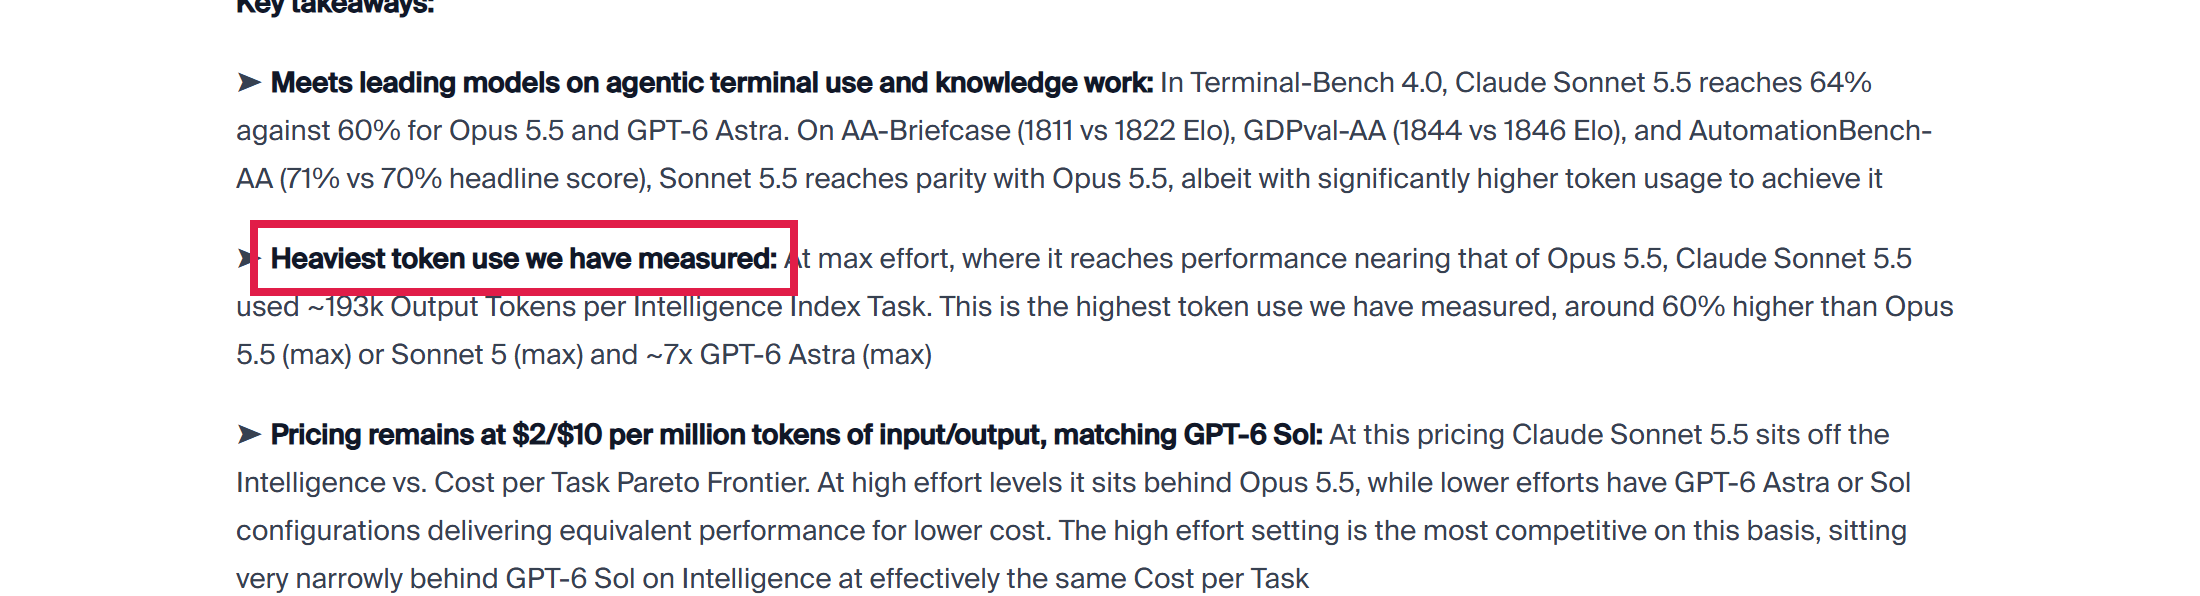
出典:Artificial Analysis「Claude Sonnet 5.5」の記事(artificialanalysis.ai/articles/claude-sonnet-5-5・2026年9月29日撮影)
公式の「最大30%安い」は「ほとんどの仕事で」という条件つきです。安くなるのは、MediumやHighの既定の設定で使ったとき。Artificial Analysisも、費用あたりではHighがいちばん競争力がある、としています。
エフォート(答える前に考える量の設定)の既定は、Claudeのアプリ・Claude CodeがMedium、Claude Platform(API)がHighです。まずは既定のままで十分、というのが、公式の情報から読み取れる結論です。
長い資料を読ませるなら:100万トークンまで同じ単価
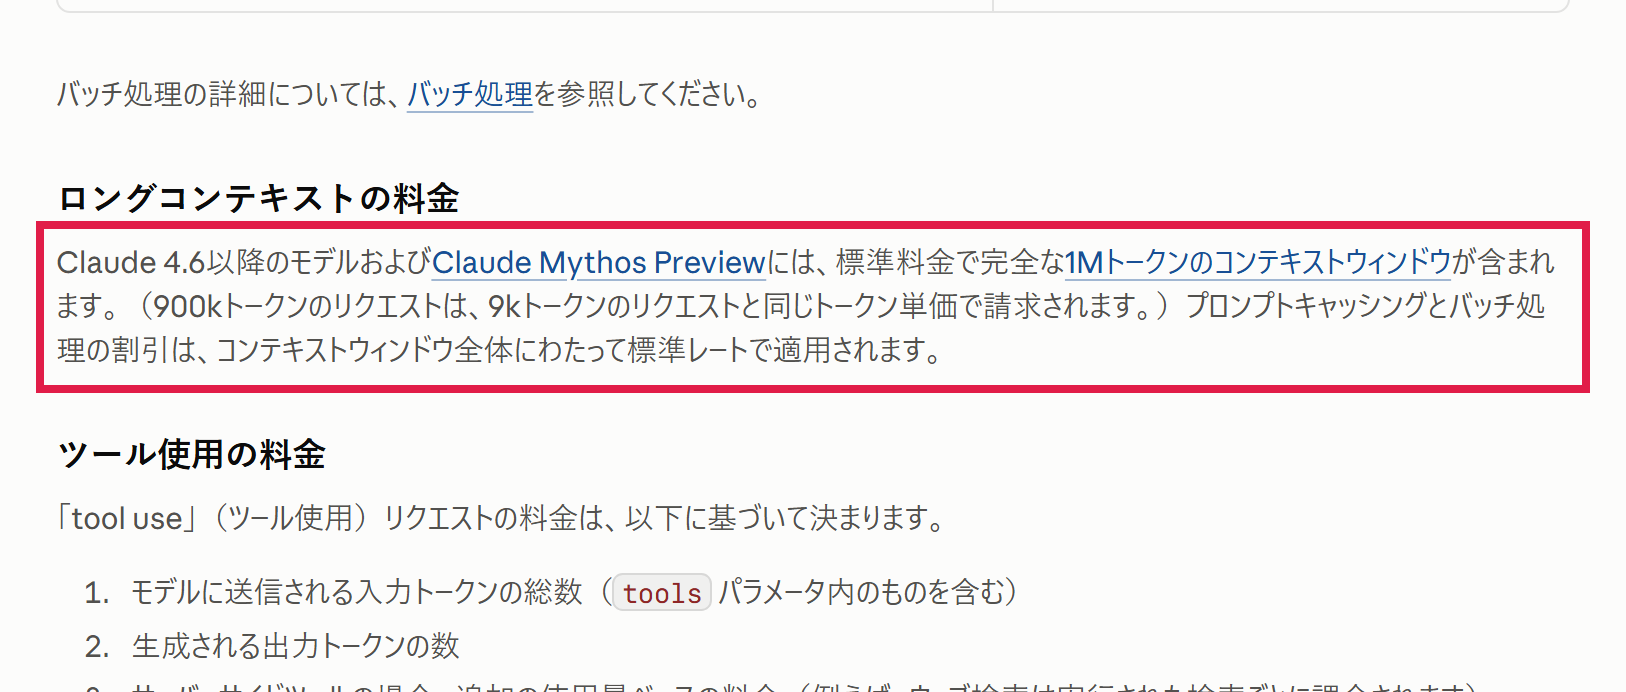
Claudeは、公式の料金ページ(日本語版)に、標準料金で完全な1Mトークンのコンテキストウィンドウが含まれると書かれています。90万トークンのリクエストも、9千トークンのリクエストと同じ単価です。
出典:Claude Platform Docs「料金」日本語版(platform.claude.com/docs/ja/about-claude/pricing・2026年9月29日撮影)
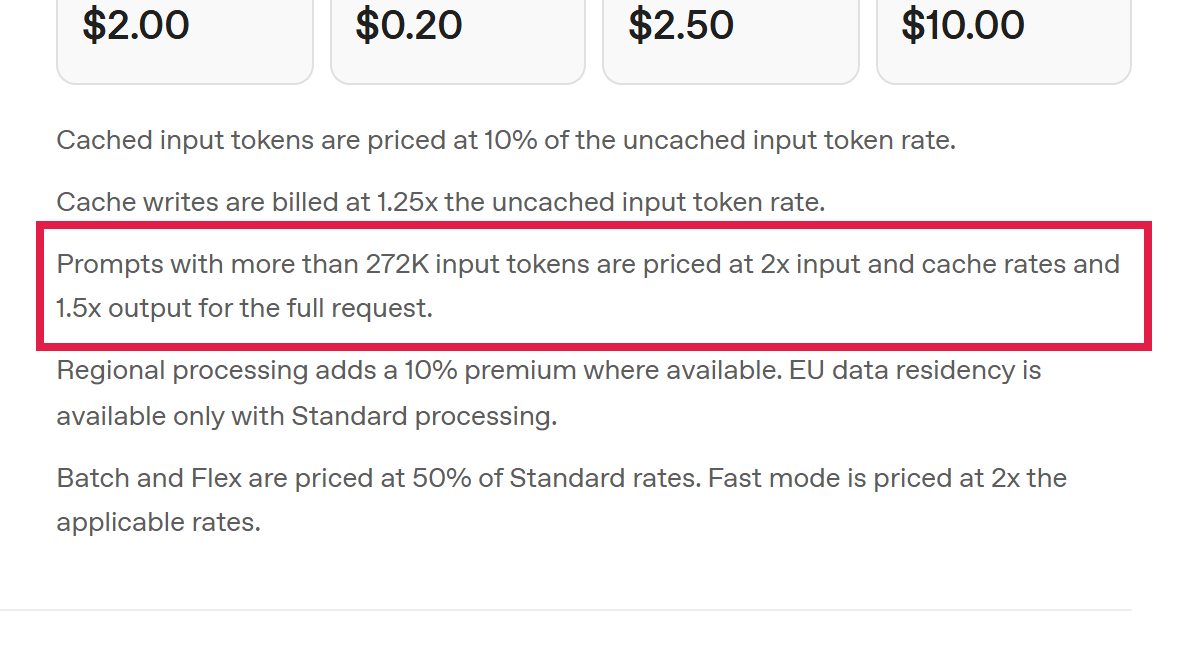
一方、GPT-6 Solは、単価は同じ(入力2ドル・出力10ドル)ですが、入力が27.2万トークンを超えると、そのリクエスト全体が入力2倍・出力1.5倍になります。
出典:OpenAI「GPT-6 Sol」モデルページ(developers.openai.com/api/docs/models/gpt-6-sol・2026年9月29日撮影)
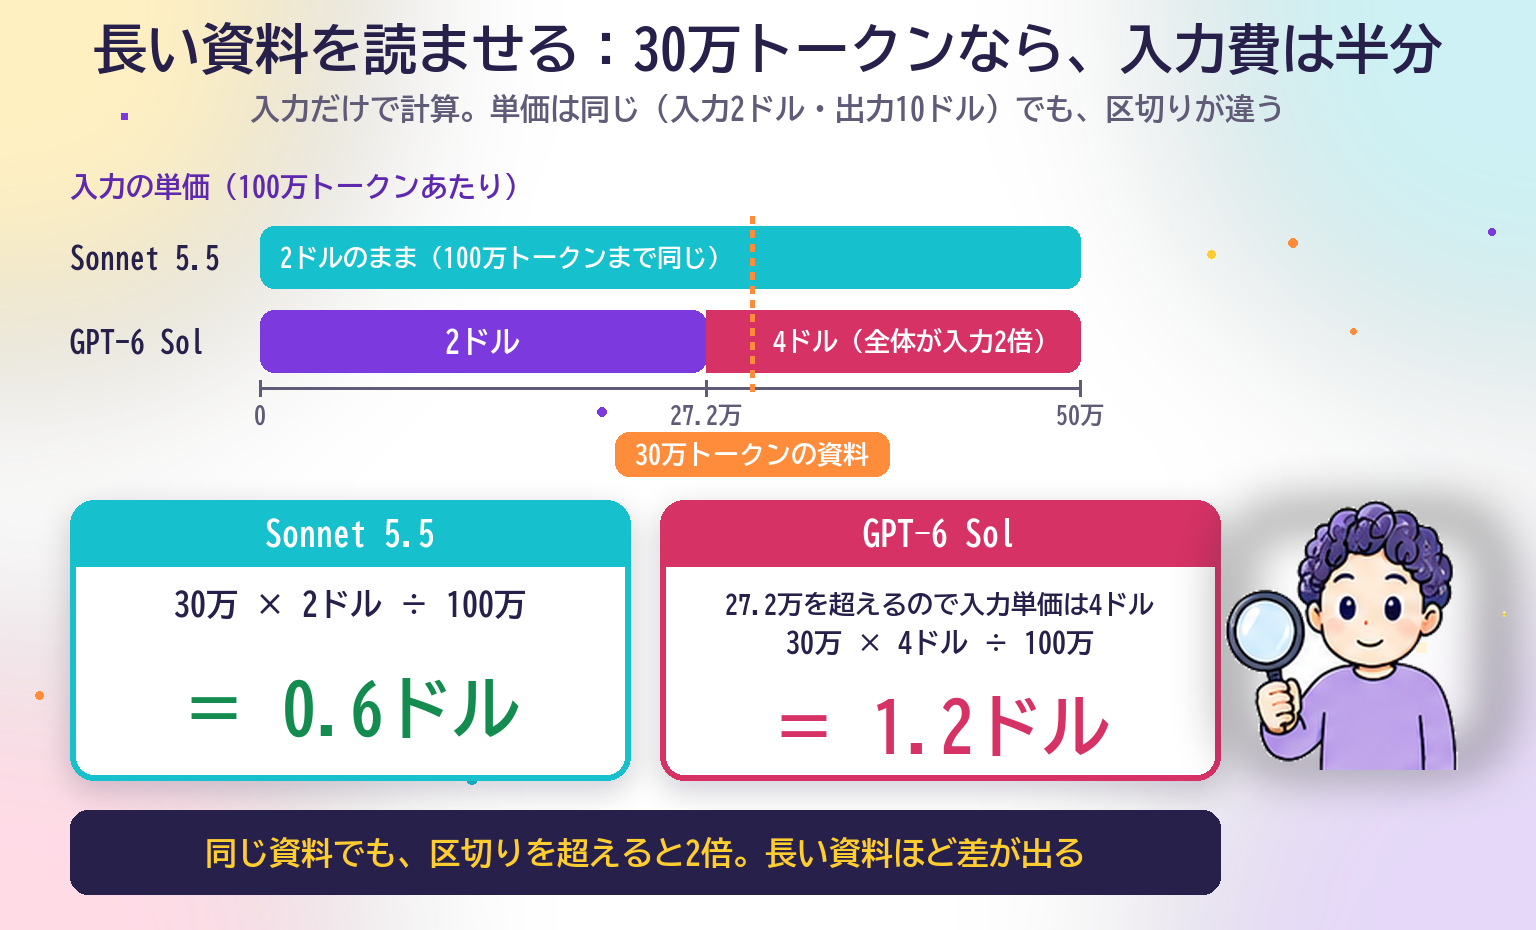
30万トークンの資料を1回読ませる場合を、入力だけで計算します。
- Sonnet 5.5:30万 × 2ドル ÷ 100万 = 0.6ドル
- GPT-6 Sol:27.2万を超えるので入力単価は4ドル。30万 × 4ドル ÷ 100万 = 1.2ドル
エフォートの選びかた:前の設定をそのまま持ちこまない
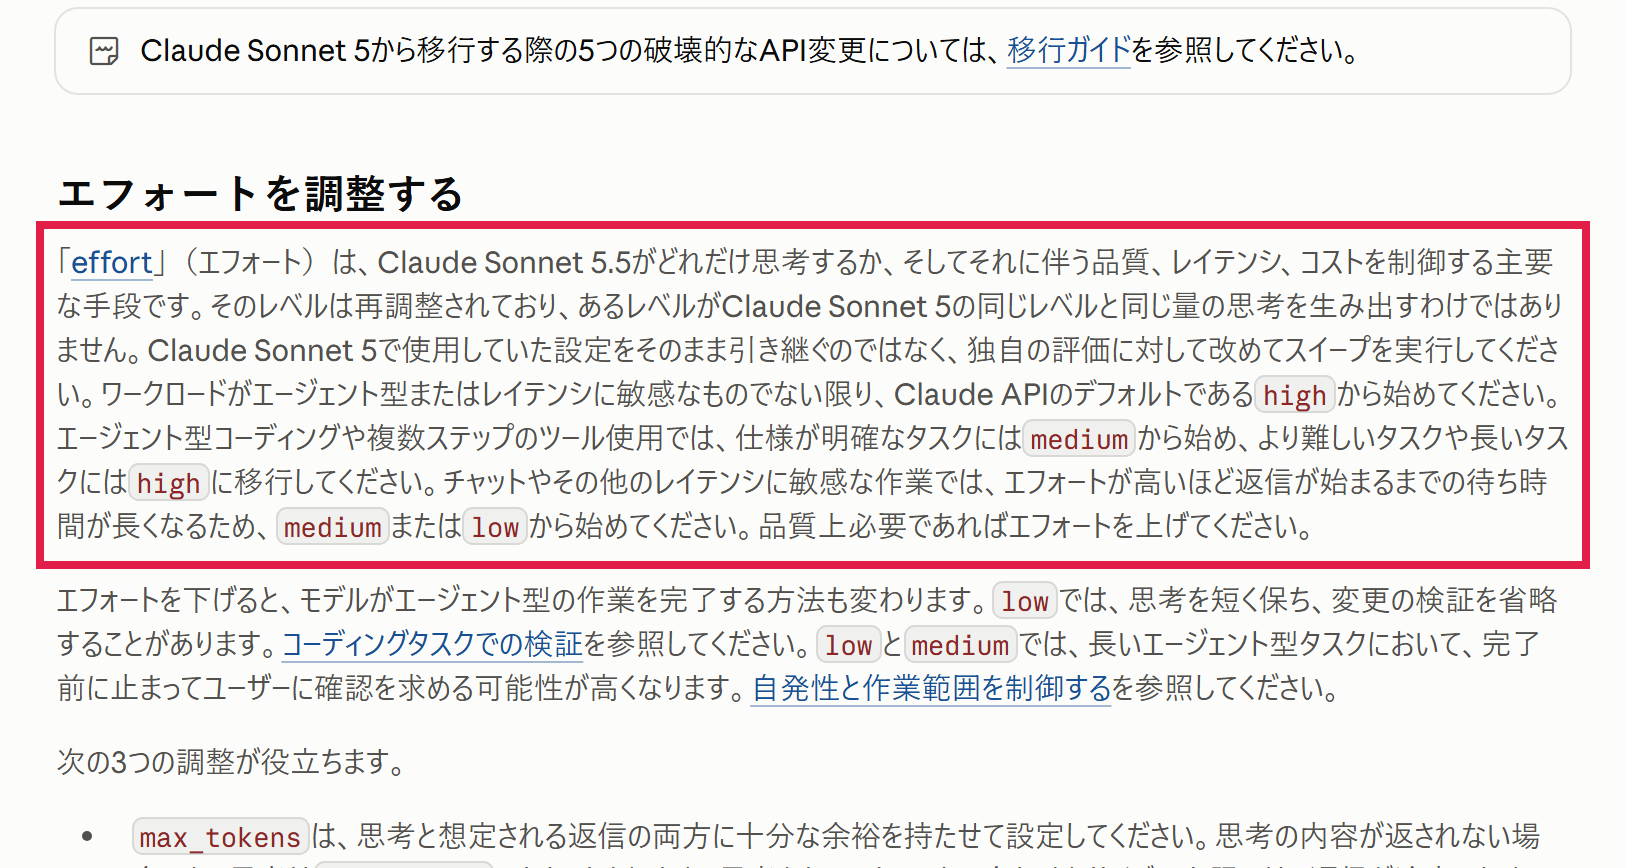
エフォートは5段階(low・medium・high・xhigh・max)です。公式の日本語ガイドが、いちばん大事な注意として挙げているのは、段階が測り直されていること。同じmediumでも、Sonnet 5と同じ思考量とは限りません。前の設定を持ちこまず、自分の仕事で試し直してください、という内容です。
始める目安は、次のとおりです。
- ふつうの仕事:Highから
- 手順がはっきりした開発:Mediumから。難しい・長い仕事ならHigh
- 待ち時間が気になるチャットなど:MediumかLow
- xhighとmax:品質が上がると測って確かめた仕事だけ
設定を下げると、長い作業の途中で止まって確認を求めやすくなり(low・medium)、テストなどの確認を省くことがあります(low)。上げると、終わったあとに自分でレビューを始め、時間とトークンが増えます(xhigh・max)。
出典:Claude Platform Docs「Claude Sonnet 5.5へのプロンプト」日本語版(2026年9月29日撮影)
公式ガイドの「11の困りごと」から、ふだん使う人に効く4つの一文
公式のプロンプトガイド(日本語版・platform.claude.com/docs/ja/build-with-claude/prompt-engineering/prompting-claude-sonnet-5-5)は、冒頭に、Sonnet 5.5でよく起きる困りごとを11個並べています。ここでは、そのうち4つを選びます。なお、公式は「Sonnet 5のプロンプトは、変更しなくても良好に機能するはず」とも書いています。困ったときだけ、必要な一文を足す使いかたで大丈夫です。
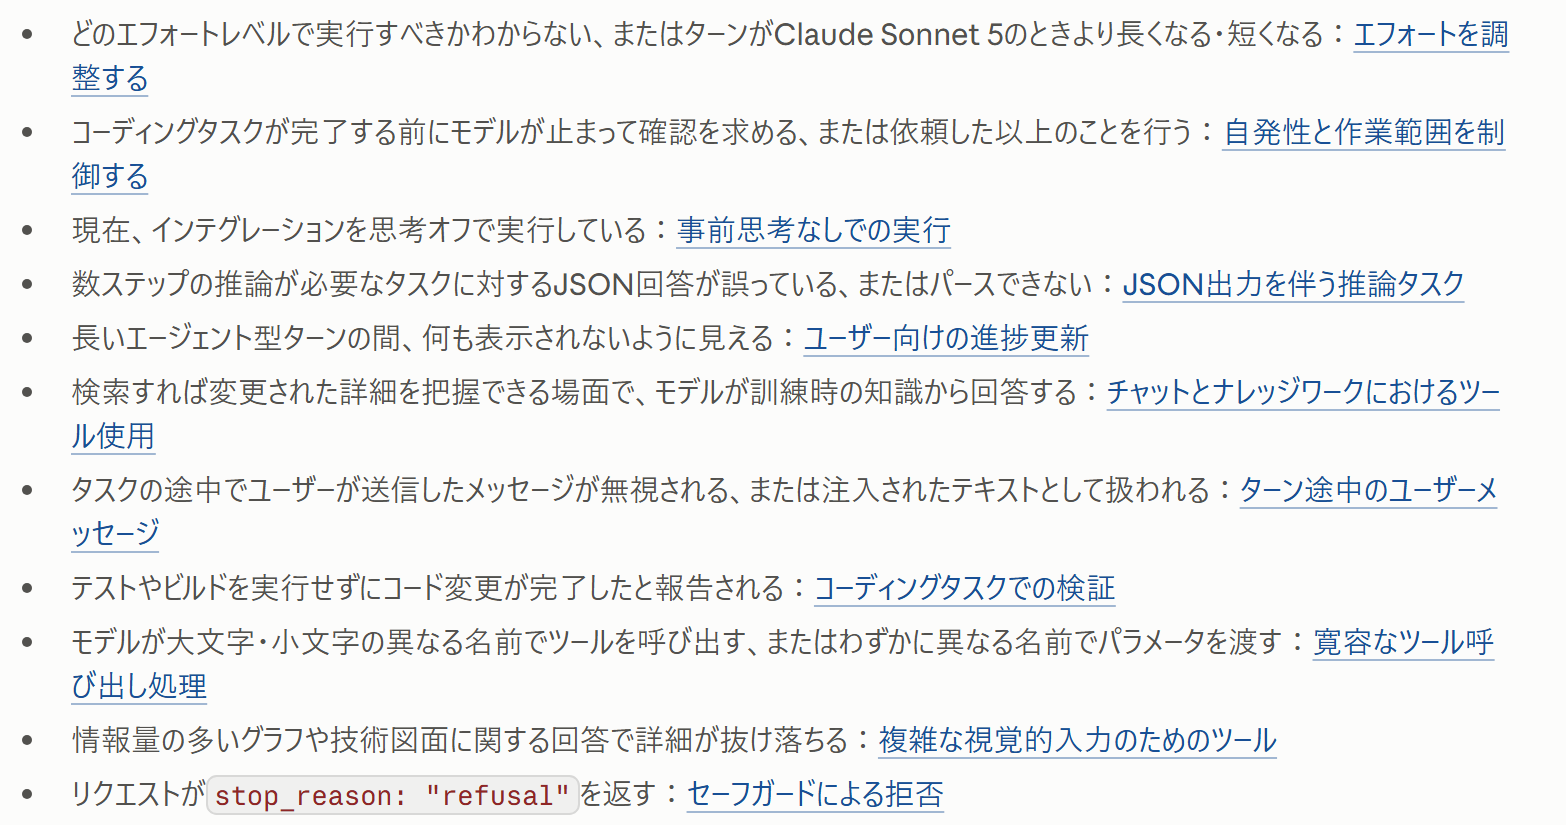
出典:Claude Platform Docs「Claude Sonnet 5.5へのプロンプト」日本語版の冒頭の一覧(2026年9月29日撮影)
以下の対策文は、公式の英語の一文の要約です。正確な英文は、公式ガイドで確認してください。
1. 途中で止まる → 最後までやらせる
lowやmediumの長い作業では、途中で「続けますか」と確認を求めることがあります。公式は、まずエフォートを上げてみることを勧め、それ以外の方法として、次の趣旨の文を足すことを挙げています。
- 頼まれたことが全部終わるまで続けて。止まって聞くのは、ユーザーがいないと進めないときと、危険な手順の前だけにして
注意点もあります。これを足すと、より多くの作業を最後までやるので、セッションは長くなり、費用も増えます。危険な操作・元に戻せない操作についての、自分のルールの代わりにもなりません。
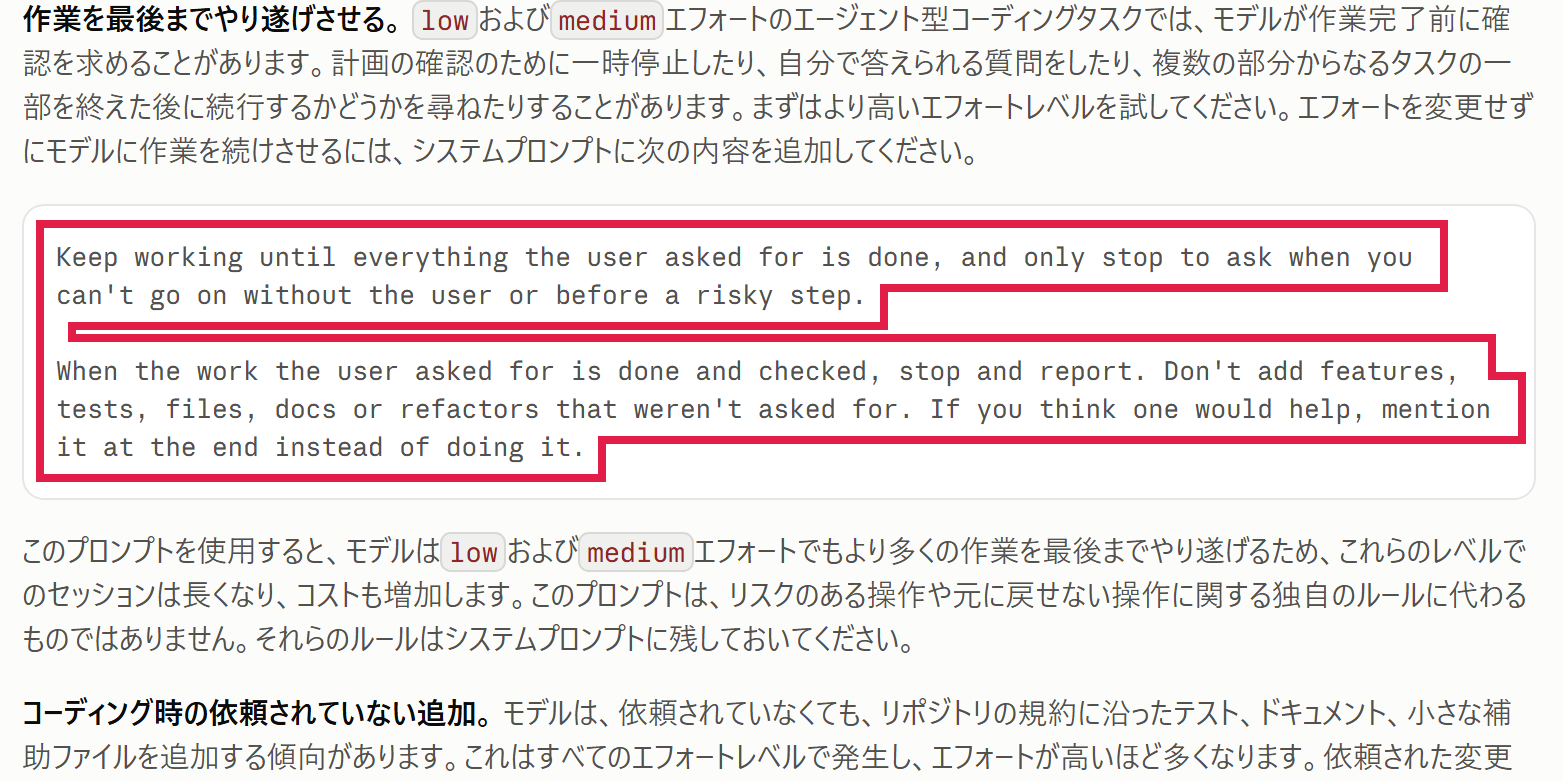
出典:Claude Platform Docs「Claude Sonnet 5.5へのプロンプト」日本語版(2026年9月29日撮影)── 自発性と作業範囲を制御する
2. 頼んでいないものまで足す → 頼んだことだけ
頼んでいないテストや文書、補助ファイルを足す傾向は、すべてのエフォートで出ます(高いほど多い)。足されたくないときは、次の趣旨の文を足します。
- 頼まれた作業が終わって確認したら、止まって報告して。頼まれていない機能・テスト・ファイル・文書・リファクタは足さず、役立ちそうなら、やらずに最後に一言で教えて
似た話で、「これで何ができるか見せて」と頼むと、案だけほしいのに資料や動画を作り始めることがあります。そのときは「案や計画を求められたら、それを出して止まる。進めてと言われるまで作らない」という趣旨の一文を足します。
3. 古い知識で答える → 検索で確かめさせる
検索すれば分かる細かい点を、覚えている知識で答えることがあります。何が許されるか、何が必要か、いくらかかるか、といった話です。検索ツールを使える環境では、次の趣旨の文を足します。
- 許可・必要なもの・料金など、訓練のあとに変わったかもしれない細かい点は、自信があっても検索で確かめて。レポートや比較は、最新の情報源を集めて書いて
あわせて、プロンプトに「ツールは厳密に必要なときだけ使う」のような抑える文があれば、消してください。検索しなくなる原因になります。
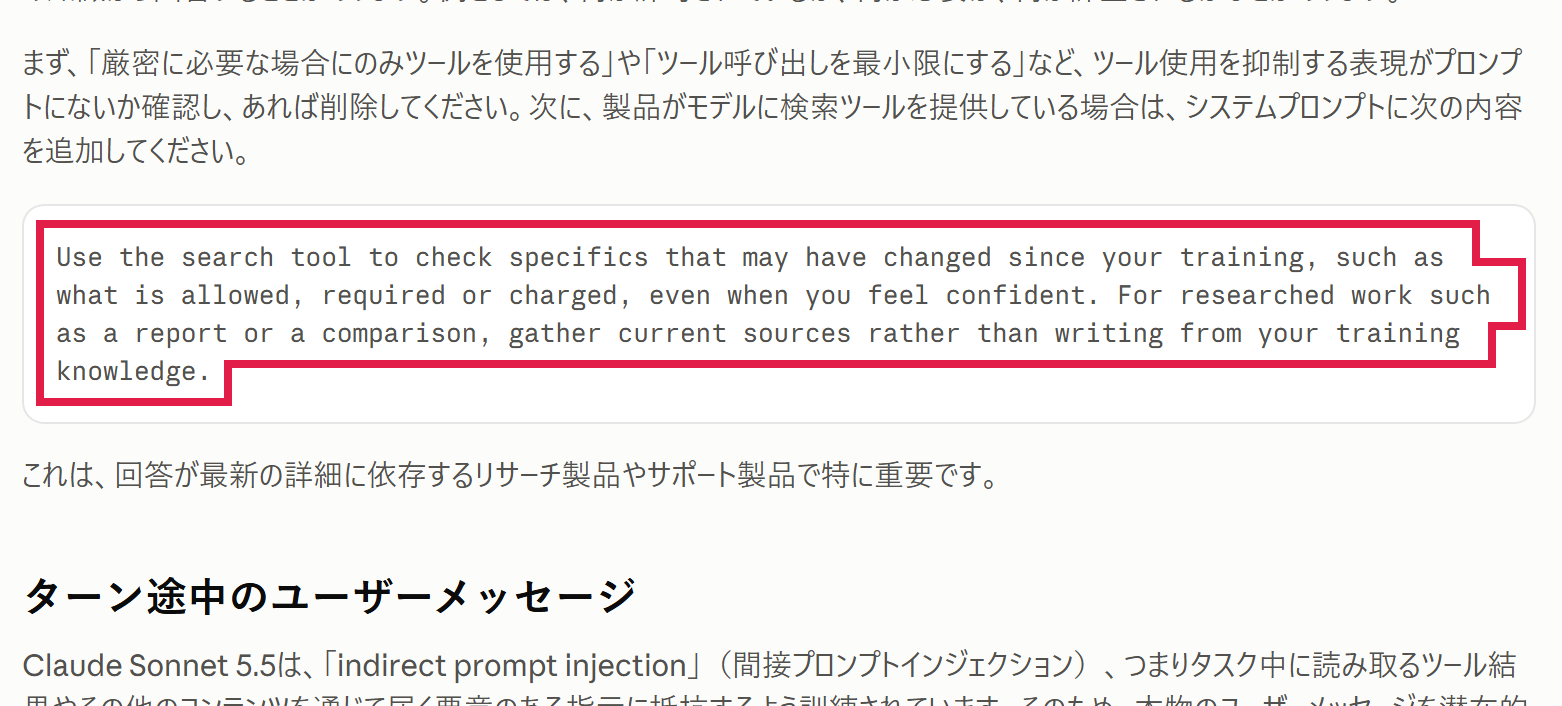
出典:Claude Platform Docs「Claude Sonnet 5.5へのプロンプト」日本語版(2026年9月29日撮影)── チャットとナレッジワークにおけるツール使用
4. テストせずに「完了」と言う → テストしてから完了
lowでは、変更が動くかの確認をしないまま「完了しました」と報告することがあります。対策は、動かせるコードを変えたら、本物のチェック(テスト・型チェック・ビルド)を実行してから完了と言わせること。動かせない場合は、どのチェックをなぜ実行しなかったかを言わせます。
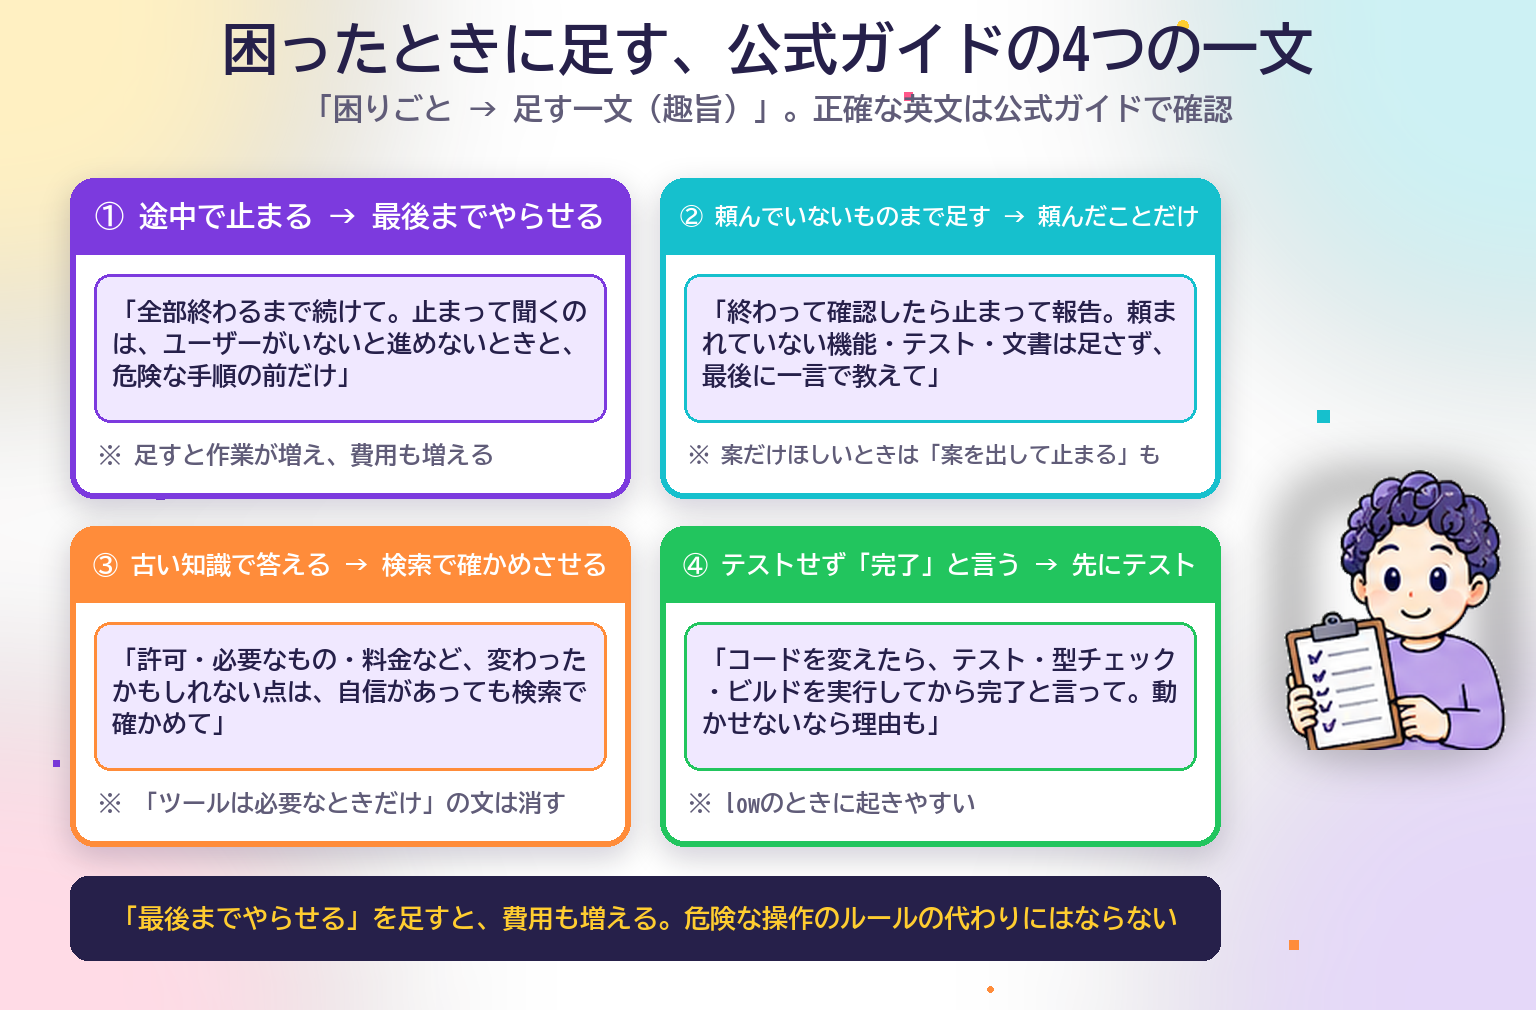
おまけ:max・xhighの「念入りすぎ」を止める一文
xhigh・maxで自主レビューが増えるときは、次の趣旨の一文が効きます。
- 頼んだ作業が終わってチェックが通ったら、止まって報告して。追加のレビューを勝手に始めず、レビュー役の分身も立ち上げないで
公式のテスト(maxでのコーディング)では、品質を変えずにセッション費用が約3分の1減りました。
開発者向け:変わる点とJSON出力のコツ
ここは、APIで組みこんでいる方向けです。使うだけの方は、読み飛ばして大丈夫です。
公式の「新機能」ページによると、Sonnet 5から移行するときの破壊的変更は5つです。
- 思考オフは「disabled」ではなく「between_tools」に。high以下のみで、xhighとmaxは400エラー
- ツールの強制(tool_choiceのany・tool)は400エラー。autoとstrictの組み合わせに
- 思考ブロックはモデルと会話に結びつく。履歴の書きかえは400エラーになることがあるので、追記だけに
- 旧computer useツール(computer_20251124)は使えない
- advisorツールとの組み合わせに制限がある
JSONの答えが誤るとき
数ステップの推論が必要な仕事(数値の合計、ルールの当てはめ、ランク付けなど)でJSON形式の答えを求めると、特にlowとmediumで、事前に考えずに答えて誤ることがあります。構造化出力では、返事がJSONだけになり、考える場所が「思考」の中しかないからです。公式のおすすめは、システムプロンプトの末尾に、この一行を足すことです。
Think the problem through before you answer.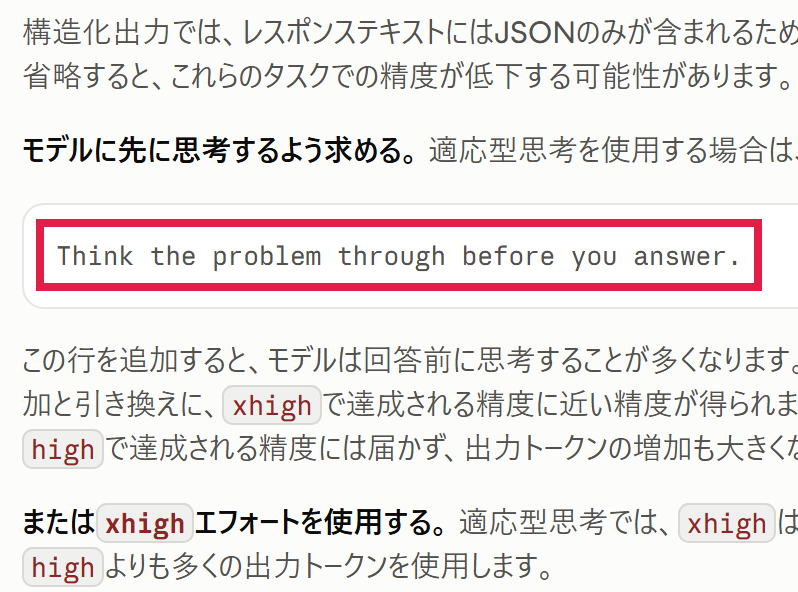
出典:Claude Platform Docs「Claude Sonnet 5.5へのプロンプト」日本語版(2026年9月29日撮影)── JSON出力を伴う推論タスク
- highの場合:出力トークンが適度に増える代わりに、xhighに近い精度になる
- lowとmediumの場合:精度は上がるが、highには届かず、出力の増加も大きい
- xhighなら、この一行がなくても最高の精度が出る(出力はhighより増える)
- between_toolsではツールなしのリクエストで事前に考えないので、この一行は効かない。適応型思考を使う
構造化出力を使えず、プロンプトでJSONを頼むときは、返事の最後のJSON値をパースします。最初の { から最後の } まで丸ごと取ると、下書きまで含むことがあります。stop_reasonがmax_tokensの返事は、JSONが入っていても失敗として扱い、やり直します。
もうひとつ。「考えたことを返事に全部書いて」と頼むと、reasoning_extractionとして断られます。適応型思考なら、要約された思考ブロックから読みます。
安全:Sonnetとして初めての、2つの対策
1. サイバー対策
Sonnet 5.5のサイバー能力は、上位のOpus 5と同じくらいになりました。そこで、Sonnetとして初めて、上位モデルと同じ種類の安全装置と切り替えの仕組みが付きました。
ふだんのバグの発見・修正はそのままです。高リスクなサイバー作業は、目に見える形でSonnet 5に切り替わります(Artificial Analysisによると約0.1%のタスク)。
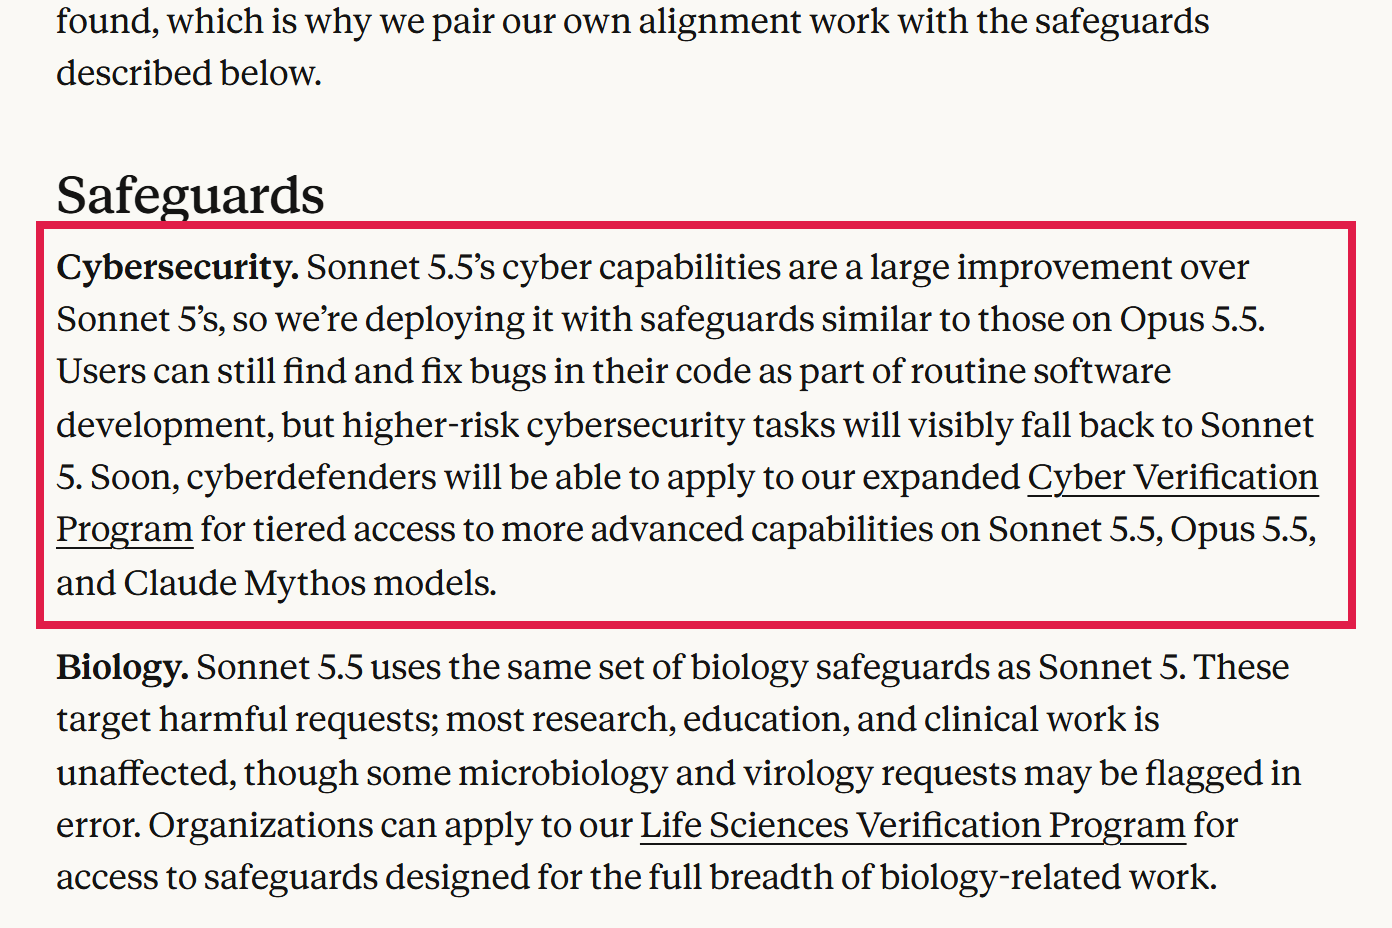
出典:Anthropic「Introducing Claude Sonnet 5.5」Safeguards(2026年9月29日撮影)
2. 思考の抜き取り(蒸留)対策
蒸留は、何千もの偽アカウントで、モデルの能力を工業的な規模で抜き取る攻撃です。抜き取った答えで別のAIを育てると、Claudeの安全装置を持たない、強いAIができてしまいます。
そこで、Sonnetとして初めて、思考の抜き取りを防ぐ安全分類器を付けて公開しました。思考は、それを作ったアカウントから切り離せなくなり、別のアカウントから送った思考ブロックは、エラーにはならず捨てられます。ほとんどの開発者は変化に気づきませんが、Claude Codeの途中でアカウントを切り替える場合などは、公式の説明を一度確認してください。
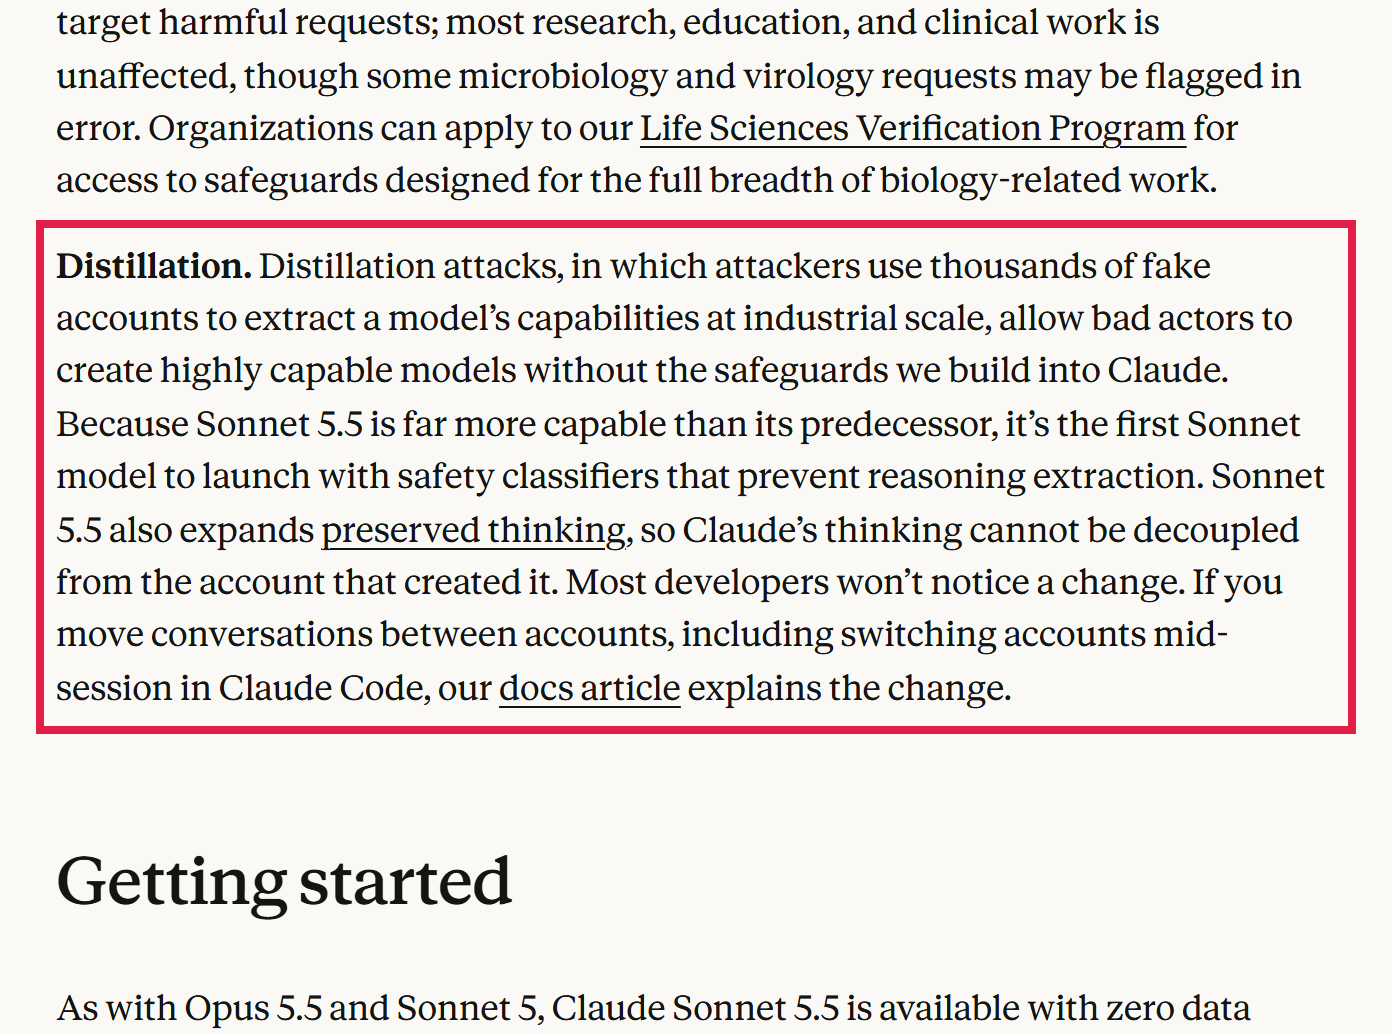
出典:Anthropic「Introducing Claude Sonnet 5.5」Safeguards の Distillation(2026年9月29日撮影)
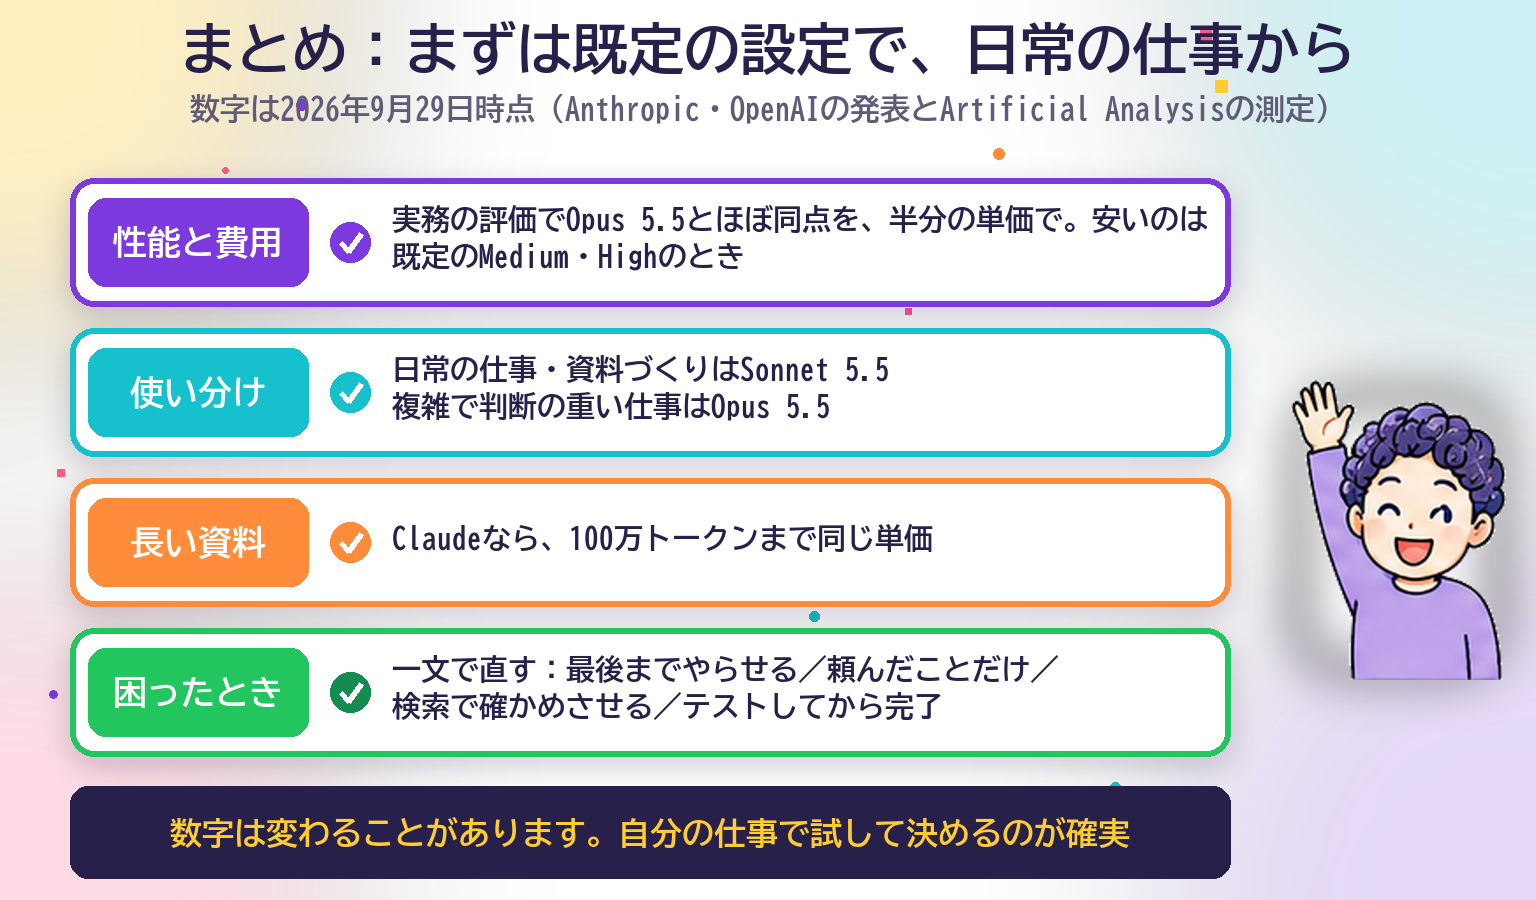
まとめ:まずは既定の設定で、日常の仕事から
- 実務の評価でOpus 5.5とほぼ同点を、半分の単価で。安いのは既定のMedium・Highのとき
- 日常の仕事・資料づくりはSonnet 5.5、複雑で判断の重い仕事はOpus 5.5
- 長い資料は、Claudeなら100万トークンまで同じ単価
- 困ったら一文で直す:最後までやらせる/頼んだことだけ/検索で確かめさせる/テストしてから完了
私は、まずは既定の設定のまま使ってみるのが安全だと考えています。
画面つきで見たい方へ
この記事と同じ内容を、公式ページの画面を見ながら解説した動画も作りました。映像で追いたい方は、こちらもどうぞ。

ちなみに、このチャンネルの動画は、台本と映像をClaude Codeで作っています。
注意
- 数字は2026年9月29日時点の、Anthropic・OpenAIの発表と、Artificial Analysisの測定です。料金や仕様は変わることがあります
- この記事は一般的な情報の解説です。導入の判断は、ご自身の環境と目的に合わせて行ってください
 この記事の販売者