【重複購入のご注意】この記事は「AI開発者の手帖」がnoteで販売している同名記事(使っているモデルが静かに劣化していないかを自分で確かめる:固定の評価を毎日回す前に決める5つのこと)と同じ内容です。すでにnoteで購入・閲覧できる方は重複購入にご注意ください。
Claude や GPT を API や Claude Code から仕事に使っていて、「最近モデルの出来が落ちた気がする」と感じたことがある方に向けて書きます。気のせいかどうかを、答えを機械で採点できる自分の問題を使い、感覚ではなく数字で確かめる手順です。
きっかけは、Claude Opus 5.5 を公開直後から30日間の予定で、毎日同じ問題で測っている第三者のプロジェクト livenerf です。README は「not affiliated with Anthropic」の独立したプロジェクトだと明記しており、以下の数値はすべて提供元の主張です。README(2026-09-30時点。30日のうち7日分を集めた段階で、最初の10日の基準の窓もまだ途中)には、次のことが書かれています。
- 2,336問を4回ずつ解かせ、4回中1〜3回正解し、分類器のイベントが無かった78問で、1日1回まわしている(選別条件は設計文書)
- そのやり方で検出できるのは、10日ごとの窓で「about 7.5 points」の正答率の変化まで
- effort を下げて試すと、正答率よりも出力トークン数に強く出た。effort low では出力トークン −62%・正答率 −8.3 ± 4.5ポイント、medium では −26%・−4.2 ± 3.9ポイント
- 同じ系統の旧モデル(Opus 5)に差し替えても、事前検証の標本数では99%の基準で区別できなかった(−3.8 ± 6.3ポイント、トークン −23%)。10日の窓(標本は約2.5倍)で足りるかは、まだ示されていない
筆者はこの README と設計文書、統計の出どころである Anthropic の研究ページと論文(Evan Miller 著の Adding Error Bars to Evals)、Claude Code の公式ドキュメントを照合し、「何ポイントの低下まで検出できるか」を計算する小さなスクリプトを書いて検算しました。公式・提供元の記述と、筆者の計算や判断は分けて書きます。
対象外:文章の出来のように、答えを機械で正誤判定できない用途です。livenerf は採点に LLM を使わない理由を「the judge would drift too」と書いており、本稿も完全一致で採点できる問題だけを扱います。また、呼び出しを固定する具体的な確かめ方は API と Claude Code について書きます。Codex CLI など別の道具の具体的なフラグは扱いません。
参考になったら、記事下部のライクとXの共有ボタンから応援してもらえるとうれしいです。
毎日回す前に決める5つのこと
livenerf の設計と論文の推奨を、自分の用途に移すときに決めることは5つあります。
- 問題の選び方:いつも正解・いつも不正解の問題を外す
- 呼び出しの密閉:モデル以外のもの(設定・ツール・CLI の版)が変わらないようにする
- 記録するもの:正答率だけでなく、出力トークン数も残す
- 検出できる幅:問題数と日数で何ポイントまで見えるかを、回す前に計算する
- 対照系列:同じ仕組みで別のモデルも回し、仕組みの側の変化と見分ける
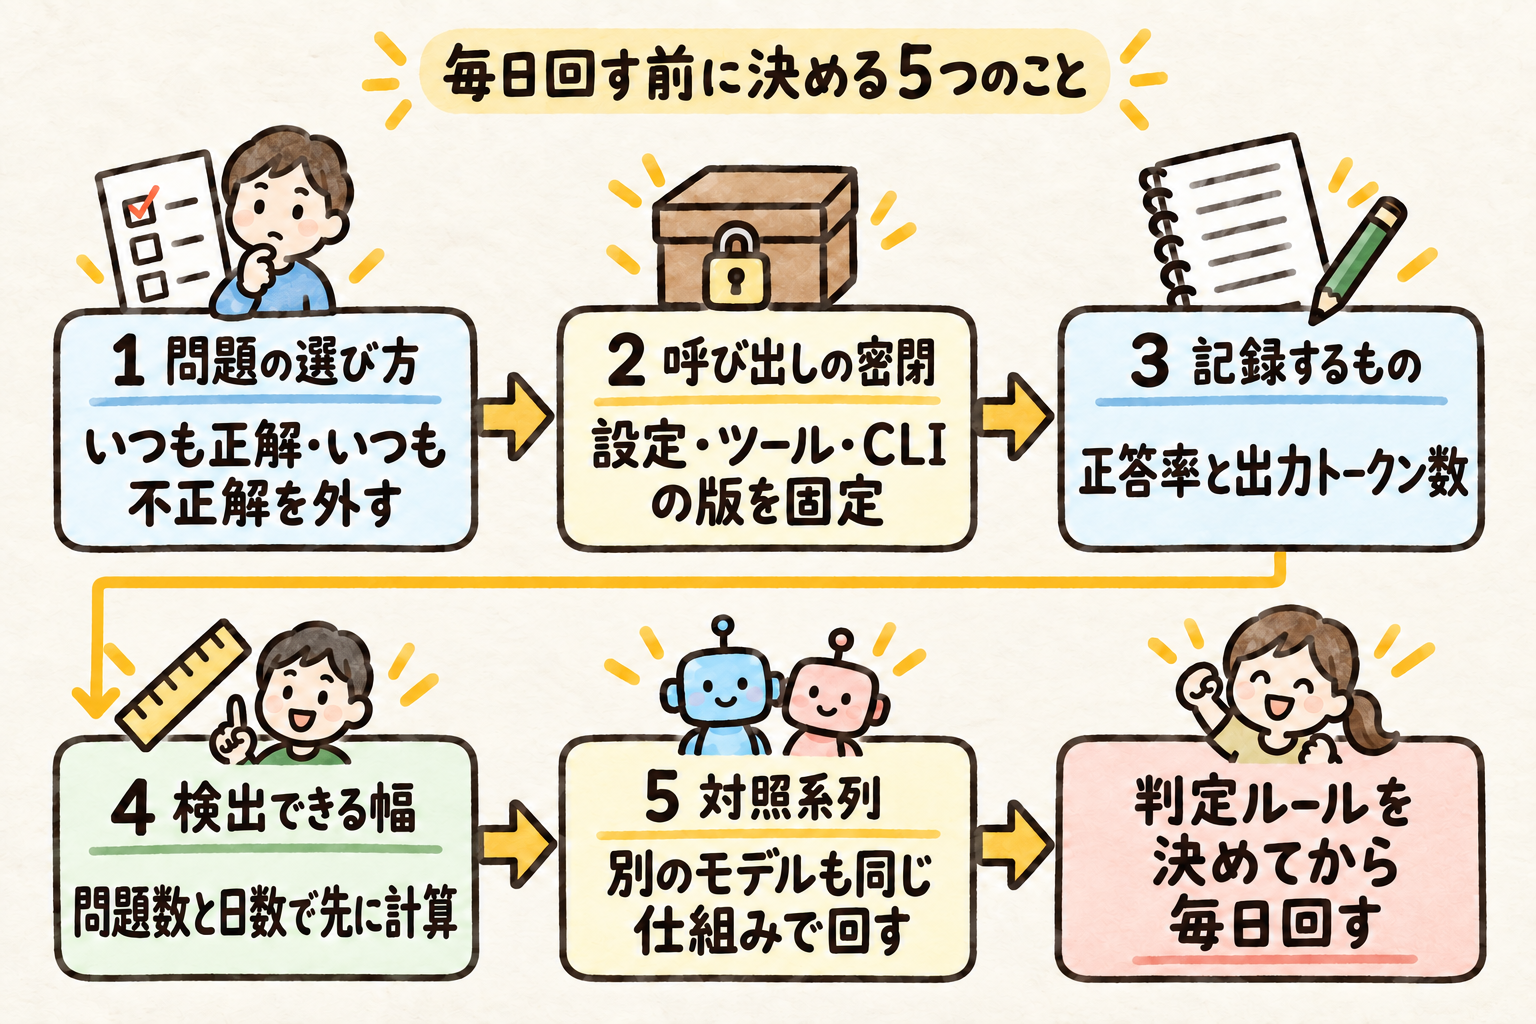
毎日回す前に決める5つのことを、livenerf の設計と論文の推奨から筆者が整理した図です。順番は筆者の考える決める順で、公式の手順ではありません。
見本:78問×10日で、何ポイントまで見えるか
4の計算を、livenerf が公表している条件(78問、1日1回、10日の窓、99%の基準、検出力80%)に当てた結果を見せます。基準の正答率は README の「62.0%」を使いました。ここで「何ポイントまで見えるか」と書くのは、その大きさの変化を検出力80%で見つけられる、という計画上の値です。それより小さい変化も見つかることはありますが、見落とす確率が上がります。
$ python3 mde.py --questions 78 --days 10 --accuracy 0.62 --alpha 0.01 --power 0.8
問題数 n = 78
1つの窓の回数 K = 10(1日1回なら日数)
1回の採点のばらつき σ² = 0.2356(--accuracy 0.62 から p(1-p))
窓の間のばらつき ω² = 0.0000
有意水準 α = 0.01(両側)、検出力 = 0.8
z(α/2) = 2.5758、z(β) = 0.8416
差の標準誤差 = 2.46 ポイント
検出できる最小の差 = 8.40 ポイント
livenerf の「about 7.5 points」より大きく出ました。livenerf の設計文書は標準誤差を 2.20 ポイントとしていますが、計算の内訳は載っておらず、差がどこから来るかは README と設計文書の数字だけでは確かめきれません(続きで、公開されている数字で計算し直した結果と、確かめきれない点を載せます)。どちらにしても、78問を10日まわしても、数ポイントの低下はたいてい見落とします。 同じ条件で4ポイントの低下が起きても、見つけられる確率は2割に届きません(筆者の計算)。「昨日から落ちた気がする」を判定できる仕組みではない、ということを先に知っておく必要があります。
続きで読めるのは、5つの決めごとそれぞれの手順と判定条件(問題を4回ずつ解かせて選ぶ基準と選んだあとの正答率の測り直し、API と Claude Code それぞれでの呼び出しの密閉と毎回の確認方法、トークン数を正しく読む場所と目安、検出できる幅の計算と判定ルールの決め方、対照系列の読み方)、検出できる最小の差を計算するスクリプトの全文(標準ライブラリのみ)と、論文の例と livenerf の公表値で検算した結果、目標の幅に必要な日数の出し方、そして計算を回したあとの判断図です。では、自分の問題数・日数・正答率で何ポイントまで見えるかを出し、その幅に合わせて判定ルールを先に決めるには、何をどの順で決めればよいのか。


 この記事の販売者