Mistral Large 4 公開プレビュー:何が出て、いま誰がどう試せるか(価格・条件・資料間の食い違い)
AI開発者の手帖
フランスの Mistral AI が10月6日、新しい旗艦モデル Mistral Large 4 の公開プレビュー(Public Preview)を出しました。いまは API で試せて、重みは10月末に公開する予定です。OpenRouter と Vercel AI Gateway からも利用できます。
API でオープン重みのモデルを使っている人や、Mistral の旧モデルからの乗り換えを考えている人には、何が出て、どの窓口から、どんな条件で試せるかが気になるところです。筆者は AI のモデルと開発ツールの仕様を、公式資料と照らして追ってきました。本稿は、Mistral の発表・モデルカード・changelog・docs の推論設定・モデルのライフサイクル・地域推論の各ページ、OpenRouter と Vercel のページ、Artificial Analysis の評価ページ、Hacker News の議論を10月7日(日本時間)に取得して突き合わせ、規模・価格・プレビューの条件・試し方を整理したものです。資料の間で数字が違うところは、そのまま並べています。
何が出たか
Mistral の発表によると、Mistral Large 4(略称 ML4)は総パラメータ1兆・active パラメータ 49B のネイティブなマルチモーダルモデルで、同社でこれまでで最大のモデルです。欧州の自社データセンターにある NVIDIA Grace Blackwell GPU 3,800基でゼロから学習し、プレビューも同じ基盤で提供しているとしています。
モデルカードは、粒度の細かい Mixture-of-Experts(MoE)構成で、active パラメータ 52B・総パラメータ 1.05T・視覚エンコーダ 1.6B と書いています。active パラメータは、発表(49B)とモデルカード(52B)で数字が違います。 機能の欄には Structured Outputs、Function Calling、Document QnA、Batching、Agents & Conversations などが並びます。
コンテキスト長も資料によって違います。
- Mistral のモデルカードと changelog:1M
- OpenRouter のモデルページ:524,288トークン、出力は最大262,144トークン
- Artificial Analysis のモデルページ:524k
長い入力を前提に組むなら、使う窓口で上限を確かめてからにしてください。
価格と半額期間
モデルカードの定価は、100万トークンあたり入力 $1.36、キャッシュ済み入力 $0.14、出力 $4.18 です。changelog の10月6日の項には「Launch pricing: 50% off for 2 weeks」とあり、モデルカードにも半額の $0.68・$0.07・$2.09 が並んでいます。OpenRouter も同じ値を「50% off」として表示しています。
model lifecycle の docs によると、Public Preview のモデルの料金は一般提供(GA)のモデルと同じ水準です。推論を EU か US の中で処理する地域エンドポイントを使うと、定価の1.1倍になります。
Public Preview という条件
lifecycle の docs は、Public Preview を次のように定めています。
- GA の手前の段階で、GA に達する前に更新されることがある。サイレント更新(告知の無い更新)がありうる
- GA へ進む保証は無く、GA の前に廃止されることもある
- 廃止の告知期間は1か月(GA のモデルは6か月)
- -latest や -major の別名の対象にならない。-latest が指すのは GA の最新版
発表も、このプレビューの強化学習はまだ続いており、今後数週間から数か月で大きく改善する見込みだと書いています。プレビューの間に評価した結果は、同じモデル ID でも後日そのまま再現するとは限りません。
推論の設定(reasoning_effort)
reasoning の docs は、mistral-large-4-0 が reasoning_effort パラメータで推論の出し方を調整できるとし、値ごとの応答の形を次のように説明しています。
- "high":最終回答の前に思考の chunk が付き、トークンの使用量が増える。message.content は文字列ではなく chunk のリスト(ThinkChunk と TextChunk)になる
- "none":推論は最小限で、思考の chunk は付かない。message.content は通常の文字列
- ストリーミングでは、思考の間の delta.content は chunk のリストで、回答に移ると文字列になる
- 複数ターンの会話では、ThinkChunk を含む assistant のメッセージ全体を履歴に戻すよう求めている
content を文字列として扱っているコードは、high に切り替える前にリストの場合の分岐が要ります。
Hacker News の議論では、Simon Willison が reasoning は「none」か「high」しか受け付けないと書いています。reasoning_effort が効かず、推論が出力に混ざるという報告もありました。
いま誰がどう試せるか
窓口は、自分の環境で動かしたいか、Mistral のアカウントで直接使うか、推論を EU か US の中で処理したいかで分かれます。
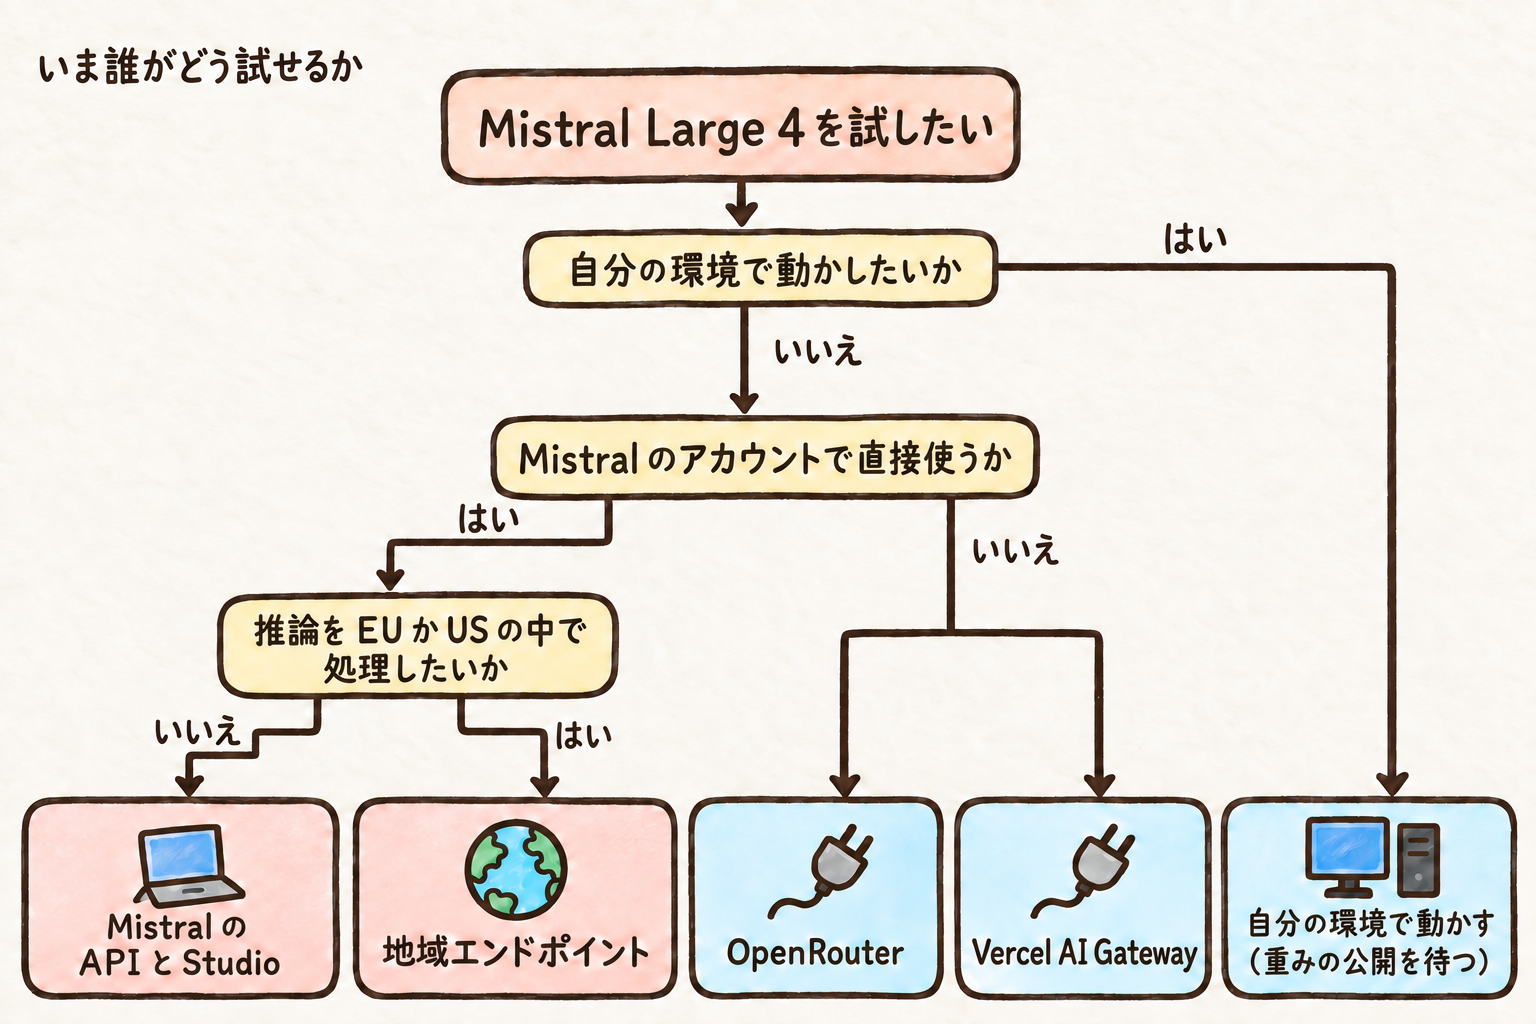
Mistral の発表・regional inference の docs・OpenRouter のモデルページ・Vercel の changelog の記述をもとに、試す窓口を筆者が分岐の形に並べたものです。地域エンドポイントで Mistral Large 4 が使えるとは資料に書かれておらず、発表は複数の地域での提供を今後の予定としています。モデル ID・料金(地域エンドポイントは定価の1.1倍)・重みの公開時期は本文の該当箇所を見てください。Public Preview は告知なく更新されたり GA 前に廃止されたりすることがあります。
- Mistral の API と Studio:発表は、プレビューの API を Mistral Studio で発表日から試せるとしています。モデル ID の表記は資料で違い、changelog とモデルカードは mistral-large-4、reasoning の docs は mistral-large-4-0 です。lifecycle の docs は Public Preview の ID を major-minor の形(mistral-large-4-0 の形)にすると定めており、mistral-large-4 がそれと同じものか別名かは資料からは分かりません。-latest の別名は使わず ID を明示し、regional inference の docs にある models.list(/v1/models)で、自分のアカウントに出る ID を確かめるのが確実です
- 推論を EU か US の中で処理したい場合:地域エンドポイント(api.eu.mistral.ai・api.us.mistral.ai)があり、料金は定価の1.1倍です。ただし、Mistral Large 4 が地域エンドポイントで使えるとは資料に書かれておらず、発表は複数の地域での提供を今後の予定としています。regional inference の docs によると、Agents・Batch・Files API は地域エンドポイントでは使えず、提供されるモデルも地域で異なるので、送る前にその地域で models.list を呼んで確かめるよう案内しています
- OpenRouter:mistralai/mistral-large-4-0 で提供されています。モデルページによると、提供元は Mistral の1社です
- Vercel AI Gateway:Vercel の changelog によると、mistral/mistral-large-4 で使えます。Mistral のアカウントを別に作らず、AI Gateway の API キーで呼べます。AI SDK、OpenAI 互換の Chat Completions API、Responses API、Anthropic Messages API に対応し、AI Gateway につないだコーディングエージェントからも選べるとしています
- 自分の環境で動かす:発表によると、重みは10月末までに公開する予定です。それまでは、サイバーセキュリティの有力企業・審査済みのパートナー・国の機関と、実環境で red-teaming を行うとしています
提供元が示した評価
Mistral の発表は、次の数字を挙げています。
- コーディング:DeepSWE v1.1 で 61.7%、SWE-Atlas-QnA で 59.4%、Terminal-Bench 4 で 28.3%
- サイバーセキュリティ:Artificial Analysis Cyber Index で世界の上位5モデルに入り、Cybench(セキュリティ競技から取った40問)の93%を解いた。脆弱性を再現して修正する課題では82%で、Claude Opus 5.5 や GPT-6 Astra は課題を拒否するためほぼ0点だった
- 安全性:Lakera の B3 AI Security Benchmark で攻撃の93.3%に耐え、JailbreakBench・StrongREJECT・AgentHarm のサイバー関連のプロンプトでの平均拒否率は、どのオープンモデルよりも高い
Hacker News では、閉じたモデルが拒否するから点が高いのなら攻撃にも使われやすいのではないかという疑問や、オープン重みのモデルとしてはまだ2番目に高いという価格への反論も出ています。
第三者の評価では、Artificial Analysis のモデルページが「Mistral Large 4 Preview」を Artificial Analysis Intelligence Index で 38(比較対象の中央値は26)としています。同じページは、評価で出力したトークンが2億(中央値は8,100万)で多い(very verbose)とし、取得時点ではモデルを「Proprietary model」と表示していました。
まだ分からないこと
- 半額の期間。2週間がいつからいつまでかは、changelog に書かれていません
- 重みのライセンス。発表に重みのライセンスは書かれていません。発表は、重みと一緒にアーキテクチャ・追加のベンチマーク・事後学習の詳細を出すとしています
- コンテキスト長(1M と 524,288トークン)と active パラメータ(49B と 52B)の食い違いが、どちらに揃うか
- mistral-large-4 と mistral-large-4-0 が同じものか
- 地域エンドポイントで Mistral Large 4 が使えるか、使えるならいつからか
- GA へ進むかどうかと、その時期
次にやること
半額の期間に試すなら、まず使う窓口を決め、モデル ID を明示して呼んでください。
- Mistral の API なら models.list で ID を確かめ、reasoning_effort を high にするときは content が chunk のリストで返る前提でコードを書く
- 長い入力を使うなら、窓口ごとのコンテキストの上限を確かめる
- 評価の結果を本番の判断に使うなら、サイレント更新がありうる前提で、評価した日付とモデル ID を残しておく
参考になったら、記事下部のライクとXの共有ボタンから応援してもらえるとうれしいです。


 この記事の販売者