新人オンボーディングが毎回バラバラ?Claudeで手順書からチェックリストとクイズを作る【中級者向け】
**TL;DR** - Claude公式のPDF Support(document入力)を使えば、手順書PDFをURL参照・base64・Files APIのいずれかでそのまま読み込める。 - Structured Outputs(`output_config.format`のJSON Schema)でチェックリスト・理解度クイズをそれぞれ厳密な形式で受け取れば、担当者が変わっても成果物の型が崩れない。 - ただし形式の保証と内容の正しさは別問題。クイズの`correct_index`やチェックリストとの紐付けIDを機械的に照合するスクリプトを、公式JSON Schema仕様に基づく設計として提示する。
新人オンボーディングは「手順書があるのに、チェックリストと理解度クイズが新人ごとにバラバラ」になりがちです。担当者によって「何を確認項目にするか」の粒度が変わったり、そもそもクイズが付いたり付かなかったりします。
その結果、確認漏れが起きやすくなり、新人側の理解度確認も毎回同じ基準で測れません。オンボーディングの質が属人的に揺れてしまうのです。
この問題は、人事・総務・情シスのように新人対応の運用を回すチームほど顕在化します。手順書は更新され続けても、チェックリストや理解度クイズの「整形」は担当者の手で調整されることが多いからです。
この記事でできること
- Claude公式のPDF Support(document入力)を使って、手順書PDF/テキストをそのまま読み込む方法が分かる。
- Structured Outputs(JSON Schema)でチェックリストと理解度クイズをそれぞれ一貫した形式で抽出するスキーマ設計ができる。
- スキーマ準拠・クイズとチェックリストの整合性を機械的に検証するスクリプトの設計(本記事のために作成)を再利用できる。
- 長い手順書の分割、複数手順書の統合、更新運用など、応用パターンへの対処が分かる。
対象読者
**【中級者向け】** 人事・総務・情シスなど、新人オンボーディングの手順書・マニュアルを保有し、チェックリストや理解度確認クイズの整備を担当する人を対象とします。
Claude APIキーを取得済み、またはこれから取得してPythonスクリプトを実行できる方を想定しており、JSON Schemaの基本、Pythonの基本文法は既知として進めます。
手順書はちゃんとあるのに、チェックリストとクイズが人によって全然違うんです…これって仕方ないんでしょうか?
手順書を"人がその都度整形"しているうちは、どうしてもブレが出るんです。 Claude APIのStructured OutputsでJSON Schemaを固定すれば、担当者が変わっても出力の型は揃います。 やり方を順番に見ていきましょう。
何が便利なのか:手作業・Excelテンプレート・Claude APIの比較
| 観点 | 手作業での整形 | Excelテンプレート運用 | Claude API(PDF Support + Structured Outputs) |
| 担当者間のブレ | 大(人によって粒度が変わる) | 中(テンプレートはあるが入力は手動) | 小(JSON Schemaで型を固定) |
| 手順書更新への追従 | 都度作り直し | コピー&修正が中心 | セクション単位で差分再生成しやすい |
| チェックリストとクイズの紐付け | 目視で管理 | シート上で手動管理 | `source_checklist_item_id`で機械的に照合可能 |
| 導入コスト | 低いが属人的 | 低〜中(テンプレート整備が必要) | 中(スキーマ設計と検証スクリプトが必要) |
全体像:PDF入力からチェックリスト・クイズを一貫生成する流れ
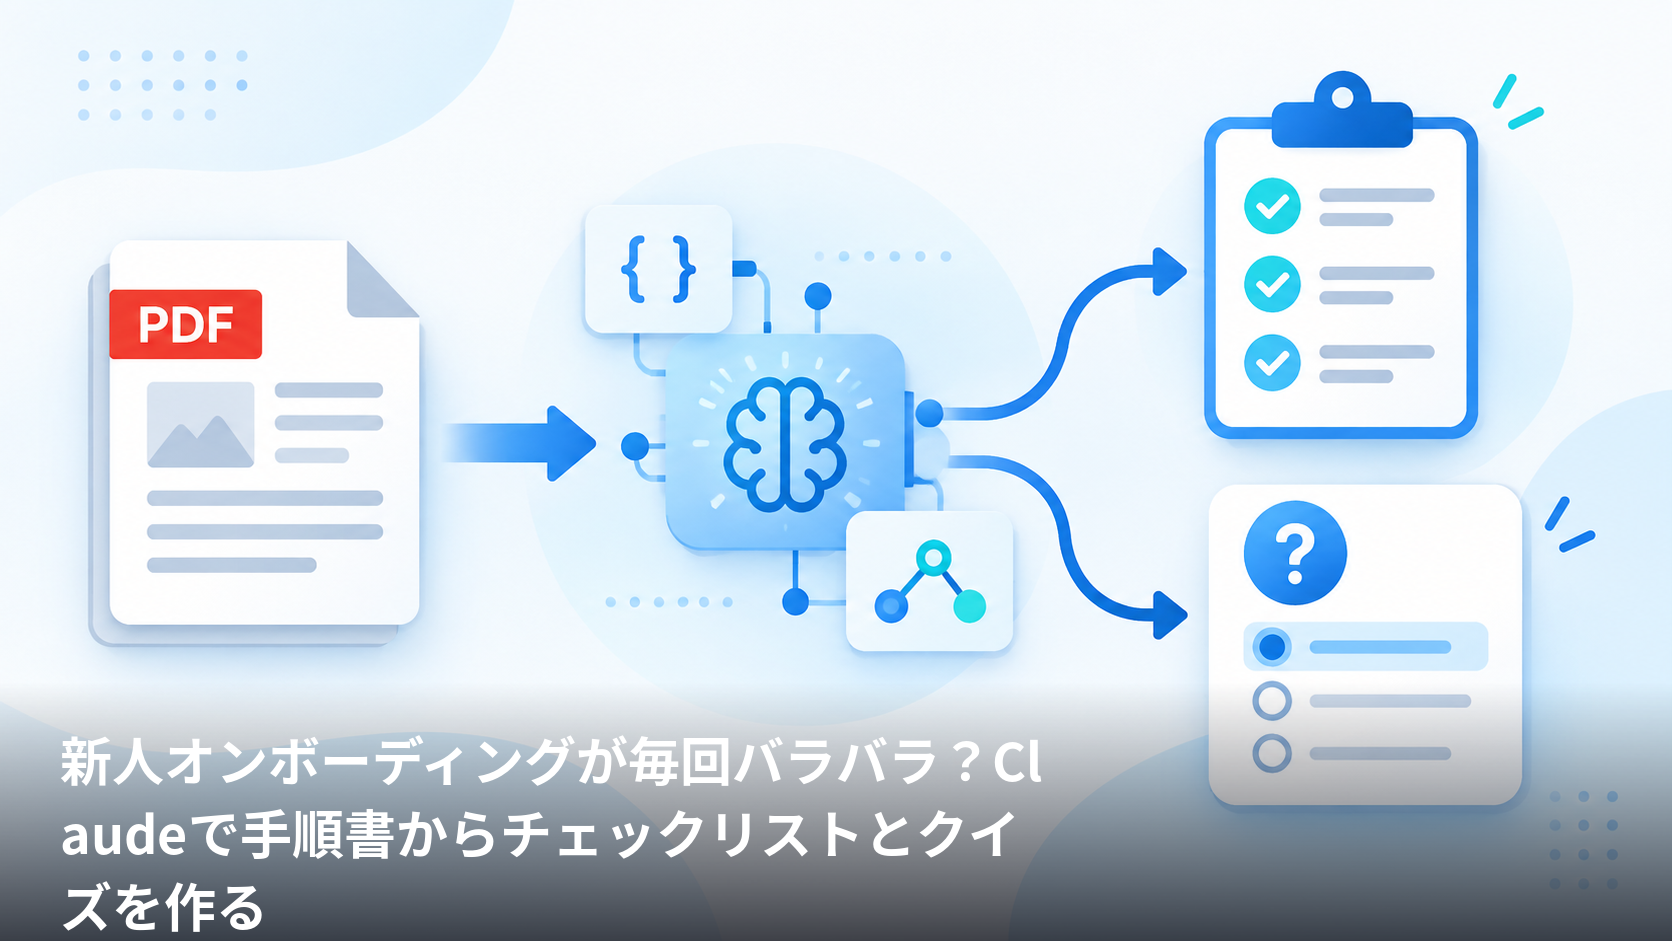
手順書PDF(またはテキスト)をClaudeに渡して、その内容から「チェックリスト項目」と「理解度クイズ」をそれぞれ抽出します。重要なのは、抽出結果をStructured OutputsのJSON Schemaで"厳密に"受け取ることです。これにより、出力がJSONとして壊れないだけでなく、必須フィールドや型も揃います。
Claudeに手順書を渡す方法は、PDF Supportのdocumentブロックを使い、URL参照・base64エンコード・Files APIのfile_id参照のいずれかで渡せます。大きいPDFはFiles API経由が推奨されるため、オンボーディング手順書が複数ページに及ぶ場合は特に有効です。
PDF処理の上限として、最大リクエストサイズ(32MB)や最大ページ数(1リクエストあたり600ページ、コンテキストウィンドウが1M未満なら100ページ)が示されています。Dense PDFs(小さい文字が多い、複雑な表が多い、グラフが重いなど)は文脈が埋まりやすい点も注意です。対策として、手順書を章ごとに分割して渡す・画像のダウンサンプルで軽くする、という方針が公式に示されています。
Structured Outputsで切り出すのは基本二段階です。1つ目はチェックリストの抽出、2つ目は理解度クイズの抽出です。チェックリストでは「項目」「分類」「該当箇所」を、クイズでは「問題文」「選択肢」「正解」「該当するチェックリストID」を、それぞれJSON Schemaのフィールドとして定義します。
全体フローは次の通りです。
- 手順書PDF(またはテキスト)をdocumentブロックとして読み込む
- チェックリスト用のJSON Schemaを指定し、チェックリスト項目を抽出させる
- 理解度クイズ用のJSON Schemaを指定し、クイズ問題を抽出させる
- それぞれのJSONをアプリ側で受け取り、スキーマ準拠・整合性を検証してから保存・表示する
Structured Outputsは「スキーマに準拠する応答を保証する」ことが強調されており、型と必須フィールドが保証され、JSON.parse()エラーなどの頻出問題を減らせます。とはいえ、内容が手順書と一致しているかは別問題です。この記事では、その一致確認をどう機械化するかまで扱います。
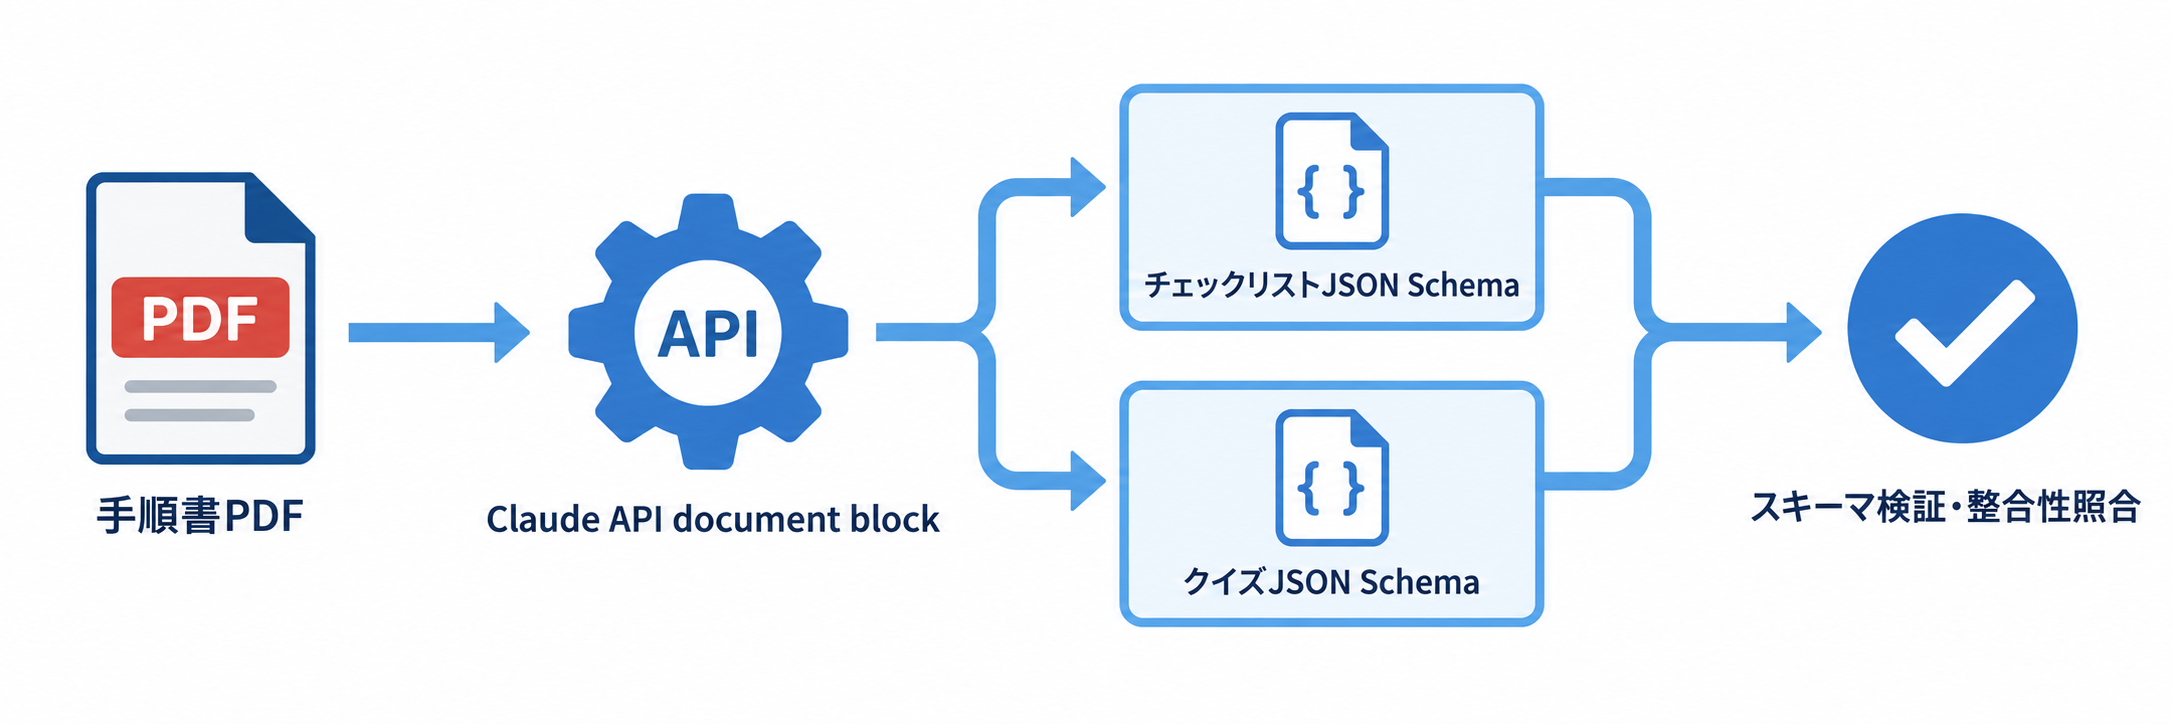
手順書PDFの読み込みからチェックリスト・クイズのJSON Schema抽出、検証までの全体フロー(図解)
無料パートではここまでの考え方を扱いました。有料パートでは、チェックリストと理解度クイズそれぞれのJSON Schemaを具体的に設計し、整合性照合スクリプトの設計、長い手順書・複数手順書・更新運用への応用、そしてよくあるエラー3パターンまで一気に扱います。
 この記事の販売者