毎日の仕事はOpusじゃなくていい――Claude Sonnet 5.5、速さとコストで変わるAIの使い分け
シン@AI統制&マルチエージェント
Anthropicは2026年9月28日、「Claude Sonnet 5.5」を発表しました。
派手な最高性能競争というより、普段の仕事を、より速く・少ない計算量で回すことに焦点を当てたモデルです。AnthropicはSonnet 5比で出力が30%以上速く、多くの作業で1件あたり最大30%安くなると説明しています。
ただし、この「最大30%安い」はAPIの単価が下がったという意味ではありません。入力100万トークンあたり2ドル、出力10ドルはSonnet 5と同じです。少ない出力トークンや短い処理で同じ仕事を終えられるため、タスク単位の費用が下がるというAnthropicの測定です。
【変更点:高性能モデルを「毎回使う」から、役割で分けるへ】
Sonnet 5.5は、明確に範囲を切れる日常業務、バグ修正、文書・スライド・表計算の作成を主戦場にしています。一方のOpus 5.5は、曖昧で複雑な問題、長時間の判断、大きな設計を担当する位置づけです。
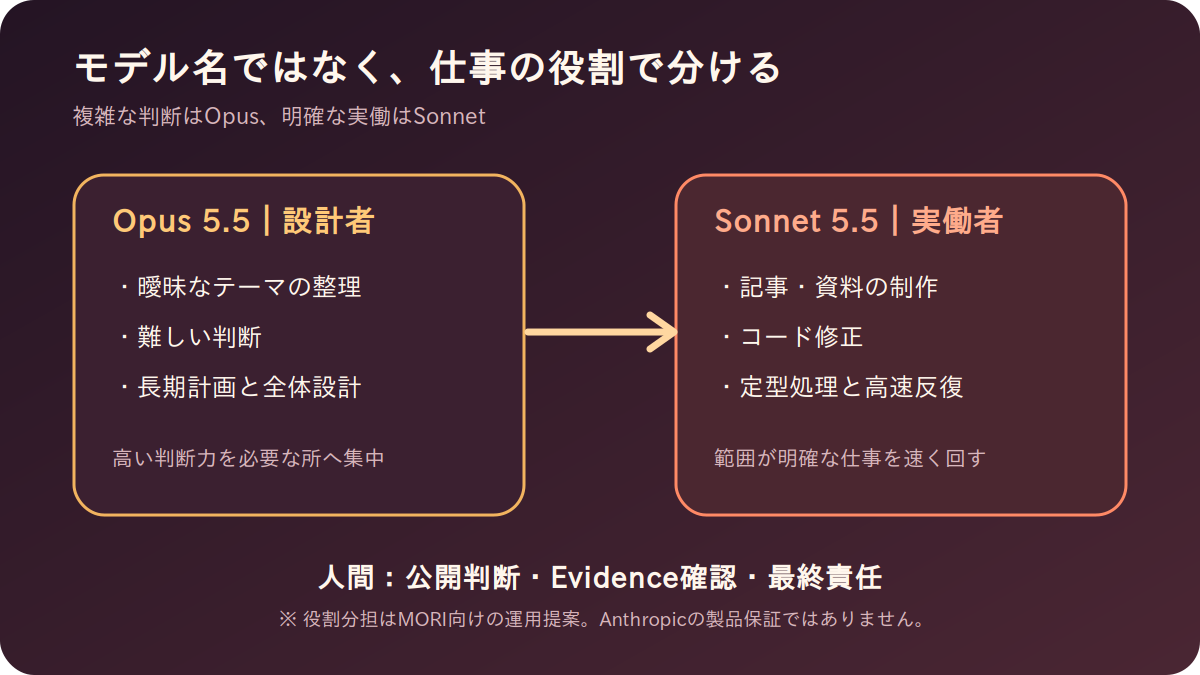
この分け方は、単純な「安いモデル/高いモデル」ではありません。たとえばOpusが全体設計と難しい判断を行い、Sonnetが大量の実装や資料制作を高速に進める。MORIが重視する複数AI協働でも、仕事の難度と責任に合わせてモデルを配役する考え方が使えます。
Anthropicの内部評価では、Sonnet 5.5はTerminal-Bench 4.0で70.6%、Sonnet 5は10.3%でした。GDPval-AAではOpus 5.5と2点差とされています。ただし、これらはAnthropicの評価条件による性能主張で、すべての実務で同じ差が出ることを保証しません。
【料金:単価据え置きでも、仕事1件の費用は変わり得る】
API料金は入力2ドル、出力10ドル、キャッシュ読み出し0.20ドル、キャッシュ書き込み2.50ドルです。コンテキストは100万トークン、最大出力は12.8万トークン。APIのモデルIDは claude-sonnet-5-5 です。
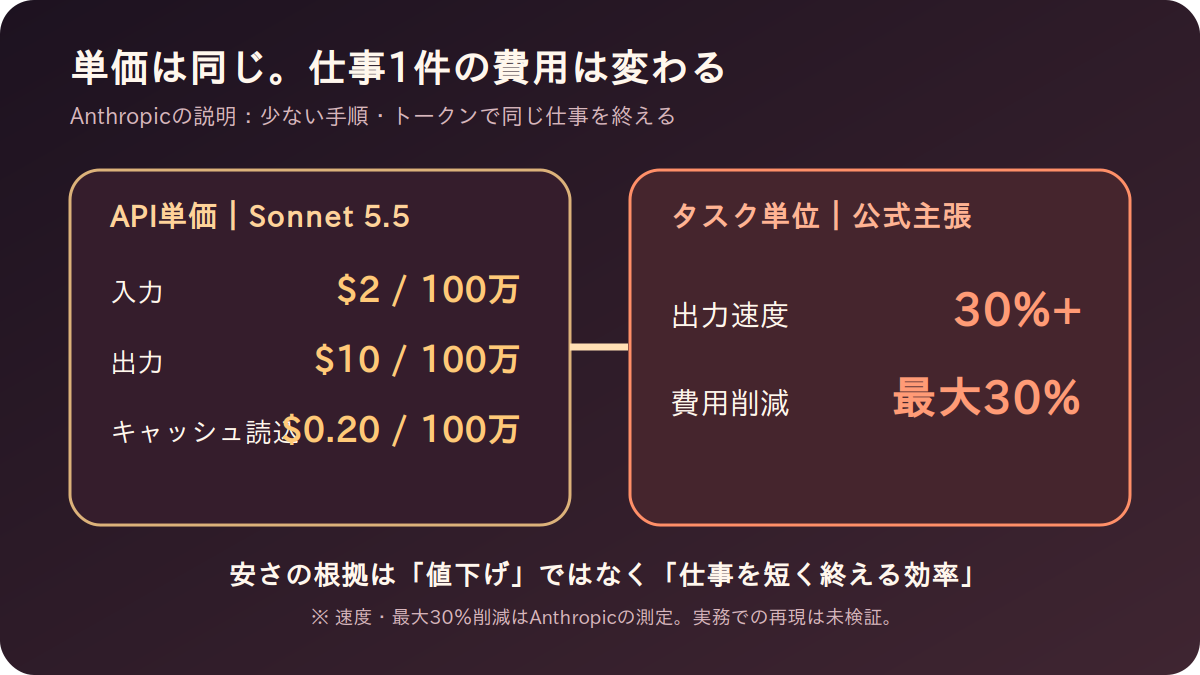
ここで大事なのは、トークン単価と、仕事1件を終える費用は別ということです。同じ単価でも、必要な手順・ツール呼び出し・出力トークンが減れば総額は下がります。逆に、高いeffort設定で長く考えさせれば、Sonnetでも費用は上がります。
Anthropicは、ClaudeアプリとClaude Codeの標準effortをMedium、Claude APIの標準をHighにしています。速度・費用・品質のバランスは、モデル名だけでなくeffort設定まで含めて判断する必要があります。
【独立評価:総合2位級。ただし、苦手と安全策の影響も見える】
独立評価機関Vals AIでは、Sonnet 5.5はVals Indexで66モデル中2位、1テストあたり20.80ドル。首位のOpus 5.5とは0.47ポイント差で、テスト費用は3分の2未満でした。
コード移行とVibe Code Benchでは1位。一方、CyberBenchは41モデル中31位、法律エージェント評価は70モデル中35位タイでした。総合力は高いけれど、用途ごとの差は大きいと見るのが正確です。
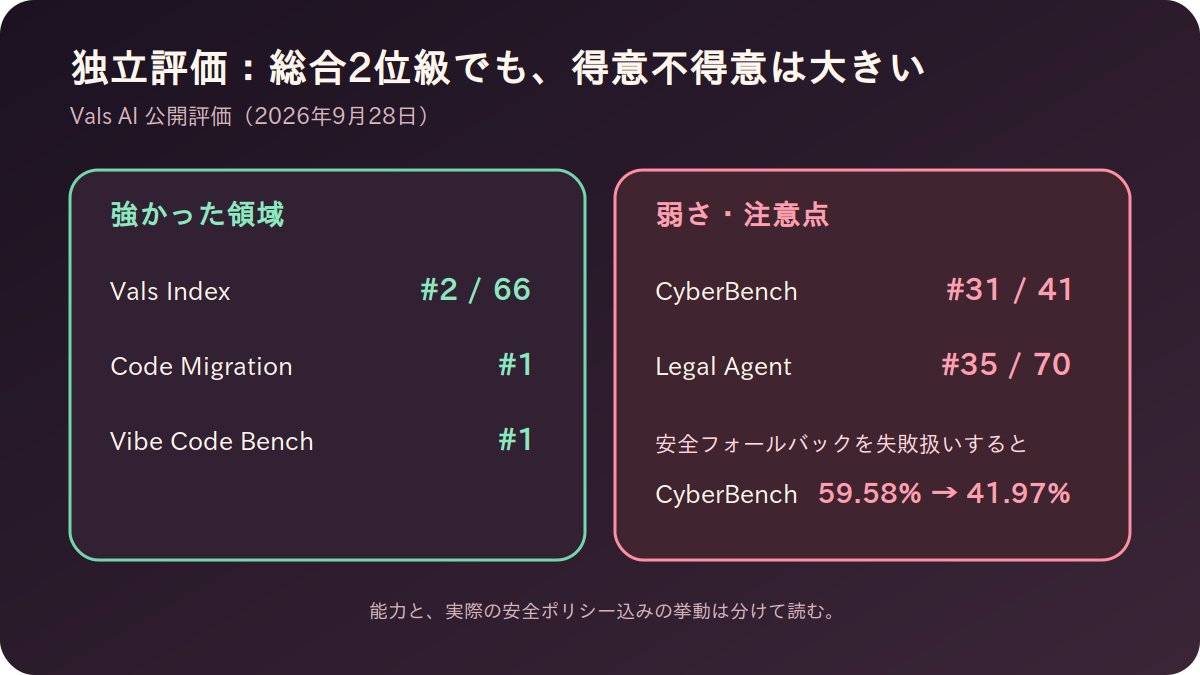
さらにValsは、高リスクなリクエストがSonnet 5へフォールバックしたケースを失敗扱いにすると、CyberBenchが59.58%から41.97%へ下がると報告しています。これは単純な能力不足だけでなく、安全策を含む実際の提供システムをどう採点するかで結果が変わることを示します。
【利用可能性と移行時の注意】
Sonnet 5.5は発表と同時にClaude API、Amazon Bedrock、Google Cloud、Microsoft Foundryを含む各プラットフォームで利用可能になりました。Anthropicはゼロデータ保持にも対応すると案内しています。
ただし、Sonnet 5向けコードをそのまま移すと壊れる可能性があります。公式リリースノートでは、思考を無効化する設定、強制ツール選択、computer useの旧ツールなどに互換性変更があると明記されています。将来移行する場合はモデルIDだけの差し替えで済ませず、公式移行ガイドを確認すべきです。
また、高リスクなサイバーセキュリティ要求はSonnet 5へフォールバックする場合があります。これは「モデルの能力」と「ユーザーが実際に使える能力」が同じではない例です。
【MORIとの関係:制作ラインの“実働層”に向く】
MORIのニュース制作やHuman OSでは、毎回すべてを最高位モデルに任せるより、次のような配役が現実的です。
・Opus 5.5:曖昧なテーマの設計、難しい判断、長期計画
・Sonnet 5.5:記事本文、コード修正、図解の仕様化、媒体別変換
・人間:公開判断、関係性、事実確認、最終責任
この分業なら、能力の高いモデルを判断に集中させ、Sonnetを高速な実働役として使えます。人間の作業を減らす鍵は、単にモデルを入れ替えることではなく、どの判断を誰に任せ、どこで検証するかを設計することです。
今回は公式資料と独立評価を確認しましたが、MORIの実データでのAPI比較や、実際の記事制作時間・費用の測定は行っていません。効果は未実施のままです。
【まとめ】
Claude Sonnet 5.5の重要点は、最高峰モデルに近い領域を、日常業務向けの速度と費用で提供しようとしていることです。
公式には30%以上高速、タスク単位で最大30%安い。独立評価でも総合2位級で、コード移行やVibe Codingでは首位でした。一方、サイバー・法律領域では弱さがあり、安全フォールバックも評価を大きく左右します。
MORIにとっては、Opusを設計者、Sonnetを実働者にする複数AI協働がいちばん面白い使い道です。高性能な1体に全部やらせるより、役割・権限・検証を分ける。Sonnet 5.5は、その分業を現実的にするモデルです。
【出典】
Anthropic公式発表(2026年9月28日)
https://www.anthropic.com/claude-sonnet-5-5
Claude Platformリリースノート
https://platform.claude.com/docs/en/release-notes/overview
Claude Platform料金表
https://platform.claude.com/docs/en/about-claude/pricing
Vals AI独立評価
https://www.vals.ai/models/anthropic_claude-sonnet-5-5


 この記事の販売者