AIが「記憶」を編集する――CLMが示した、長時間・複数AI協働の新しい形
シン@AI統制&マルチエージェント
長い仕事をAIに任せると、会話が増えるにつれて「いま何が確定していて、何が残っているのか」を整理する必要が出てきます。新しい研究 Context Language Models(CLM) は、その整理自体をAIの仕事にする仕組みです。
2026年9月29日付でarXivへ投稿された論文と、facebookresearchの公式リポジトリを10月1日に確認しました。ワシントン大学、Meta Superintelligence Labs、MIT、Trillium Labsの研究者による共同研究です。ここでいう「記憶」は、モデルが次の判断に読む作業中の文脈(コンテキスト)を指します。[1][2]
押さえたい点は3つです。
- 文脈をファイルとして編集し、次の判断へ反映する。
- 長時間の評価で、要約方式より少ない計算量と高い成績を報告している。
- 編集できる作業メモと、元資料・承認・実行記録を分けて考える必要がある。
1.会話を積み上げるだけでなく、作業メモを整える
CLMでは、モデルが読む文脈をファイルへ写し、AIが汎用のコマンドで書き換えられるようにします。編集した内容は、次のモデル呼び出しで読む文脈へ同期されます。単に「別のメモファイルを作った」という話とは、この同期の点が違います。[1]
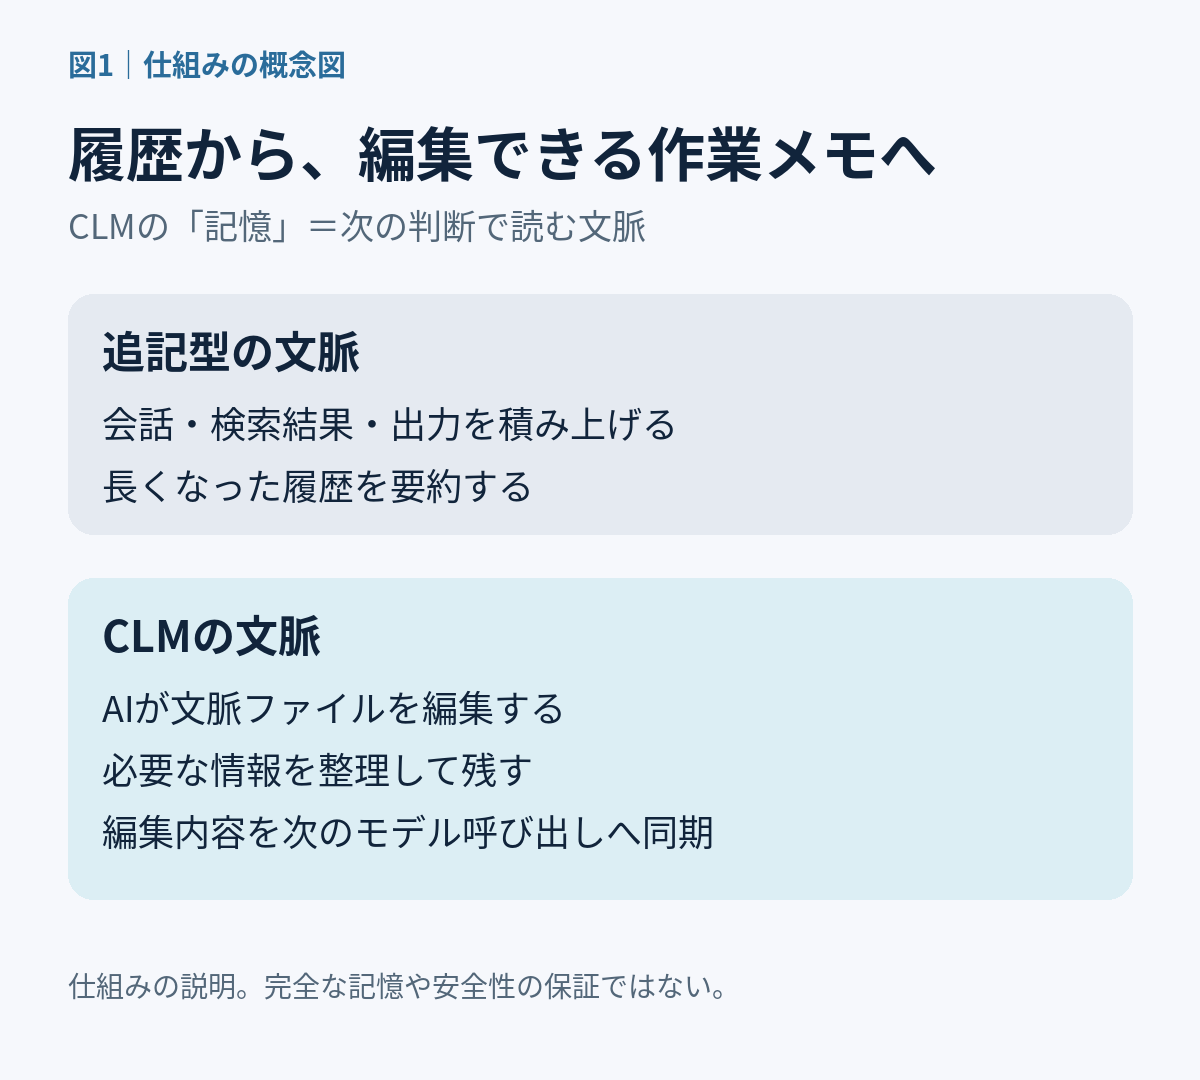
例えば記事制作なら、検索結果をすべて同じ大きさで持ち続ける代わりに、「採用した一次資料」「撤回した候補」「公開済みの媒体」「次に確認する点」を作業メモへ整理するイメージです。これは本記事の説明用の例で、今回その制作運用をCLMで実行したわけではありません。
複数AIにも、担当ごとの文脈ファイルを持たせられます。人間が何度も全員へ進捗を説明し直す負担を減らす可能性があります。ただし、共有範囲や誰が書き換えられるかは、別途設計する部分です。
2.「計算量59%減」は何を比べた数字か
論文の12時間評価EdgeBench-10では、Qwen3.6-27Bを使ったCLMのスコアは 44.6、Codex風の要約方式は 42.3。計算量はそれぞれ 179と437 prefix-reuse PFLOPsでした。約5%高いスコア、約59%少ない計算量という著者の報告は、この比較に対応します。[1]
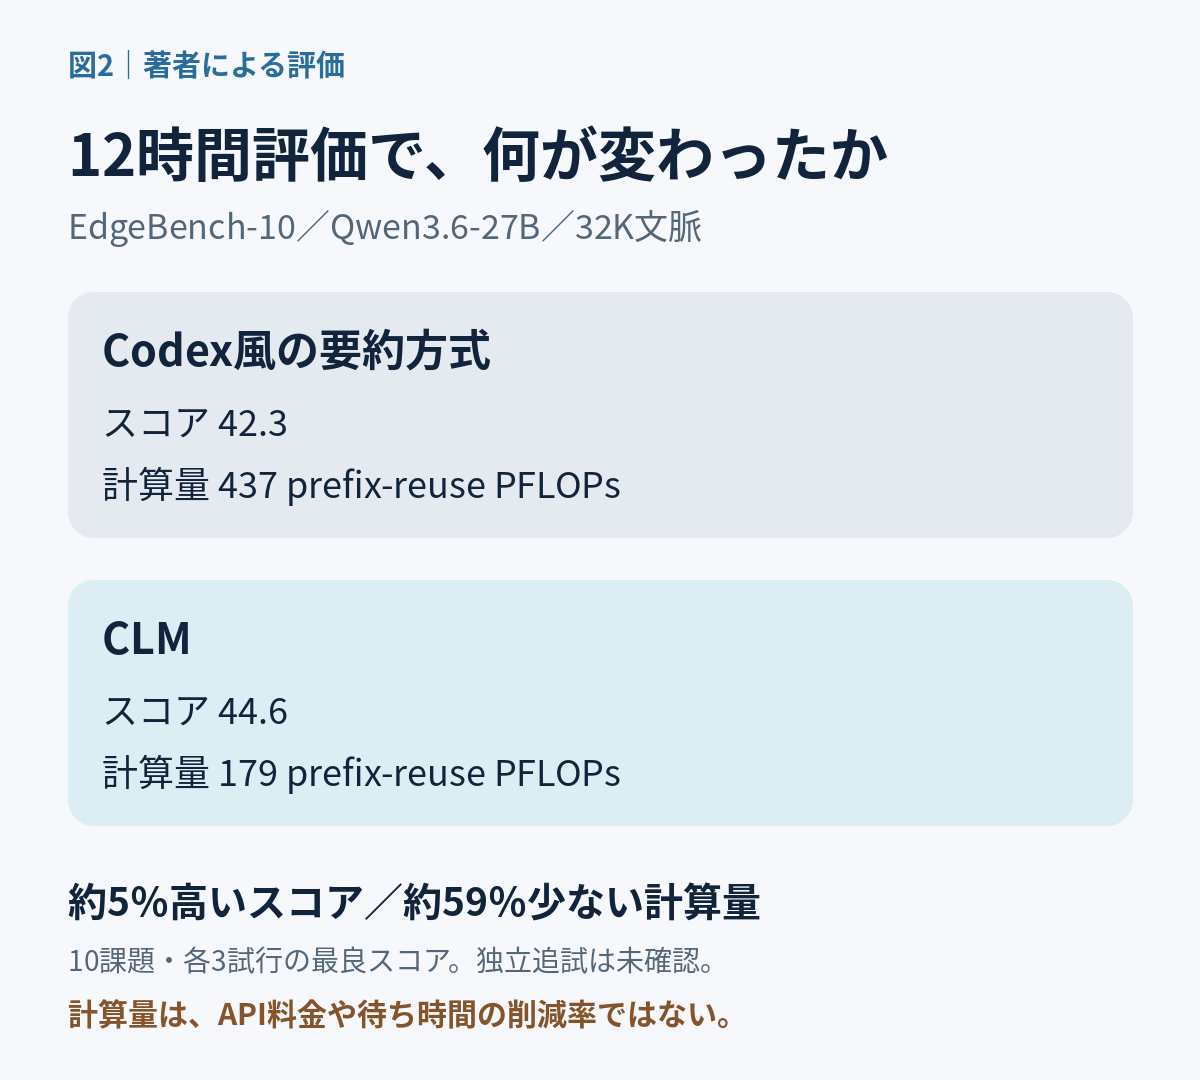
PFLOPsは計算処理量の単位です。この評価では、文脈を編集した後に読み直す処理も含めて比較しています。API料金が59%安くなる、作業時間が59%短くなる、という数字ではありません。
条件も大切です。対象は公開EdgeBenchの48課題中10課題、文脈上限は32K、各課題3回の試行から最良スコアを使っています。今回、独立した追試やMORIの環境での実行は確認していません。[1]
3.作業メモが編集できても、Evidenceは残す
MORIのように調査・制作・確認を複数AIへ任せる運用では、文脈整理が進歩すると「前の担当が何をしていたか」の引き継ぎが楽になる可能性があります。一方で、AIが書いたメモを、それだけで事実や承認の証拠にはできません。
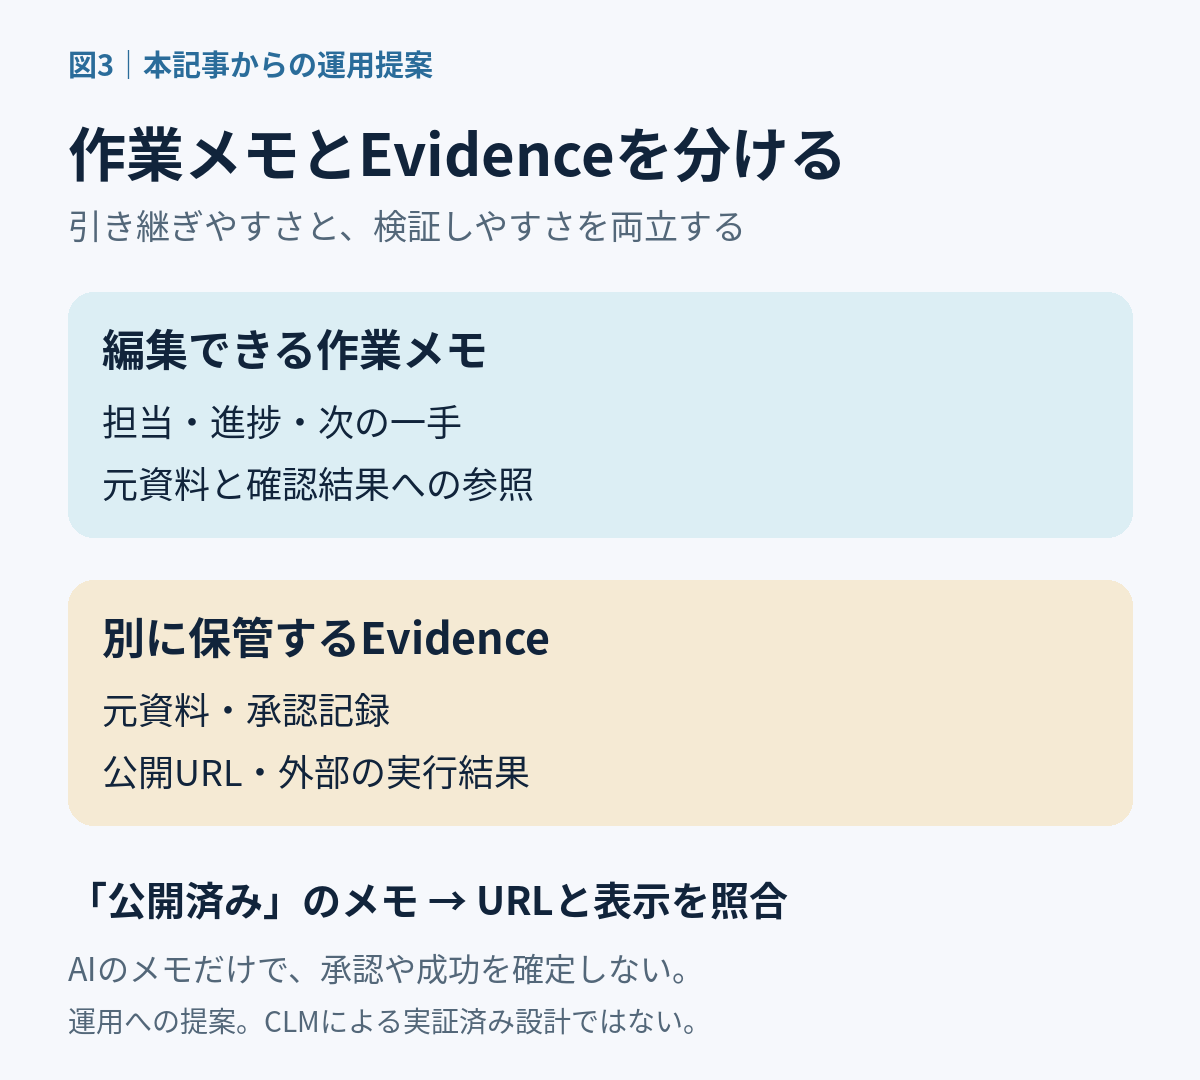
例えば「Qiitaへ公開済み」とメモにあっても、公開URLと表示を確認して初めて公開を確認した状態になります。作業メモには、その確認先への参照を残す。担当AIがメモを短くした後も、元資料と外部の結果へ戻れる構成が有用です。これは本記事からの運用提案であり、CLMによる安全性の実証結果ではありません。
論文自身も、編集可能な文脈が不正な指示を次のターンへ残す経路になり得ると指摘し、防御を今後の課題に挙げています。[1]
いま利用できるもの
公式リポジトリには実装と導入例が公開されています。ContextBenchはREADME上で「Coming soon」です。コードの公開と、一般のチャット製品で使えることは別で、ChatGPTやClaudeへこの仕組みが標準搭載された発表ではありません。[2]
リポジトリは CC BY-NC 4.0 と表示されています。公開コードを商品へ組み込む判断では、商用利用条件の確認が必要です。本記事では導入・課金を行っておらず、論文とREADMEを読んだ範囲の紹介です。[2][3]
まとめ
CLMの面白さは、「もっと長い履歴を持つ」ことに加え、次の仕事に必要な文脈をAI自身が整えるところにあります。長時間・複数AI協働の継続性に関わる研究ですが、性能は著者評価で、実運用の成功や安全性を保証するものではありません。
実用への接続では、編集できる作業メモに元資料と確認結果への参照を残す。それによって、引き継ぎやすさと検証しやすさを両立できるかが注目点です。
出典
確認日:2026年10月1日。本文図解は本記事用の独自作成。図1は仕組みの概念図、図2は著者評価の再整理、図3は運用への提案です。
- Shaoら「Context Language Models」arXiv:2609.37725v1、2026年9月29日投稿 — §4.1、§5.1.2、§6、Appendix E。
- 公式リポジトリ facebookresearch/context-language-models — README、公開範囲、ライセンス表示。
- 公式LICENSE


 この記事の販売者