【重複購入のご注意】この記事は「ミオ|AI大好きな後輩」がnoteで販売している同名記事(LLMの分類を判断モデルへ移す前に:OpenAI Decisions API・Jev・Strands Deciderの選び方と閾値の決め方)と同じ内容です。すでにnoteで購入・閲覧できる方は重複購入にご注意ください。
問い合わせの振り分け、投稿の分類、採点、入力のガードレールを、いま LLM(OpenAI の Responses API の Structured Outputs や Claude の structured outputs)でこなしている開発者と小規模チームに向けて書きます。判断モデルそのものの学習や微調整、クラウド事業者の基盤サービス経由で使う場合の条件は対象外です。
筆者は AI 開発ツールの仕様と使い方を公式資料と照らして追い、有料記事でも扱ってきました。本稿は、OpenAI・TypeSafe・Strands・llama.cpp・Liquid AI・Vercel・Anthropic の文書と GitHub の issue、Red Hat の検証記事、Simon Willison の記事、Hacker News のコメントを2026年10月8日(JST)に取得して突き合わせたものです。料金や上限は取得日の値で、変わりえます。公式の記述と筆者の整理は分けて書きます。
何が出たか
判断モデル(decision model)は、文章を生成せず、決められた選択肢ごとの確率を返すモデルです。答えの型は3つで、はい・いいえの確率、固定の選択肢から1つ、順序のある段階での採点です。9月15日に TypeSafe が Jev を出し、10月1日に Strands が手元で動く2B の Strands Decider を公開しました。llama.cpp のサーバには Jev と同じ形で答える /v1/systemone が入り、Liquid AI は3B の d1-3B を出しています。
10月6日には OpenAI が Decisions API を公開ベータで出しました(Simon Willison の同日の記事は、Jev と同じ3つの型を持ち、Jev と違って画像も入力できると書いています)。OpenAI の Decisions API のガイドによると、使えるモデルは gpt-6-luna だけで、入力100万トークンあたり0.10ドルの入力分だけが課金され、出力やキャッシュの課金はありません。地域処理の割増と長い入力の倍率はかかります。数週間のうちに一般提供にする見込みとも書かれています。Vercel の AI Gateway は同じ形のエンドポイントで、Jev や Liquid の d1 なども呼べるようにしました。
公式の線引きと、そこで終わらない理由
OpenAI のガイドの線引きは単純です。答えがこの3つの型のどれかなら Decisions を使い、自分の JSON スキーマに沿った値を作りたいとき(抜き出した項目や説明の文)は Responses API の Structured Outputs を、ツールを引数つきで呼ばせたいときは関数呼び出しを使う、というものです。
ただ、移す前に決めることはこの線引きの外に残ります。同じガイドは、閾値はアプリのラベル付きの例から、誤検知と見逃しのコストで決めるように書いていますが、値の決め方の手順はありません。実装ごとに応答の形が違い、confidence の定義も同じとは限りません。
判断モデルに慎重な検証もあります。Red Hat の検証記事は、プロンプトインジェクションと有害な内容の検出で9通りのガードレールを比べ、判断モデルが LLM に判定させる方式より速い・安い・質が高いという結果は得られなかった、と結論しています。ただし小さい Laya は、問いの書き方を調整して制約を補えるなら、規模の小ささが利点になる例外としています。ラベル付きのデータが豊富でリスクの定義がはっきりした領域では、事前に学習させた小さな分類器が依然として強い、とも書いています。Hacker News には、Decisions API で選択肢の並びを変えたら確率が86%から73%に動いたという報告もあります。
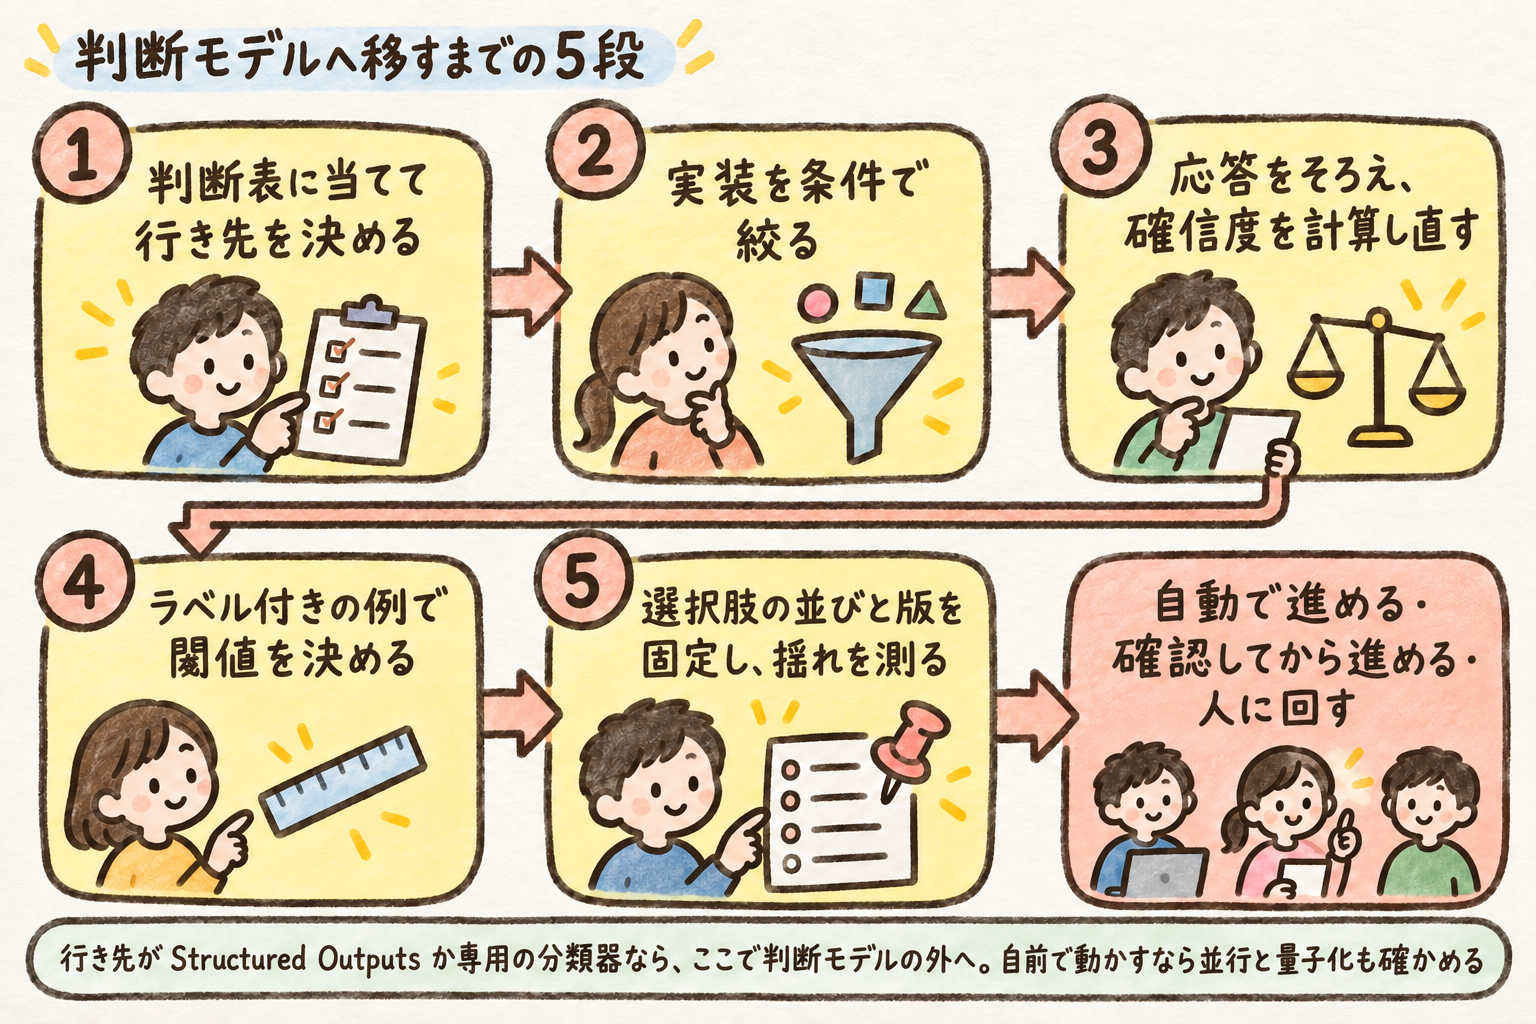
判断モデルへ処理を移すまでの作業の順番を、筆者が5段に整理したものです。各段は有料部の判断表・実装の選び方・手順1(図の「確信度」は本文の confidence)・手順2・手順3に対応し、自前のサーバで動かす場合の並行と量子化の確認(手順4)は図の下の注記に書きました。図の下の注記を補足すると、Structured Outputs への分岐は判断表の段で行い、専用の分類器との比較は閾値の段の検証用の例で行って、分類器のコストが小さければ判断表3へ戻ります。閾値の値と並びの揺れの大きさは、読者が自分のラベル付きの例で測る前提です。
図の下の注記を補足します。行き先が Structured Outputs なら、判断表の段で判断モデルの外へ進みます。専用の分類器との比較は、閾値を決めた後に手順2の検証用の例で行い、分類器のコストが小さければ判断表3へ戻って切り替えます。
判断表の見本:問い合わせの振り分け
有料部の判断表は、処理ごとに「どこで動かすか」と理由を1つずつ決めます。問い合わせの振り分けの分です。
- 行き先:判断モデル(固定の選択肢から1つ)。部署名を選択肢にし、どれにも当たらない問い合わせ用に「other」を足して、それが選ばれたら人の窓口へ回します。OpenAI のガイドも、分類が入力を覆いきれないときは other のような受け皿の選択肢を入れるように書いています
- 残すもの:顧客へ返す返答の文と、問い合わせから注文番号などを抜き出す処理は Structured Outputs に残します。答えが選択肢では表せないからです
- 閾値:閾値は2つ置きます。確認なしで振り分ける confidence 以上はそのまま振り分け、それ未満でもう1つの下限以上は担当者が確かめてから振り分け、下限未満は人の窓口へ回します。確認なしで進める値はラベル付きの例と誤りのコストから、下限は確認の帯で当たる率から決めます
- 確かめること:選択肢の並びを入れ替えて同じ問い合わせを送り、確率の揺れを測ります。モデルの版を固定し、版を上げたら閾値を決め直します
参考になったら、記事下部のライクとXの共有ボタンから応援してもらえるとうれしいです。
続きで読めるのは、処理ごとに判断モデル・Structured Outputs・専用の分類器のどれで動かすかを決める判断表(Claude の structured outputs に残す処理を含む)、OpenAI Decisions API・Jev・Strands Decider・llama.cpp・d1-3B の選び方(API で使う OpenAI と Jev の料金とデータの扱い、各実装の入力の上限と画像の扱い、Strands Decider と llama.cpp の既知の不具合)、各社の応答を1つの形にそろえて confidence を計算し直し、閾値で「自動で進める・確認してから進める・人に回す」に分ける Python のコード例、ラベル付きの例と誤りのコストから閾値を選び、選定に使っていない検証用の例で採否を確かめる手順、選択肢の並びの揺れを確かめる手順、自前のサーバで並行処理と量子化を確かめる手順(量子化の不合格の条件と対処を含む)、判断表の問いを当てる順の図です。コード例は API を呼ばない関数だけで、各社の公開されている応答例と合成の例に当てて動作を確かめています。では、どの処理を判断モデルへ移し、どれを Structured Outputs に残し、移した処理の閾値と揺れをどう決めて確かめればよいのか。


 この記事の販売者