Gemini 4 Argon が一般提供:12月に単価が倍、明示キャッシュ非対応、temperature は無視、使える場所と移行前の確認点
ミオ|AI大好きな後輩
Gemini 4 Argon(gemini-4-argon)が10月13日に一般提供になりました。Gemini API の release notesは同日の項目で GA と書き、Google Cloud のモデルのページも提供段階を GA としています。既刊の発表の記事で「まだ分からないこと」に挙げた、API の公開日、モデル ID、コンテキストの長さ、導入価格の期間が、これで公式の資料に載りました。移行の前に見ておく点は、トークン単価が12月に倍になることだけではありません。明示キャッシュは使えず、temperature などは送っても無視され、タイムアウトの推奨は長く、使える場所も契約ごとに分かれます。
Gemini API か Google Cloud で Gemini を呼んでいて、Argon への切り替えを考えている開発者に向けて書きます。GitHub Copilot や AI Gateway からモデルを選ぶ方にも、使える場所の節が関係します。筆者は AI モデルの API 仕様と提供条件を公式資料と照らして追っていて、本稿は Gemini API と Google Cloud の docs、Google・GitHub・Vercel の発表、Gemini CLI と Antigravity CLI の issueを10月14日の朝(日本時間)に取得して突き合わせました。発表時の内容は既刊の記事にまとめてあります。性能値と、処理の品質の比較には踏み込みません。
既刊で「まだ分からない」とした点
- 公開日とモデル ID:10月13日に GA になり、モデル ID は gemini-4-argon です。
- コンテキストの長さ:Gemini API の最新モデルのページによると、入力・思考・出力は同じ1,048,576トークンの窓を共有します。出力だけで100万トークンを使えるのではなく、入力の分だけ減ります。
- 導入価格の期間:Google の発表ブログの脚注は、導入価格が11月30日までで、その後は入力 $4・出力 $20 だと書いています。
トークン単価は12月1日にすべて倍になる
Gemini API の料金のページによると、標準の単価は100万トークンあたり、入力が $2.00(12月1日から $4.00)、出力が思考のトークンを含めて $10.00(同 $20.00)、キャッシュが $0.10(同 $0.20)です。キャッシュの割引は発表ブログの「95%引き」のままで、基準の入力単価と一緒に倍になります。
Batch・Flex・Priority も、入力・出力・キャッシュの単価がそれぞれ12月1日から倍になります。
同じ料金のページは、Free 層と Google AI Pro のプランでは Gemini API から Argon を使えないと注記しています。12月1日以降の標準単価は、Anthropic の料金のページにある Claude Opus 5.5 の入力 $4・出力 $20・キャッシュ読み取り $0.20 と同じです。
移行で扱いが変わる指定
Gemini API の最新モデルのページにある移行のチェックリストと、Google Cloud の docs を合わせると、これまでの指定の扱いは次のように分かれます。
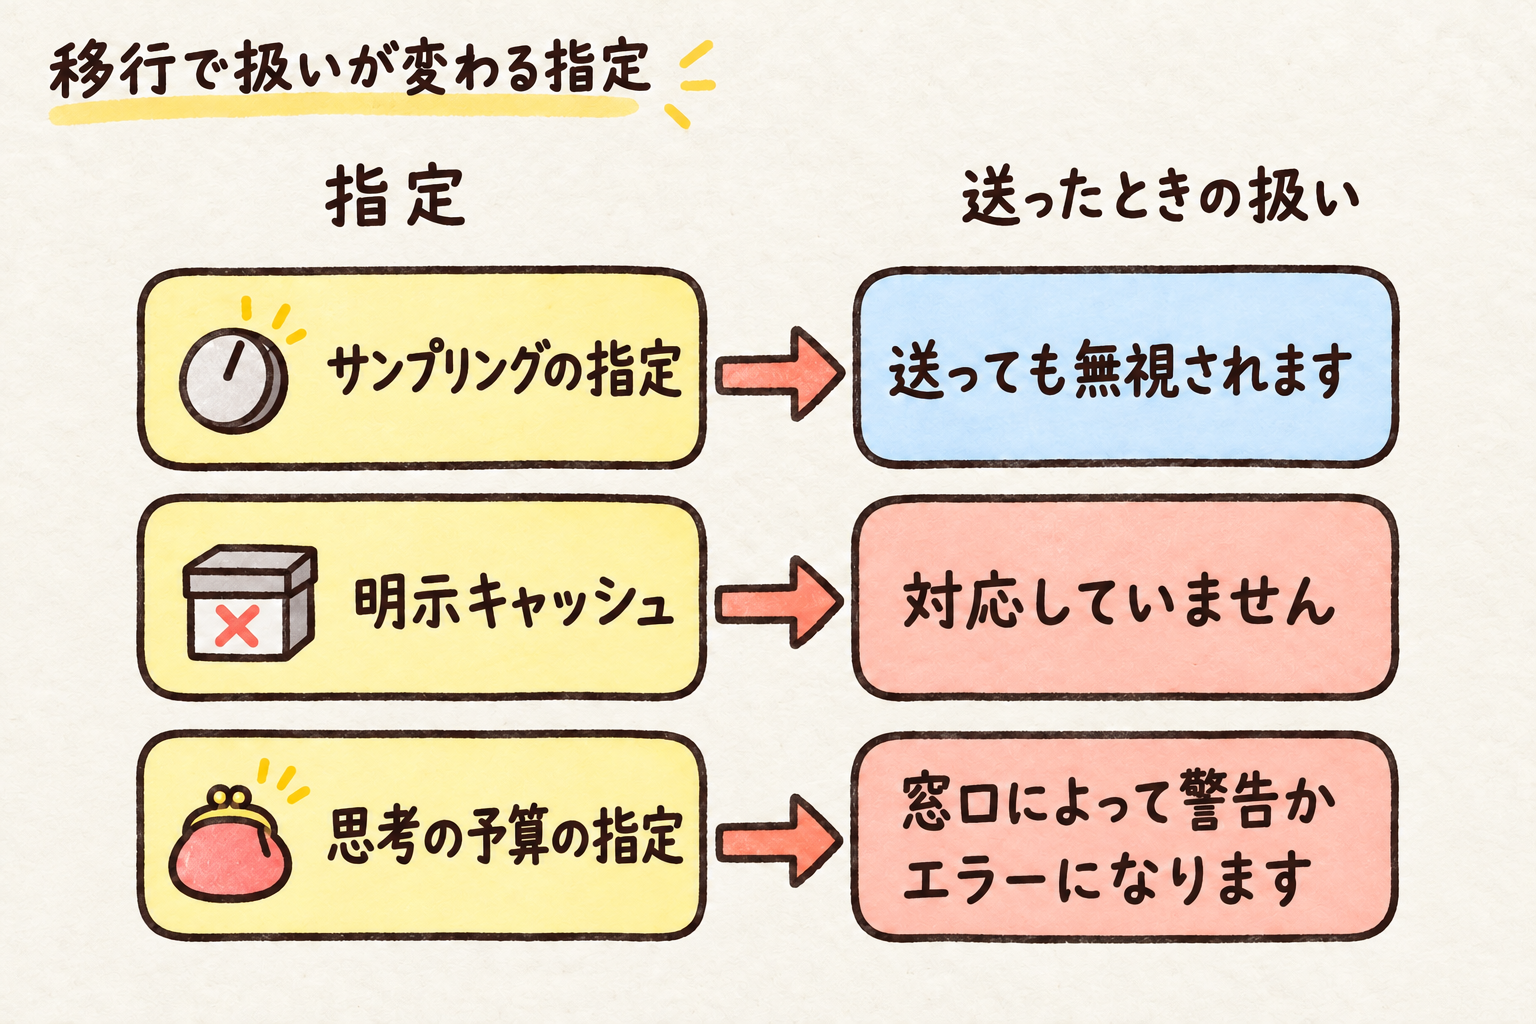
Gemini API の最新モデルのページ・long decode のページと Google Cloud の docs に基づく図です。サンプリングの指定は、どちらでも送ってもエラーにならず無視されます。思考の予算の指定は、Gemini API の docs では thinking_budget が警告(minimal や thinking_level との同時指定はエラー)、Google Cloud の docs では HTTP 400 と書かれています。明示キャッシュの代わりに使える暗黙キャッシュは、対象になる下限が呼ぶ窓口で違います。
- サンプリングの指定:送っても無視されます。Gemini API の最新モデルのページは temperature・top_p・top_k を外すよう案内し、送っても無視されると書いています。Google Cloud の開発者ガイドも同じ扱いです。エラーにならないので、値を調整していた呼び出しは、効いていない前提で見直すことになります(筆者の整理)
- 明示キャッシュ:対応していません。最新モデルのページは cachedContents と caches.create を使う呼び出しを外すよう案内しています。残るのは暗黙キャッシュで、Gemini API のキャッシュのページによると、対象は4,096トークン以上のプロンプトです。Interactions API でヒットした分は応答の usage.total_cached_tokens で数えられます。Google Cloud のモデルのページは暗黙キャッシュの最小を6,144トークンとしていて、同じモデルでも呼ぶ窓口で下限が違います
- 思考の予算の指定:窓口によって警告かエラーになります。Gemini API の long decode のページは、thinking_budget に警告が出て、Argon は無視するか対応づけると書き、thinking_level の minimal と、thinking_budget を thinking_level と同時に指定したときはエラーだとしています。Google Cloud のモデルのページは、thinking_budget と thinking_level の MINIMAL に HTTP 400 を返すとしています。思考の深さは、どちらの docs も low・medium・high の3段で、既定を medium としています
Google Cloud の開発者ガイドは、このほかに frequency_penalty・presence_penalty・candidate_count の指定も HTTP 400 になると書いています。
出力と待ち時間の指定も変わります。最新モデルのページは、max_output_tokens を32K未満に設定している既存のアプリでは32,768以上にするよう案内しています。Argon は以前のモデルより上限の多くを思考に使うことがあり、トークンを減らしたいときは thinking_level を下げるよう書いています。65,536トークンを超える出力は、Interactions API なら background を true にして max_output_tokens を65,536より大きくするよう案内されています。long decode のページによると、generateContent ではモデル ID を変えるだけでは long decode は有効にならず、継続を自動で行うには各言語の SDK が所定の版以降で、max_output_tokens を65,536より大きくする必要があります。古い版は自動で継続せず64Kで止まります。OpenAI 互換のエンドポイントでは long decode が使えず、出力は1回の上限で止まります。Google Cloud のモデルのページは、generateContent の long decode が v1beta1 の API だけで使える既知の問題を挙げています。
タイムアウトは資料で数字が違います。最新モデルのページは HTTP クライアントのタイムアウトを15分以上にするよう勧めています。long decode のページは、サーバーが非ストリーミングの接続を10分、ストリーミングを20分で閉じるとし、クライアントの読み取りタイムアウトを20分にするよう書いています。
使える場所と、まだ選べない場所
使える場所は次のとおりです。
- Gemini API と AI Studio:Google の開発者向けブログによると、Gemini API の有料層で Google AI Studio と Android Studio から使えます。Google AI Ultra の加入者は AI Studio でも試せます
- Google Cloud:モデルのページはリージョンを global・us・eu としています。Gemini CLI の PR #29737の投稿者は、global では動き、us-central1 では 404 になったと書いています
- Gemini アプリ:Gemini アプリのブログによると、Google AI Pro と Ultra の加入者が使えます
- Antigravity:Antigravity のブログによると、デスクトップアプリと CLI で、Google AI Ultra の加入者と対象の Gemini Enterprise の契約向けに展開されます。ブログの Gemini platform の API は企業向けの説明です
- GitHub Copilot:GitHub の changelogによると、Copilot Pro+・Max・Business・Enterprise が対象で、展開は順次です
- Vercel の AI Gateway:Vercel の AI Gateway の changelogによると、google/gemini-4-argon の名前で呼べ、Claude Code や Codex からも選べます
CLI の提供状況は、認証方式と取得時点を分けて確認します。
- Gemini CLI:Gemini CLI の issue #29689は Argon の登録を求める要望で、PR #29737 は取得した時点で open です。UTC の10月13日に出たv0.64.0とv0.65.0-preview.0のリリースノートに、Argon の項目はありません
- Antigravity CLI:Gemini API 認証について、Antigravity CLI の issue #1228は、Gemini API の環境で 1.3.4 に gemini-4-argon を指定すると未知のモデルとして扱われ、別のモデルに切り替わると報告しています。コメントには、Ultra のプランなら使えるとの返信があり、報告者は Gemini API でも使えるはずだと返しています
まだ分からないこと
- 暗黙キャッシュの有効時間:キャッシュのページに記載がありません。15〜20分と書いているのは、Gemini API の long decode のページ(キャッシュが使われないまま15〜20分たつと切れ、長い出力の途中で間が空くと入力が満額に戻る)と Google Cloud の開発者ガイドで、どちらも長い出力の続きの要求の説明の中です
- 非ストリーミングの実際の上限:long decode のページの比較表は、1要求あたりの時間制限を非ストリーミングの自前ループも含めて20分としていて、同じページの10分と合わず、ページからは決まりません
次にやること
移行の前に、自分のコードで次の順に探します。
- cachedContents と caches.create の呼び出しを探し、暗黙キャッシュに寄せます。Gemini API のキャッシュのページは、大きく共通する内容をプロンプトの先頭に置き、似た先頭の要求を短い間隔で送ると、ヒットしやすくなると書いています
- temperature・top_p・top_k の指定を探し、thinking_budget と minimal の指定も探します。後者は Google Cloud では 400、Gemini API では警告かエラーになります。Google Cloud を呼ぶなら、frequency_penalty・presence_penalty・candidate_count の指定も探します。こちらは 400 になります
- max_output_tokens と、クライアントやゲートウェイのタイムアウトを見直します
費用は12月1日以降の単価で見積もり、小さい実タスクで1回あたりの費用と時間を測ってから決めると、トークン単価だけで比べる誤りを避けられます。エラーにならずに変わる指定を自分のコードで探す進め方は、有料の既刊「Opus 5 から 5.5 へ移る前に」が、Claude の移行を題材に扱っています。
参考になったら、記事下部のライクとXの共有ボタンから応援してもらえるとうれしいです。
 この記事の販売者