【重複購入のご注意】この記事は「ミオ|AI大好きな後輩」がnoteで販売している同名記事(安いモデルで実行し上位モデルでレビューする:Claude Codeのサブエージェントが実際に走ったモデルと月額を記録で確かめる)と同じ内容です。すでにnoteで購入・閲覧できる方は重複購入にご注意ください。
10月に入って、安い小型モデルの選択肢がそろいました。Anthropic の料金ページによると、Claude Haiku 5.5 は100万トークンあたり入力 $0.10・出力 $0.50 です(プロンプトが100,000トークン以下のとき)。OpenAI の GPT-6 Luna のページも入力 $0.1・出力 $0.5 で、DeepSeek の料金ページでは DeepSeek-V4.1-Flash がピーク外の時間帯に入力 $0.15・出力 $0.6 です。探索や決まった手順の作業は安いモデルに任せ、計画とレビューだけを上位のモデルに回す分担が、費用の面でとりやすくなりました。
ただ、設定しただけで費用が下がるとは限りません。Claude Code の issue #100082 の報告者は、定義に model: haiku や model: sonnet と書いたサブエージェントのうち、1,371本中1,149本が本体の Opus で動いていたと報告しています(2.1.277〜2.1.290、断続的)。報告者は、手元の記録に残った各サブエージェントの message.model を数えて気づきました。同じ報告によると、10月7日以降は設定どおりのモデルで動いていて、報告者はこの変化を説明する changelog の記載は無いとしています。
Claude Code でサブエージェントや advisor(上位のモデルへの相談)を使い、安いモデルに任せた役割が本当にそのモデルで動いているか、月にいくらかかっているかを知りたい開発者に向けて書きます。Pro・Max などのプランの方は、Claude Code の費用のページが書くとおり定価の金額は請求額ではないので、試算は役割ごとの使用量の比として読むことになります。
筆者は AI のモデルと開発ツールの仕様を公式資料と照らして追っていて、Haiku 5.5 の公開時には料金と Claude Code での扱いを無料記事にまとめました。本稿は、Claude Code のサブエージェント・advisor・費用・キャッシュ・モデル設定のページ、Anthropic・OpenAI・DeepSeek の料金表、関連する issue を2026年10月9日(JST)に取得して突き合わせ、完成例のスクリプトをダミーの記録に当てた結果をもとに書いています。
本稿の完成例は Claude Code の記録専用で(Python 3.9 以上、標準ライブラリだけ)、workflow のエージェントや Agent Teams のチームメイトの記録も役割の名前ごとに集計します。Codex や OpenCode の記録と、定価と違う単価(Batch の割引、fast mode とデータ所在地の割増、クラウド経由の単価)は扱いません。
公式の確認手段で分かること
サブエージェントのページによると、動いているサブエージェントのモデルは /tasks の行に出ます(v2.1.242 以降)。費用のページによると、/usage はセッションのトークンを定価で金額にし、モデル別の内訳も出します。
ただし /tasks で見えるのは動いている間と、終わってから30秒ほどだけで、/usage はいまのセッションの合計です。どちらも、サブエージェントごとに「設定したモデル」と突き合わせはしません。終わったあとに遡って、同じ設定で動かした期間について、どの役割が設定どおりのモデルで動き、月にいくらになるかを出すには、記録を読みます。サブエージェントのページによると、記録は ~/.claude/projects/{project}/{sessionId}/subagents/ に agent-{agentId}.jsonl として残り、既定では30日で消えます。取得したサブエージェントのページと費用のページには、記録の assistant の行(モデルと usage)の形式は書かれていません。
記録の usage をそのまま足すと、金額を誤ることがあります。Claude API の advisor tool のページによると、API の応答では advisor の分は usage のトップレベルに入らず、usage.iterations に advisor のモデル付きで別に載ります。記録の usage が API の応答と同じ形で残るなら、トップレベルだけを読むと上位のモデルでレビューした分が抜けます。完成例は、usage.iterations があればこの欄を読み、同じ応答の id が複数の行に出たときの重なりとは分けて数えます。
割り当てて、確かめて、試算する
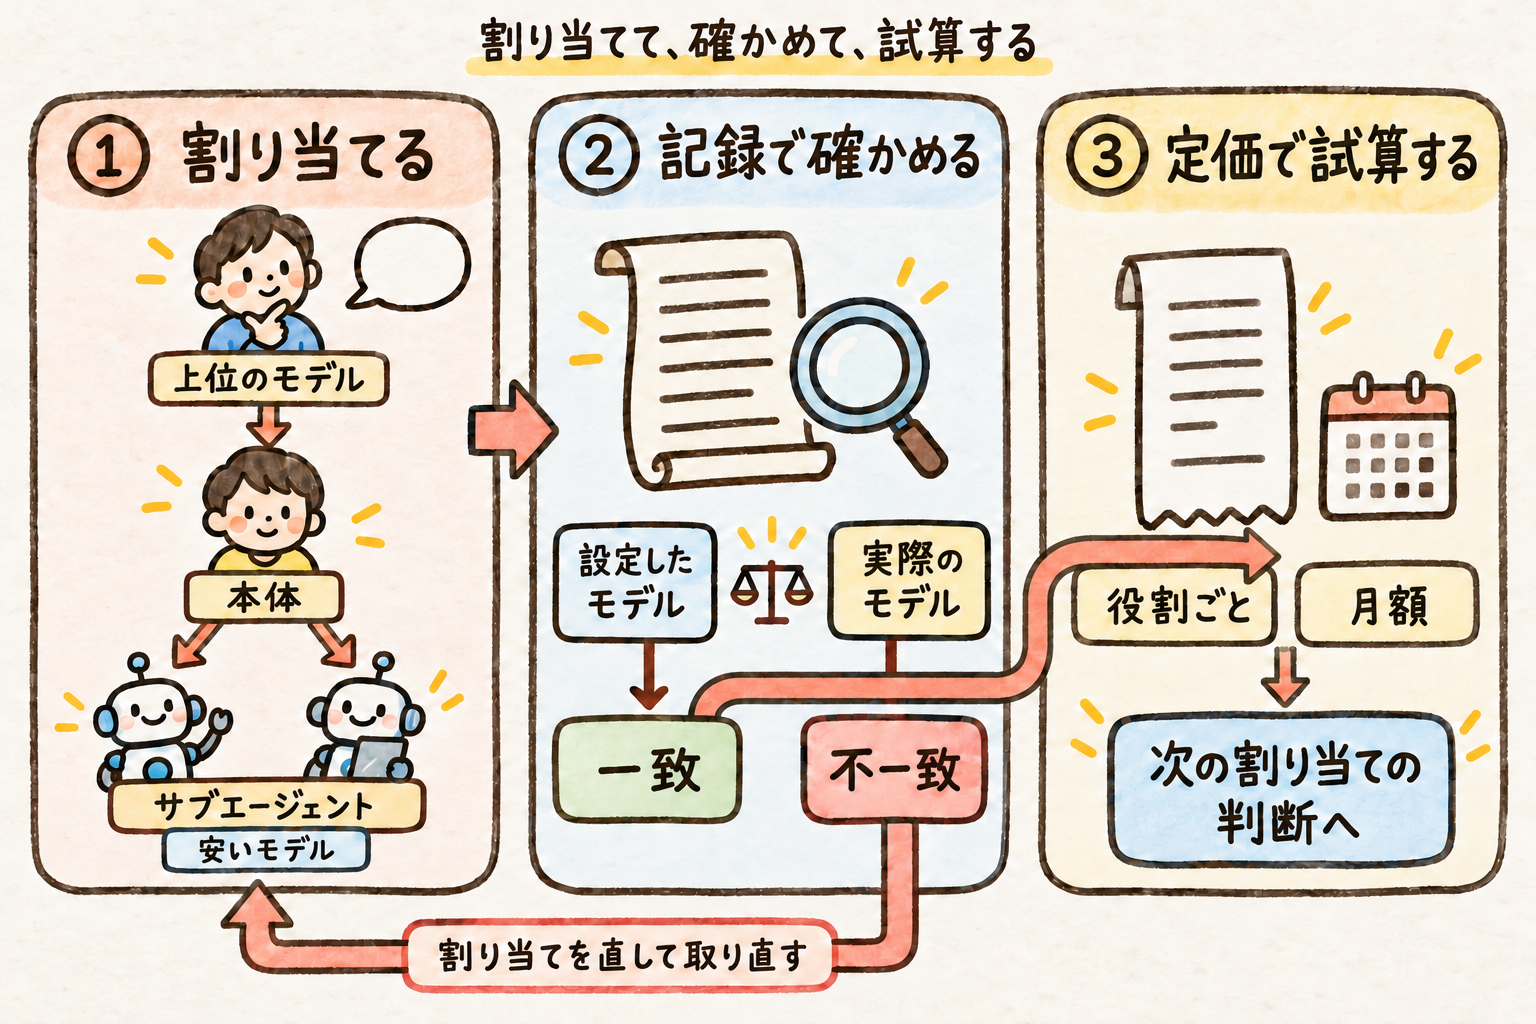
役割ごとにモデルを割り当て、記録で実際のモデルを確かめ、定価で役割ごとの月額を試算する3段の流れを描いた図です。段の分け方は筆者の整理です。②の「設定したモデルと実際のモデル」の突き合わせは、完成例が数えた実際のモデルを、定義・環境変数・呼び出し時の指定と人が見比べる手順を想定しています。月額は記録の期間で割って30日に換算した金額です(1日未満の記録は1日として割ります)。不一致のときは割り当てを直し、新しい記録で確かめ直します。上位のモデルは本体に置く形と advisor にする形があり、図は advisor の形で描いています。
本稿の手順は、役割ごとにモデルを割り当て、記録で実際のモデルを確かめ、定価で月額を試算する3段です(筆者の整理です)。実際のモデルが割り当てと食い違ったら、割り当てを直して記録を取り直し、確かめてから試算に進みます。
見本:完成例の出力
有料部のスクリプトは、記録を読んで、セッション・役割(サブエージェントの種類か本体)・実際に動いたモデルごとに、呼び出しの回数・トークン・定価の金額を並べます。決まった形で読めなかった行は金額に入れずに件数を出し、そうした行が1つでもあれば成功の終了コードにしません。下は、ダミーの記録(本体 Sonnet 5.5、advisor に Opus 5.5、サブエージェント5本)に当てた出力の一部です。5本目は synthetic の行だけなので、表には4本が出ます。
session    役割                     モデル                       回数         入力     キャッシュ読      書込5分     書込1時間        出力   検索        USD
s1         Explore                claude-sonnet-5-5          1       2000          0     10000         0       800    0    $0.0370
s1         implementer            claude-sonnet-5-5          2       1500      40000         0     40000     10000    0    $0.2670
s1         reviewer               claude-opus-5-5            1       1000          0      5000         0      1000    0    $0.0490
s1         scout                  claude-haiku-5-5           2       5000      99000     30000         0      1500    0    $0.0118
s1         本体                     claude-sonnet-5-5          3       2300      41000     21000         0      3500    0    $0.0962
s1         本体(advisor)            claude-opus-5-5            1      25000          0         0         0      1500    0    $0.1300
金額に入れていない異常 Explore              (不明)                   壊れた行 1
合計 $0.5909。記録の期間 2026-10-08T00:00:00+00:00 〜 2026-10-09T12:00:00+00:00、30日に換算すると $11.82(1日未満の記録は1日として割った)
結果: 異常の行 1・読めないファイル 0・金額に入れていない回 0 があります(終了コード 2)
この例では implementer の定義に model: haiku と書いた想定ですが、その行は本体と同じ Sonnet 5.5 になっています。設定どおりかを決めるのはスクリプトではなく、この「実際のモデル」の列を、定義・環境変数・呼び出し時の指定と見比べる人です。最後の結果の行の「異常の行 1」は、書きかけで壊れていた Explore の記録の最後の行です。
購入の前に、当てはまるかを確かめてください。有料部で渡すのは、この集計と、人が見比べるためのチェックリストで、設定どおりかを判定する機能はありません。また、次の行は、記録からそうなるはずのモデルを決められないので見比べの対象から外し、集計だけに使います。CLAUDE_CODE_SUBAGENT_MODEL_FORCE と CLAUDE_CODE_SUBAGENT_MODEL で1つのモデルにそろえていない workflow のエージェントと Agent Teams のチームメイト(workflow のエージェントは CLAUDE_CODE_WORKFLOW_SUBAGENT_MODEL を設定していれば見比べられます)、.meta.json が無く役割の分からない記録、複数の記録に重なる応答です。Claude が呼び出しで model を渡したかを本体の記録の呼び出しとつなげられない記録は、見比べを保留にします。金額は Claude API の定価で数えるので、Amazon Bedrock などを経由した記録や、DeepSeek などの別の接続先で動かした記録の金額は対象外です。
参考になったら、記事下部のライクとXの共有ボタンから応援してもらえるとうれしいです。
続きで読めるのは、次の3つです。1つめは、Claude Code でサブエージェントのモデルが決まる順と設定が効かない所(Explore と Plan、FORCE、プラグインの定義、advisor の組み合わせ、組織の availableModels による置き換え、呼び出し時に完全なモデル ID を渡せない報告、fallback による切り替え、モデルを切り替えたときのキャッシュ、DeepSeek へつないだときの振り替え)と設定例です。2つめは、記録からセッション・役割・実際のモデルごとに回数・トークン・定価の金額と30日換算を数えるそのまま使える Python のスクリプト(同じ応答の重複と、別の記録に写った同じ応答を1回だけ数え、advisor の分を advisor のモデルの定価で数える)と、その出力の読み方・反例を含む回帰検算です。3つめは、集計の「実際のモデル」を自分の定義・環境変数・呼び出し時の指定と見比べるチェックリスト(呼び出し時の指定を本体の記録や hooks で確かめる方法を含む)と、食い違ったときの直し方です。では、安いモデルに任せた役割が本当にそのモデルで動いたかを、どう確かめ、月にいくらと見積もればよいのか。
 この記事の販売者