Prompt CachingとBatch APIは足し算にならない? Claude APIコストを実際に計算して確かめる
AI実用ラボ
Claude APIの請求額を見て、「Prompt CachingとBatch APIを両方オンにすれば、割引が足し算されて大幅に安くなるはずだ」と考えて実装したのに、思ったほど下がらなかった——という状況は、実は公式ドキュメントに書かれている仕組みを読めば説明がつく。さらに計算してみると、条件によっては「下がらない」どころか「上がる」ことさえある。
Prompt CachingとBatch APIの割引は公式に「スタックする(重なる)」と明記されている ただしBatch内でのキャッシュヒットは「ベストエフォート」で30〜98%とばらつく 今回の条件で計算すると、ヒット率がおよそ53%を割った時点でCaching併用はBatch単体より高くつくTL;DR
Batch APIで50%引き、Prompt Cachingでさらに引き……って聞くと、単純に掛け算でどんどん安くなる気がしますよね
そう思いますよね。でも実際に計算してみると、ヒット率次第では『あれ、Batchだけのほうが安かった』ということさえ起こります
この記事でできること
【中級者向け】Claude APIの基本的な使い方(messages.createでのリクエスト送信)を知っている人向け。Prompt CachingとBatch APIそれぞれの単体の仕組みは前提知識として軽く触れるに留め、両者を組み合わせたときの挙動に絞って説明する。
- Prompt CachingとBatch APIの割引がどういう計算式で重なるのかが分かる
- 「ヒット率」という1つの変数でコストがどう動くか、逆転する境界まで含めて実際の数値で確認できる
- 自分のワークロードに当てはめて試算できるPythonの計算関数を持ち帰れる
対象読者
Claude APIをRAGや大量データ処理で使っていて、コスト最適化のためにPrompt CachingとBatch APIの併用を検討している人。すでにどちらか一方は使ったことがある前提で書く。
確認環境・確認日
- 確認日: 2026-09-19
- 対象: Claude API(価格例はClaude Sonnet 5を使用。他モデルの価格は記事末尾の早見表を参照)
- 情報源: platform.claude.comの公式Pricingページ、Prompt Cachingページ、Batch processingページ(すべて2026-09-19に取得・確認)
背景:なぜ2つの割引が同時に使えるのか
Prompt CachingとBatch APIは、そもそも割引の軸が違う。
- Prompt Caching:「同じ内容を何度も送るなら、2回目以降は安くする」という再利用に対する割引(キャッシュ読込は通常入力価格の0.1倍)
- Batch API:「今すぐ応答が要らないなら、まとめて非同期で処理する代わりに安くする」という処理方式に対する割引(全トークン一律50%引き)
公式のPricingページには、この2つについて「これらの乗数は、Batch APIディスカウントやデータレジデンシーなど他の価格修飾子とスタックする」と明記されている。つまり「再利用の割引」と「処理方式の割引」は別の掛け算として重なる設計になっている。
ただし、Batch processingページにはもう一つ重要な一文がある。「バッチリクエストは非同期・並行で処理されるため、キャッシュヒットはベストエフォートで提供される。ヒット率は通常30%〜98%の範囲になる」。ここが「思ったほど下がらない」の正体になる。
何が便利なのか
実際にどれくらい差が出るのか、以下の条件で試算した。
- 共有コンテキスト(RAGナレッジベースなど): 50,000トークン
- リクエストごとの固有クエリ: 200トークン
- 出力: 300トークン
- 100回のリクエスト、モデルはClaude Sonnet 5、キャッシュは1時間TTL
| 方式 | 内訳 | 合計コスト | 標準比 |
| 標準API | キャッシュもBatchも無し | $10.34 | 基準 |
| Batch APIのみ | 全トークン50%引き | $5.17 | -50.0% |
| Prompt Cachingのみ(ヒット率80%) | 書込20回+読込80回 | $5.14 | -50.3% |
| Prompt Cachingのみ(ヒット率99%) | 書込1回+読込99回 | $1.53 | -85.2% |
| Prompt Caching + Batch(ヒット率80%) | 上記をBatch単価に置換 | $2.57 | -75.1% |
ヒット率80%のPrompt Caching単体(5.14ドル)が、Batch単体(5.17ドル)とほぼ同じ金額になっているのが分かる。キャッシュの再利用が効いていても、書き込みコスト(1時間キャッシュなら通常の2倍)を何度も払っていると、削減効果が薄まってしまうためだ。
ヒット率80%でも結構高い数字だと思っていたんですが、それでもBatchだけとほぼ同じなんですね
はい。1時間キャッシュの書込は通常の2倍の値段なので、ミスが20%あると、そこで結構持っていかれるんです
どこまでヒット率が下がると損になるのか
ここがこの記事で一番伝えたいところで、上の表はヒット率80%という良い条件だけを見ている。公式が「30%〜98%」と書いている以上、下振れしたときに何が起きるかまで見ておく必要がある。同じ条件でヒット率だけを動かすと、次のようになる。
| ヒット率 | 書込回数 | Caching + Batch | Batch単体($5.17)との差 |
| 99% | 1回 | $0.77 | -$4.40 |
| 80% | 20回 | $2.57 | -$2.60 |
| 70% | 30回 | $3.52 | -$1.65 |
| 60% | 40回 | $4.47 | -$0.70 |
| 54% | 46回 | $5.04 | -$0.13 |
| 53% | 47回 | $5.13 | -$0.04 |
| 52% | 48回 | $5.23 | +$0.06 |
| 50% | 50回 | $5.42 | +$0.25 |
| 30% | 70回 | $7.32 | +$2.15 |
| 0% | 100回 | $10.17 | +$5.00 |
52%と53%の間で符号が反転している。これを下回ると、Cachingを併用したほうがBatch単体より高くつく。理由は単純で、1時間キャッシュの書込単価が通常入力の2倍だからだ。ヒットしなければその2倍を毎回払うことになる一方、Batch単体なら常に一律半額で済む。公式が示すヒット率の下限は30%なので、下振れしたときには実際に損をする範囲に入るということになる。
なお、この境界は連続的には動かない。書込回数は整数なので、1回分(今回の条件では約$0.10)ずつ階段的に変わる。さらにPythonのround()は偶数丸めなのでround(47.5)は48になり、ヒット率52.5%と52%は同じ結果になる。境界付近を見るときは、率ではなく書込回数で考えるほうが確実だ。
5分TTLを使えば書込単価は1.25倍に下がるので境界も下がるが、バッチ処理では5分で失効してヒット率そのものが落ちるため、単純に有利とは言えない。このトレードオフを自分の数字で確かめるために、後述の計算関数を使ってほしい。
効果が薄いだけならまだしも、高くなることがあるのは想像していませんでした
「割引がスタックする」は本当ですが、スタックするのは単価の乗数です。書込の2倍もそのまま乗ってくるので、ヒットしなければ高い方の単価を半額で払い続けることになります
必要なもの
- Claude APIキー(本記事のコード例の実行に必要。この記事内では実際のAPI呼び出しは行っていない)
- Python 3系とAnthropic Python SDK
- 自分のワークロードのトークン数の見積もり(共有コンテキストのサイズ、リクエスト回数)
全体像
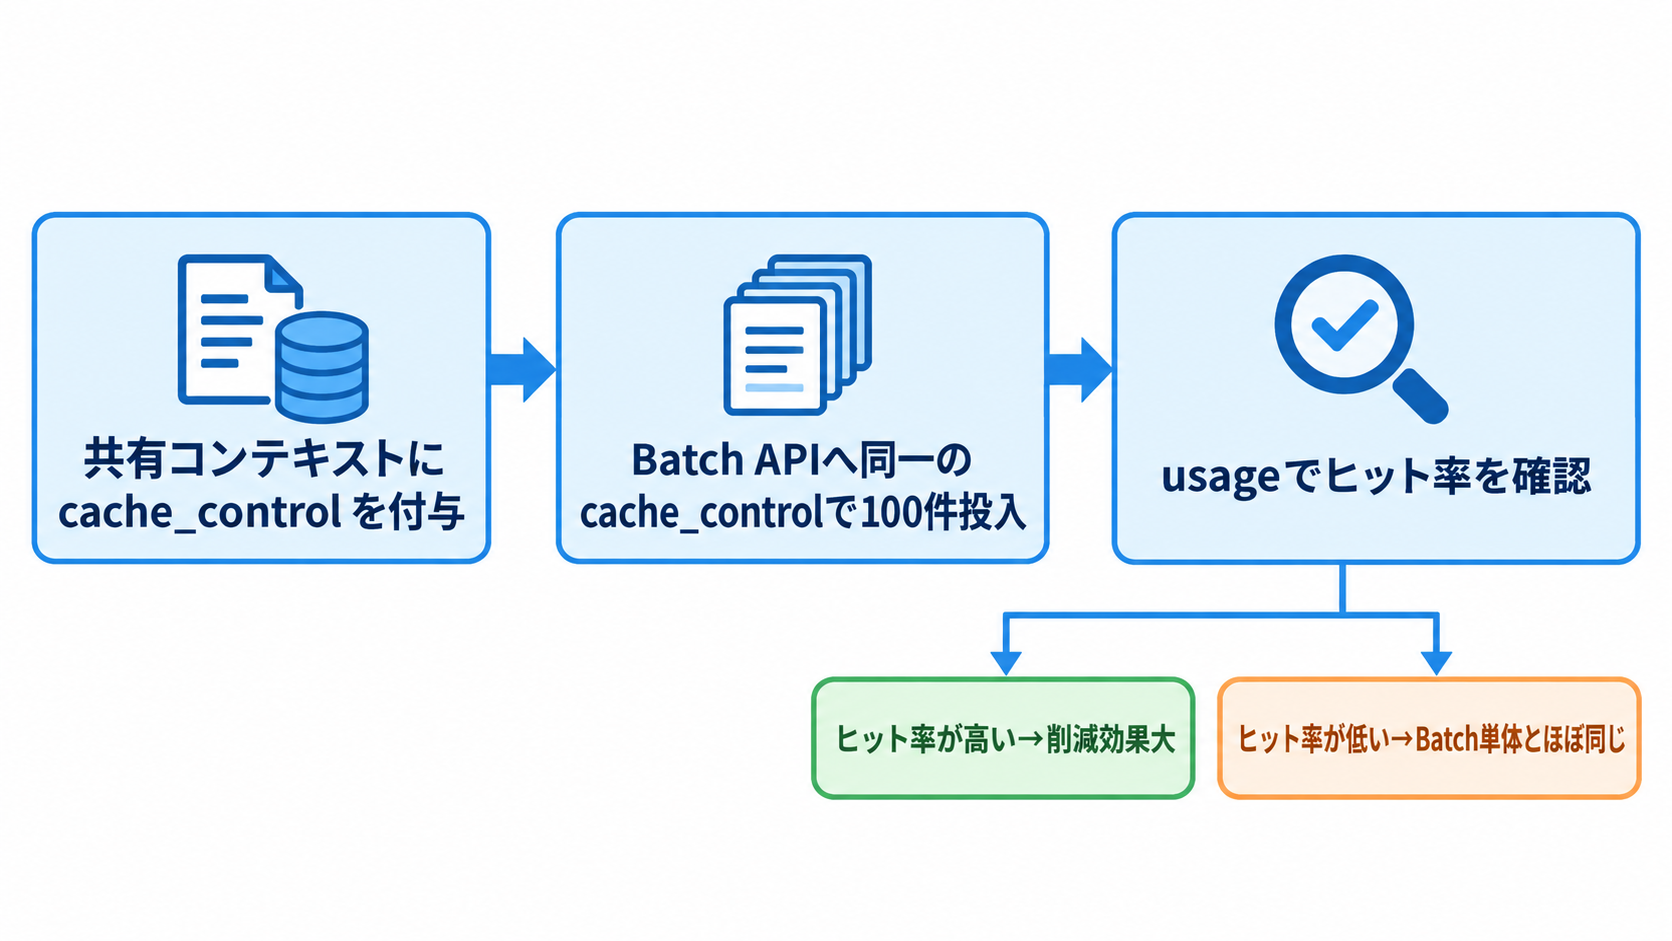
流れはシンプルで、次の3段階になる。
- 共有コンテキスト(システムプロンプトや長いナレッジベース)にcache_controlを付ける
- 同じcache_controlを含むリクエストをBatch APIへまとめて投入する
- レスポンスのusageフィールドでキャッシュヒットの実績を確認し、境界を上回っているか検証する
ここからは、実際のコード例、自分のワークロードで試算するための計算関数、ヒット率の実測方法、応用パターン、失敗したときの切り分け、早見表まで続けて見ていく。
具体的な使い方
Anthropic Python SDKでは、systemパラメータやmessagesの該当ブロックにcache_controlを付けるだけでキャッシュ対象を指定できる。Batch APIで使う場合も同様に、バッチ内の各リクエストへ同一のcache_controlを含める。
# 共有コンテキスト(RAGナレッジベースなど)をキャッシュ対象にする例
# 1時間キャッシュを使うのは、バッチ処理が5分以上かかることがあるため
# (公式ドキュメントもバッチ処理では1時間キャッシュを推奨している)
response = client.messages.create(
    model="claude-sonnet-5",
    max_tokens=300,
    system=[
        {"type": "text", "text": "あなたは社内ナレッジベースに詳しいアシスタントです"},
        {
            "type": "text",
            "text": knowledge_base_text,  # 50,000トークン級の長い共有コンテキスト
            "cache_control": {"type": "ephemeral", "ttl": "1h"}
        }
    ],
    messages=[{"role": "user", "content": query_text}]
)

# キャッシュが実際に効いたかはusageで確認する
print(response.usage.cache_creation_input_tokens)  # 新規に書き込んだトークン数
print(response.usage.cache_read_input_tokens)      # キャッシュから読み込んだトークン数
Batch APIで送る場合は、このsystemブロックをバッチ内の全リクエストで揃える。内容が1文字でも変わるとキャッシュキーが変わり、ヒットしなくなる点に注意する。
自分のワークロードで試算する
ここまでの表は特定の条件での試算なので、そのまま自分のケースに当てはまるわけではない。次の関数に自分の数字を入れれば、同じ計算式で試算できる。逆転の境界がどこに来るかもこれで確かめられる。
# 2026-09-19時点の公式Pricingページの値($/MTok)
PRICING = {
    "claude-sonnet-5":  {"input": 2.00, "cache_write_5m": 2.50,
                         "cache_write_1h": 4.00, "cache_read": 0.20, "output": 10.00},
    "claude-opus-5":    {"input": 5.00, "cache_write_5m": 6.25,
                         "cache_write_1h": 10.00, "cache_read": 0.50, "output": 25.00},
    "claude-haiku-4-5": {"input": 1.00, "cache_write_5m": 1.25,
                         "cache_write_1h": 2.00, "cache_read": 0.10, "output": 5.00},
}


def estimate_cost(model, shared_tokens, query_tokens, output_tokens, requests,
                  hit_rate=0.0, use_batch=False, ttl="1h", use_cache=True):
    """ワークロード1回分の概算コストをドルで返す。

    shared_tokens : 毎回同じ内容を送る共有コンテキストのトークン数
    hit_rate      : 0.0〜1.0。共有部分のうち読込にヒットした割合
    use_batch     : TrueならBatch APIの50%引きを全単価に適用
    use_cache     : Falseならcache_controlを付けないケース(毎回通常入力)
    """
    p = PRICING[model]
    if use_batch:
        p = {k: v * 0.5 for k, v in p.items()}

    if use_cache:
        write_key = "cache_write_1h" if ttl == "1h" else "cache_write_5m"
        writes = round(requests * (1 - hit_rate))
        reads = requests - writes
        shared = (shared_tokens * writes / 1_000_000 * p[write_key]
                  + shared_tokens * reads / 1_000_000 * p["cache_read"])
    else:
        shared = shared_tokens * requests / 1_000_000 * p["input"]

    query = query_tokens * requests / 1_000_000 * p["input"]
    output = output_tokens * requests / 1_000_000 * p["output"]
    return shared + query + output
この関数で、記事中の表をそのまま再現できる。
W = dict(model="claude-sonnet-5", shared_tokens=50_000,
         query_tokens=200, output_tokens=300, requests=100)

batch_only = estimate_cost(**W, use_batch=True, use_cache=False)
print("Batch単体: $%.2f" % batch_only)   # Batch単体: $5.17

for h in [0.99, 0.80, 0.70, 0.60, 0.54, 0.53, 0.52, 0.50, 0.30, 0.0]:
    v = estimate_cost(**W, hit_rate=h, use_batch=True)
    print("%5.0f%%  $%6.2f  %+.2f" % (h * 100, v, v - batch_only))

#   99%  $  0.77  -4.40
#   80%  $  2.57  -2.60
#   70%  $  3.52  -1.65
#   60%  $  4.47  -0.70
#   54%  $  5.04  -0.13
#   53%  $  5.13  -0.04   ← ここまでは安い
#   52%  $  5.23  +0.06   ← ここから高くなる
#   50%  $  5.42  +0.25
#   30%  $  7.32  +2.15
#    0%  $ 10.17  +5.00
shared_tokensを自分のナレッジベースのサイズに、requestsを1日あたりの処理件数に置き換えれば、導入前におおよその金額と境界が見える。hit_rateだけは実測するまで分からないので、まずは公式が示す下限の30%を入れてみて、それでも割に合うかを見るのが安全だ。
動作確認:実際のヒット率を測る
試算は仮定の数字なので、実装したら必ず実測する。各レスポンスのusageに書き込みトークン数と読込トークン数が入っているので、それを集計すればヒット率が出る。
def hit_rate_from_usages(usages):
    """messages.createのレスポンスusageを集めて、実測ヒット率を返す。"""
    created = sum(u.cache_creation_input_tokens for u in usages)
    read = sum(u.cache_read_input_tokens for u in usages)
    total = created + read
    if total == 0:
        return 0.0
    return read / total


rate = hit_rate_from_usages(collected_usages)
print("実測ヒット率: %.1f%%" % (rate * 100))

# 実測値を入れて、Cachingを続けるべきかを金額で判断する
with_cache = estimate_cost(**W, hit_rate=rate, use_batch=True)
batch_only = estimate_cost(**W, use_batch=True, use_cache=False)
print("Caching併用: $%.2f / Batch単体: $%.2f" % (with_cache, batch_only))
if with_cache > batch_only:
    print("→ cache_controlを外してBatch単体にしたほうが安い")
ここで見るべきは次の3点。createdとreadが両方0なら、そもそもキャッシュが有効になっていない(最小トークン数を下回っている可能性が高い)。readが0でcreatedだけ積み上がるなら、毎回キャッシュキーが変わっている。readは出ているが境界を下回るなら、キャッシュを外す判断を検討する。
usageを見るだけでヒット率が分かるのは助かりますね。ログに残しておけば、境界を割っていないかすぐ検証できそう
そうです。試算はあくまで試算なので、実際に送ってusageを確認するところまでがセットです
応用・実践パターン
パターンA:RAGナレッジベースの固定キャッシュ化
社内ドキュメントや製品マニュアルのような、更新頻度が低い大きめのコンテキストをRAGで毎回渡している場合、そのテキストをcache_control付きの固定ブロックとして分離する。ユーザーからの質問部分だけを非キャッシュ領域にすることで、同じナレッジベースへの問い合わせが続く限りキャッシュヒットが積み重なりやすくなる。ドキュメントを更新するタイミングでキャッシュ内容も変わる(=再度書込コストが発生する)ことは織り込んでおく。更新が頻繁なドキュメントだと書込が増えて境界を割りやすいので、更新頻度も判断材料になる。
パターンB:夜間バッチでの多言語翻訳
同一の翻訳ガイドライン(トーン、用語集、フォーマット指定など)をsystemに固定し、翻訳対象の文章だけをmessages側に入れてBatch APIへ流す運用。即時応答が不要な夜間バッチ処理と相性がよい。ただし翻訳ガイドラインが数千トークン程度だと、共有部分が小さい分だけキャッシュの効果も小さくなるので、先の関数でshared_tokensを実際のガイドラインサイズにして境界を確かめておく。
パターンC:Batchから先に入れて、実測してからCachingを足す
2つを同時に入れると、効果が出なかったときにどちらが原因か切り分けられなくなる。Batch APIは全トークン一律50%引きでヒット率のような変動要素がないため、先にBatchだけを入れると削減幅が確実に読める。そのうえでcache_controlを足し、usageで実測ヒット率を見る。この順番なら「Cachingを足した分でいくら下がったか」が差分として明確に出るので、境界を割っているケースにもすぐ気づける。即時応答が必要でBatchが使えないワークロードでは、逆にCachingだけを先に入れて同じように差分を見る。
これ、ナレッジベースが小さいと、そもそもキャッシュにするメリット自体が薄いってことですよね
そうですね。今回の試算も共有コンテキストが50,000トークンある前提です。共有部分が数百トークン程度なら、キャッシュの書込コストの方が相対的に重くなるので、まずは自分のワークロードのトークン数を見積もるのが先です
うまくいかないときの切り分け
cache_read_input_tokensがずっと0のまま
キャッシュ自体が有効になっていない状態。最初に疑うのは最小トークン数で、キャッシュ対象ブロックがこれを下回るとエラーにはならず黙って無視される。Claude Sonnet 5は1,024トークン、Opus 5は512トークン、Haiku 4.5は4,096トークンが下限なので、モデルを変えた直後に効かなくなったときはここを確認する。下限は満たしているのにcache_creation_input_tokensだけが毎回積み上がる場合は、キャッシュキーが毎回変わっている。systemブロックに現在時刻やリクエストIDのような動的な値が紛れ込んでいないか、文字列を直接比較して確かめるのが早い。
ヒット率が境界を下回っている
読込自体は発生しているが割合が低い場合は、まずTTLの失効を疑う。既定の5分キャッシュは、バッチ処理のように全体で数十分かかる処理とは相性が悪く、後半のリクエストが実行されるころには失効している。公式ドキュメントもバッチ処理には1時間キャッシュを推奨しており、ttlを"1h"にするだけで改善することが多い。それでも境界を下回るなら、キャッシュを外してBatch単体にするのが正しい判断になる。「入れられる機能は全部入れる」が損になる数少ない例である。
Cachingを足したのに安くならない
この記事の主題そのもので、多くはヒット率が低いか、共有コンテキストが小さいかのどちらか。実測ヒット率を出したうえでestimate_costにその値を入れ、use_cache=TrueとFalseの2パターンを比較すれば、キャッシュを続けるべきかが金額で判断できる。なお、バッチ処理ではmax_tokens: 0によるキャッシュの事前ウォームアップが使えない。非同期実行のため、書き込んだキャッシュが後続リクエストの実行前に失効する可能性が高いことが理由として公式に説明されている。
注意点・制限事項
- バッチ内でのキャッシュヒットはベストエフォートで、公式ドキュメントでは30%〜98%とかなり幅がある。下限の30%はこの記事の条件では逆転の境界を割っており、損をする範囲に入る
- 境界は共有コンテキストのサイズや出力トークン数によって変わる。記事中の「52〜53%」は「共有50,000トークン・クエリ200・出力300・100回・Sonnet 5・1時間TTL」という条件下の値であり、普遍的な基準値ではない
- バッチ処理ではmax_tokens: 0によるキャッシュの事前ウォームアップが使えない
- キャッシュが有効になる最小トークン数はモデルによって異なる(Claude Sonnet 5は1,024トークン以上、Opus 5は512トークン以上、Haiku 4.5は4,096トークン以上)。これ未満のコンテキストにcache_controlを付けても、エラーにはならずただキャッシュされないだけなので気づきにくい
- 本記事のコスト試算は、公式が公表している各価格乗数をそのまま掛け合わせた当ラボの計算であり、Anthropicが公式に発表した削減率の数値ではない
- 記事内のコード例は構文と計算ロジックを示すためのもので、実際のAPI呼び出しによる動作確認は行っていない
早見表
| モデル | 通常入力 | 5分キャッシュ書込 | 1時間キャッシュ書込 | キャッシュ読込 | 出力 | Batch入力 | Batch出力 |
| Claude Sonnet 5 | $2/MTok | $2.50/MTok | $4/MTok | $0.20/MTok | $10/MTok | $1/MTok | $5/MTok |
| Claude Opus 5 | $5/MTok | $6.25/MTok | $10/MTok | $0.50/MTok | $25/MTok | $2.50/MTok | $12.50/MTok |
| Claude Haiku 4.5 | $1/MTok | $1.25/MTok | $2/MTok | $0.10/MTok | $5/MTok | $0.50/MTok | $2.50/MTok |
設定値と確認項目は次のとおり。
| 項目 | 値・確認方法 | 補足 |
| キャッシュ指定 | cache_control: {type: ephemeral, ttl: 1h} | systemまたはmessagesの該当ブロックに付ける |
| TTLの選択 | 5m(既定) / 1h | バッチ処理は1hが公式推奨。1h書込は通常入力の2倍 |
| 最小トークン数 | Sonnet 5: 1,024 / Opus 5: 512 / Haiku 4.5: 4,096 | 下回ると無言で無視される |
| 書込量の確認 | usage.cache_creation_input_tokens | 毎回積み上がるならキャッシュキーが変動している |
| 読込量の確認 | usage.cache_read_input_tokens | 0のままならキャッシュが効いていない |
| バッチのヒット率 | 30%〜98%(公式記載のばらつき) | ベストエフォートで保証はされない |
| 事前ウォームアップ | バッチでは使用不可 | max_tokens: 0 は非同期実行と相性が悪い |
まとめ
- Prompt CachingとBatch APIの割引は公式に「スタックする」と明記されているが、スタックするのは単価の乗数であり、書込の2倍もそのまま乗ってくる
- 今回の条件ではヒット率52〜53%の間で符号が反転し、これを下回るとCaching併用はBatch単体より高くつく
- 公式が示すヒット率の下限は30%なので、下振れしたときに損をする可能性を前提に設計する
- usageのcache_read_input_tokensで実測ヒット率を出し、境界を上回っているかを金額で確認する
- 共有コンテキストが大きく、内容が安定しているワークロードほど恩恵が大きい
- Batchを先に入れてからCachingを足すと、効果を差分で確認できる
 この記事の販売者