1. その担当者、元の発言と合っていますか
PythonとClaude APIを扱える業務自動化担当者向けです。
機械で引用の所在を確かめた後、すべての決定事項について、担当者・期限・決定内容が元の発言と対応するかを人が確認してから議事録を確定します。
架空の会議を例に考えてみます。
会議後、AIが「担当者:Aさん、期限:明日」と整理しました。
名前も日付もそろっています。
ところが元の発言を開くと、担当も期限も違っていました。
一覧の書式だけを確かめても、この誤りには気づけません。
JSONで返ってきた場合も同じです。
どこで確認が抜けるのか、元の発言と一緒に追ってみましょう。
AIに議事録を作らせたら、担当者名とか期限がすごく整った形で出てくるんですけど、これって信じていいんですか?
形が整っていることと、内容が正しいことは別なんだ。Structured Outputsが保証するのはJSONの"形"だけで、担当者名や期限が本当にその発言にあったかは別に確かめる必要がある。
元の発言は「今回はAさんではなく、Bさんが担当します。
期限はまだ決まっていません」でした。
正しく整理するなら、担当者はBさん、期限は未確認です。
もしAIがこの発言をquoteへそのまま引用していても、ownerがAさんなら担当者は誤りです。
引用は実在するのに、抽出した値と発言の意味が対応していないからです。
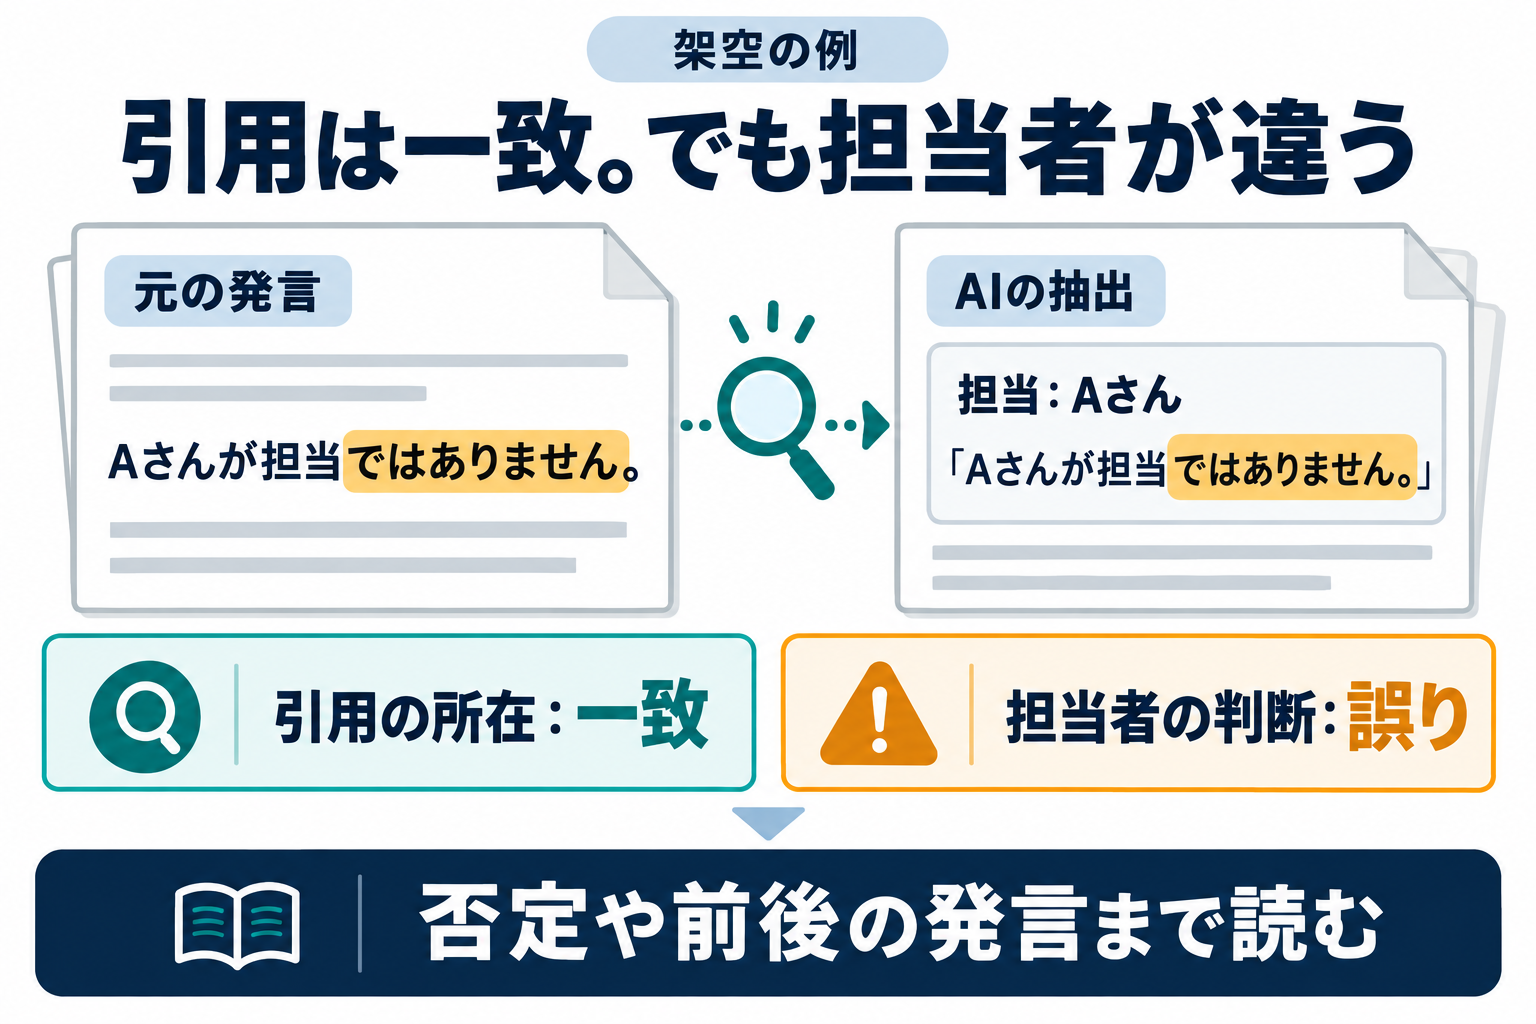
この架空例なら、二つの確認が必要です。
機械は「この引用が指定した行にあるか」を調べ、人は「誰が担当になったか、期限は決まったか」を読み取ります。
後半のPython例では、まず引用の不一致を見つけます。
その後、一致した項目も含めて内容確認待ちとして残し、人が確かめる箇所を整理します。
この記事は、JSON Schemaを読み書きし、Pythonの基本文法が分かる方を対象に、Structured Outputsでの抽出例と、引用を原文の指定行に照合するPython関数を提供します。
Claudeのチャット画面だけで完結する手順ではありません。
第6章の架空データを使う引用照合例は、Pythonだけで確認できます。
第4章のAPI抽出を試す場合は、anthropicパッケージ、APIキー、対応モデルへのアクセスとAPI利用料金が必要です。
まず架空データで照合の範囲を理解し、その後にAPI抽出を組み合わせてください。
Structured Outputsは返答を指定のJSON形式に整える機能、Citationsは回答へ資料の引用情報を添える機能です。
Claude APIでは、この二つを同じ応答で同時に有効化する組み合わせに制限があります。
Structured OutputsはJSONの厳密準拠を支えますが、Citationsは根拠一節を引用するための出力構造を必要とします。
その構造要件がぶつかり、同時併用するとAPIが400エラーになります。
この制約は、Claude APIのCitations機能と厳密JSON出力の組み合わせに関するものです。
JSONの中にquoteや行番号を自分で設ける設計は、後述のとおり利用できます。
では、どう動けばよいのでしょうか。
まずは「AIが出した担当者と期限が本当に発言にあるか」を、文字起こし側に紐づけて確認できるようにします。
Structured Outputsで抽出した結果に対して、行番号と引用文の一致を機械で調べます。
検出できるのは引用の不在や不一致です。
引用が実在しても、別の人の担当を結び付けたり、否定された期限を採用したりする誤りは残ります。
引用に問題がある項目を先に見つけ、確認の順番を決められます。
一致した項目も、内容の確認が終わるまでは確定扱いにしません。
失敗パターンも先に押さえておきましょう。
たとえば、抽出結果がJSONで整っていても、担当者名や期限が文字起こし内に存在しない場合があります。
そのとき対処を先送りすると、後で根拠を探す負担だけが増えます。
そこで、抽出スキーマに“検証用の情報”(発言行番号や逐語引用など)を含め、生成後に照合して「存在する/しない」を分けます。
目指すのは、引用の所在と内容の確認状況を区別できる状態です。
照合で一致した項目も含め、担当者・期限・決定内容を原文と照らし、根拠が不足するものは「未確認」のまま残します。
2. 書式が整っていても内容は確定しない
Structured OutputsはJSONの形や必須項目、型を制約します。
ただし、拒否応答や出力上限による打ち切りでは、指定の形に合わない場合があります。
まず応答が正常に完了したかを確認します。
つまり、あなたが用意した JSON Schema に沿った“形”で返すことは強く支えられます。
しかし、そのフィールドの中身が、文字起こしの発言と一致しているかまでは保証されません。
担当者名や期限という“意味内容”は別問題なのです。
ここが肝です。
AIは自然言語を生成する仕組みなので、入力文脈に曖昧さが残っていると、そこを埋めるために“それっぽい補完”をします。
たとえば「誰がやるか」「いつまでに」が明示されないまま要約が進むと、AIは“会議らしい結論”を作ろうとする方向に寄りがちです。
そのとき出てくる数字や名前は、見た目は整っていても、実際には発言に存在しない可能性があります。
これが議事録で問題になる幻覚(hallucination)です。
よくある誤解として、「Structured Outputsを付けたのだから、担当者名と期限は正しい」と考えてしまう点が挙げられます。
ですが、公式ドキュメントの Structured Outputs は、応答が指定したJSON Schemaに厳密準拠することで、形式面の安全性を高める仕組みです。
形式が正しくても、意味が正しいとは限りません。
むしろ「無効なJSONやツール入力のようなアプリの破壊を防ぐ」ことに焦点が置かれています。
そこで、before/afterで対比してみましょう。
| 認識(よくある誤解) | 実際の仕様(大事な点) |
| Structured Outputs は、必須フィールドの値が“正しい事実”で埋まるので安心できる | 正常に完了した応答ではJSONの構文・必須項目・型を制約する。拒否や出力上限による打ち切りは別に確認する。値が発言と一致するかは保証されない。 |
| 担当者や期限がJSONで出てきたので、文字起こしに必ず書かれているはず | JSON Schemaに沿っていても、意味が一致しているとは限らないため、文字起こし側との照合が必要 |
| Citationsを付ければ抽出結果の根拠も自動検証できる | Citationsは引用を返すが、Structured Outputsと同時に使えない(APIが400)。同時併用で“一発完結”はできない |
この表を踏まえ、抽出した値から原文の根拠へ戻れる形を作ります。
機械が確認するのは引用の所在で、値の正しさは人が文脈を読んで判断します。
照合用の手掛かりを出力に残しておきましょう。
では、どうやって幻覚(hallucination)を減らし、検出しますか。
公式が挙げる考え方の中に、「わからない場合は分からないと言ってよい」「長文では先に逐語引用(direct quotes)を抜き出してから回答させる」「引用が見つからない主張は撤回させる」といった方向性があります。
ここでポイントは、“生成後に撤回・検証できる導線”を持たせることです。
Structured Outputsだけで真偽を担保しようとすると、形式と意味のギャップに踏み込めません。
さらに、議事録のような情報抽出では、入力が曖昧であってもアウトプットが求められがちです。
たとえば「検討します」「追って連絡します」「できたら今月中に」という表現があると、AIは期限として日付を補おうとします。
しかし、文字起こしに日付が存在しなければ、それは幻覚になり得ます。
だからこそ、期限フィールドには「発言に基づく根拠」を紐づけるべきです。
次に、開発上の実務に落とすために考えるべき観点をまとめます。
第一に、JSON Schemaには「検証用フィールド」を含めます。
たとえば“担当者名”や“期限”だけでなく、対応する逐語引用(quote)や、どの行(行番号)にその根拠があるかを保持させます。
第二に、抽出後に検証を行います。
Structured Outputsが扱う形式、スクリプトが調べる引用の所在、人が読む発言の意味は、確認する対象が異なります。
引用の文字列一致だけでは、担当者・期限の正しさは判定できません。
そして、Citationsについても整理が必要です。
Citationsは、根拠となる原文一節を引用付きで返す仕組みですが、Structured Outputsと同時に使えません。
公式には「Citations and structured outputs are incompatible」と明記されており、両方を同時指定すると400エラーになります。
避けるのは公式Citationsと厳密JSONの同時指定です。
quoteという文字列フィールドをJSONに持たせる方法とは区別してください。
その代わり、手作業のプロンプト設計と、生成後の機械照合で置き換えます。
じゃあCitationsを一緒に使えば、根拠も自動でついてきて安心なんじゃないですか?
それが公式にできないんだ。CitationsとStructured Outputsは同時に指定すると400エラーになる。だから代わりに、quoteと行番号を自分でJSONに持たせて、あとで機械的に照合する設計にする。
抽出した各項目に引用と行番号を残すと、人が元の発言へ戻る手掛かりになります。
引用が誤っている場合や、複数の行を読まないと意味が分からない場合もあるため、前後の発言まで確認します。
もし根拠が見つからないなら、その項目は「未確認」として分離できます。
これにより、幻覚(hallucination)が紛れた場合でも、気づきにくさを減らせます。
引用と行番号を付ける目的は、元の発言を探せるようにすることです。
不一致の項目を見つけた後も、一致した項目を含めて全件の内容を確認します。
3. 引用と行番号で、元の発言へ戻れる形にする
まず結論から言うと、Structured OutputsとCitationsは併用不可です。Structured Outputsは output_config.format の json_schema により、応答を厳密なJSONスキーマに従わせます。
一方、Citationsは回答の中に“引用ブロック”をテキスト出力と混在させるため、応答構造が変わります。
そのため、同時に有効化するとAPIが400エラーを返す仕様になっています。
そこで本記事は、Citationsを同時指定せず、JSON内にquoteとline_numberを持たせる方針を採ります。
では、なぜ排他になるのでしょうか。
公式の説明の要点はこうです。
Citationsは、引用ブロックをテキスト出力にインタリーブする必要があり、その出力構造は、Structured Outputsが要求する“厳格なJSON制約”と両立しません。
言い換えると、Citationsが必要とする出力の組み立て方が、Structured Outputsの厳密なJSON要件とぶつかる、ということです。
排他性は偶然ではなく、構造の衝突として仕様化されています。
これをフローとして理解すると、迷いが減ります。
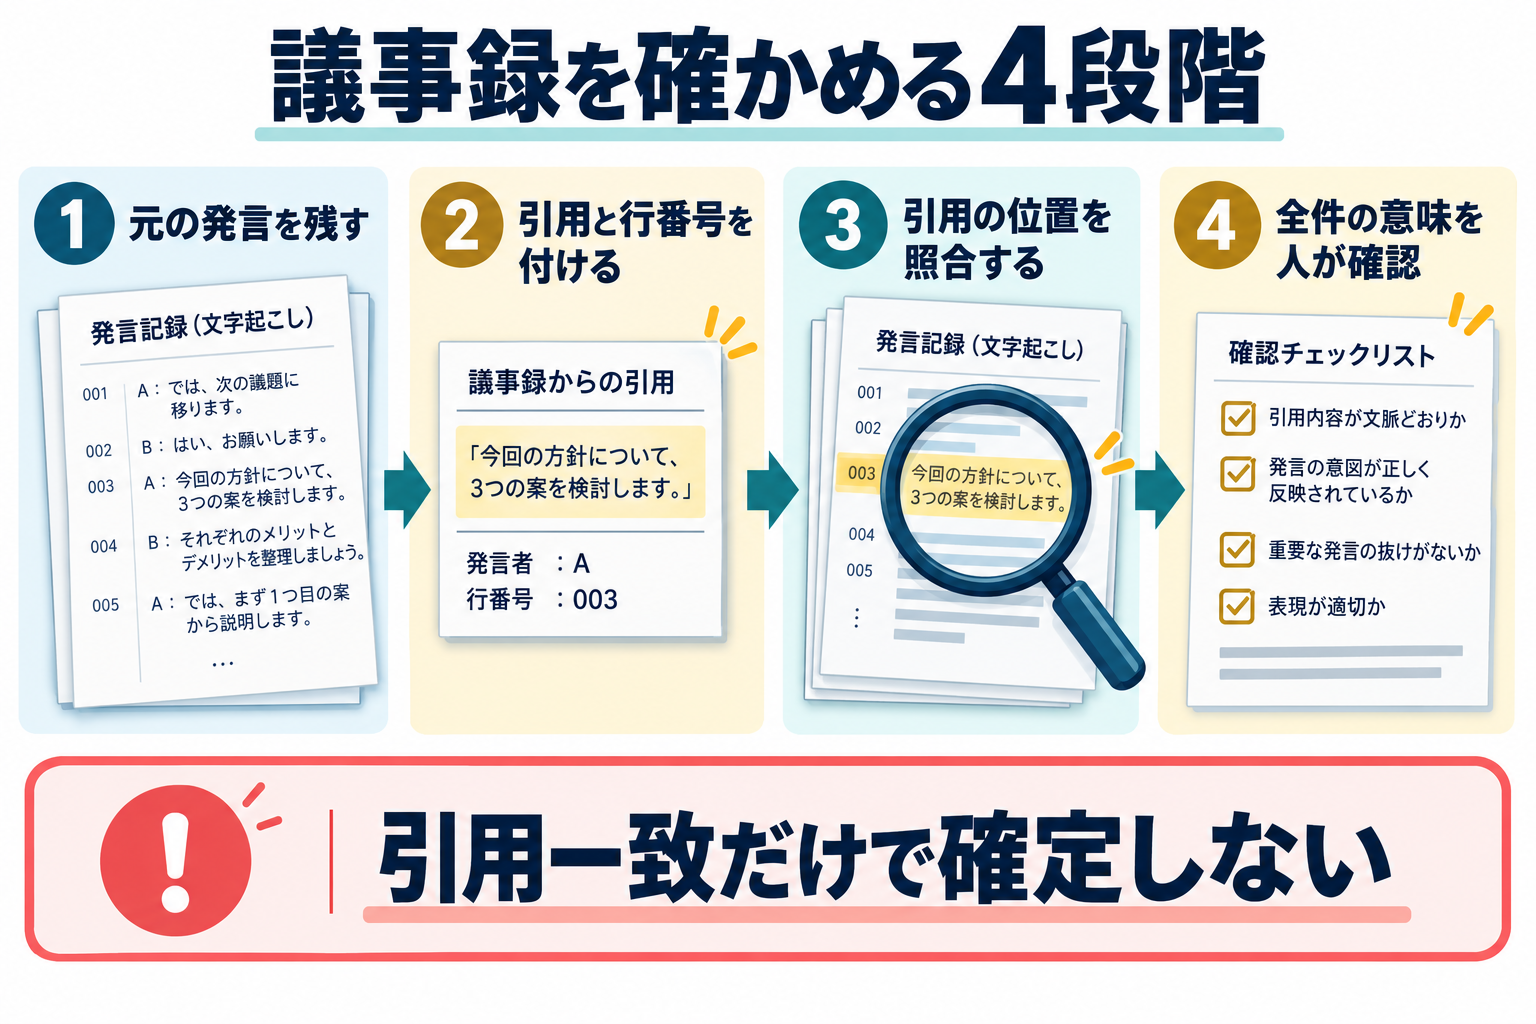
この図のポイントは、Citationsを“埋め込みで使う”のではなく、検証のための情報を最初からJSON抽出に組み込むところです。
Citationsが担っていた「引用を見せる」機能を、別の形式(逐語引用フィールド・行番号)で取り込みます。
その後、検証用スクリプトで実データとの突き合わせを行います。
それでは、実際の作業手順はどう組み立てるべきでしょうか。
第一に、抽出JSON Schemaを“検証可能な項目構造”にします。
quoteとline_numberを必須項目にしても、引用が実在するとは限りません。空欄や存在しない行番号、不一致の引用をプログラムで確認し、内容の判断は原文へ戻して行います。
第二に、生成後に照合処理を実行します。
行番号照合は考え方として単純です。
文字起こしを行単位に分割し、抽出結果が持つ行番号の行を取り出します。
次に、その行に quote が含まれているか(もしくは一致条件を満たすか)を判定します。
照合に失敗した項目は、引用の誤りや行番号のずれを先に確認します。
一致した項目も自動で正しいとは扱わず、すべての担当者・期限・決定内容を原文の前後関係と照合してから確定します。
第三に、失敗時の対応を決めます。
照合が失敗する代表パターンは、少なくとも次の3つです。
(1) 行番号が指す行に、quoteが存在しない(不一致)。
(2) 行番号は存在するが、文字列として一致条件を満たさない(表記ゆれ・抽出範囲のずれ)。
引用は1行から原文のまま抜き出します。
空の引用は入力不備として扱います。
短い引用でも文字が一致すればこの関数は一致と判定するため、それだけで担当者や期限を裏付けたことにはなりません。
ここで重要なのは、推測で埋めないことです。
わからない場合に「分からないと言ってよい」という考え方に沿って、人が該当箇所を確認できる状態にします。
最後に、注意点として“同時併用の罠”を再確認します。
Citationsは引用ブロックのために出力構造を変える必要があり、Structured Outputsが要求する厳密JSON制約と衝突します。
したがって、JSON抽出(Structured Outputs)と引用(Citations)を同じリクエストで一緒に取ろうとすると400エラーになります。
この排他性は、設計段階で織り込むべき要点です。
この記事の後半には、抽出用のJSON SchemaとAPI呼び出し例、引用・行番号を追加するスキーマ、架空の文字起こしと抽出JSON、引用を照合するPython関数を掲載しています。
引用不一致、期限の取り違え、APIの併用エラーを切り分ける確認手順も扱います。
抽出JSONに引用の手掛かりを残し、生成後に引用の所在を照合する。
さらに人が全項目の意味を確認する。
この順で、どの段階まで確かめたかを区別できるようにします。
最初は第6章の架空データをPythonへコピーし、引用一致2件・不一致1件という判定の意味を確認してください。
一致した2件も内容確認は必要です。
この教材で作れるのは、根拠の所在と確認待ち項目を整理する処理です。
担当者や期限を自動で確定する完成システムや、音声の文字起こし機能は含みません。
4. 決定事項・担当者・期限をJSONに取り出す
まずは架空の会議データで試してください。
実際の文字起こしには個人情報や社外秘が含まれることがあります。
組織の利用ルールと送信権限を確認し、不要な名前や機密情報を除いてから、送信が認められた内容だけを使います。
「議事録」をJSON Schemaで“型”から固める
会議の議事録を自動化する目的は、決定事項・担当者・期限を安定して抽出することです。
ところが、LLMは「それっぽい内容」を生成する方向に引っ張られるため、幻覚(hallucination)によって“実際には言われていない担当者名”や“存在しない期限”が紛れ込み得ます。
そこで、Claude APIの Structured Outputs を使い、`output_config.format` の `type: "json_schema"` と `schema` を与えて、応答をJSONの厳密な形に縛ります。
ただし重要なのは、Structured Outputsが保証するのは「意味の正しさ」ではなく「形式(構文・必須・型)」である点です。
Structured OutputsはJSONの形式を制約します。
ただし、公式資料では拒否応答や出力上限による打ち切り時に、スキーマに合わない応答が返る場合を説明しています。
正常なJSONを受け取った場合も、担当者・期限の意味は別に確認します。
ここまでが、正常に完了した応答の形式をそろえる段階です。
次に引用と行番号を加え、元の発言へ戻れるようにします。
必須項目と余分なキーを決める
次に、JSON Schemaの中心は `required` と `additionalProperties:false` です。`required` は「必ず返してほしいキー」を明示します。
requiredは指定したキーの存在を要求します。
ownerやdeadlineが文字列型でも、空文字や「未確認」は文字列です。
キーがあることと、担当者や期限が確定していることは区別してください。
また `additionalProperties:false` は、スキーマに書いていない余計なフィールドを禁止します。これにより、モデルが勝手に推測した補助情報(例:根拠の詳細や別の期限解釈など)を自由に追加しにくくなります。
結果として、後工程(検証や行番号照合)で扱うデータの範囲が固定され、解析が簡単になります。
さらに、旧 `output_format`(ベータヘッダ `structured-outputs-2025-11-13` 必須)との違いも明記しておきます。
資料では「Python SDK v1.0以降は `client.beta.messages.create()` に `output_format` を渡すと `TypeError` になる」とされています。
つまり、今から実装するなら `output_config.format` を使うのが前提です。ここを外すと、抽出ロジック以前にコードが動かなくなります。
実装例:決定事項・担当者・期限をJSON Schemaで抽出する
以下は、3項目だけを返す基本のAPI例です。不明なownerとdeadlineは「未確認」とし、相対的な期限表現はそのまま残します。引用照合まで進める場合は、先にこの例を実行する必要はありません。第5章の完成例ではquoteとline_numberも受け取り、第6章の関数へつなぎます。
- 決定事項は `decisions` 配列で返す
- 各要素は `item`(決定事項の内容), `owner`(担当者), `deadline`(期限)を必須にする
- 余計なキーを禁止する(`additionalProperties:false`)
- `deadline` は「日時そのもの」ではなく「期限表現(文字列)」として受け取る(文字起こしの表現に忠実にするため)
import anthropic
import json

client = anthropic.Anthropic()

transcript = """
[行1] では次の施策を決めます。
[行2] Aさんが明日までに調査レポートをまとめてください。
[行3] 次回のレビューは来週の木曜にしましょう。
[行4] Bさんはデザイン案を提出する担当でお願いします。
[行5] 期限は再来週の金曜日です。
"""

schema = {
    "type": "object",
    "properties": {
        "decisions": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {
                    "item": {"type": "string"},
                    "owner": {"type": "string"},
                    "deadline": {"type": "string"}
                },
                "required": ["item", "owner", "deadline"],
                "additionalProperties": False
            }
        }
    },
    "required": ["decisions"],
    "additionalProperties": False
}

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=900,
    messages=[
        {
            "role": "user",
            "content": (
                "次の会議の文字起こしから、決定事項・担当者・期限を抽出してください。"
                "決定事項に対応する担当者と期限が同じ発言の文脈にある場合は結びつけてください。"
                "担当者または期限が不明な場合、そのフィールドは文字列の「未確認」にしてください。決定していない事項を決定事項に含めないでください。「明日」「来週」などの期限表現を具体的な日付に変換しないでください。"
                "出力は指定したJSON Schemaに厳密に従ってください。"
            ),
        },
        {"role": "user", "content": transcript},
    ],
    output_config={
        "format": {
            "type": "json_schema",
            "schema": schema,
        }
    },
)

# 拒否や出力打ち切りを、正常な抽出結果として扱わない
if response.stop_reason != "end_turn":
    raise RuntimeError(f"抽出が正常完了していません: {response.stop_reason}")
text = next((block.text for block in response.content if block.type == "text"), None)
if text is None:
    raise RuntimeError("JSON本文がありません")
data = json.loads(text)
# JSONの形が整っていても、担当者・期限の原文確認は必要

print(data)
このコードの期待結果は、少なくとも次の性質を満たすことです。
- 応答は無効なJSONになりにくい(構文が壊れにくい)
- `decisions` キーが必ず含まれる
- 各決定要素には `item` / `owner` / `deadline` が必須
- `additionalProperties:false` により、余計なキーが勝手に増えにくい
失敗したときに何を確認するか(形式と意味の切り分け)
ただし、Structured Outputsは「幻覚(hallucination)の内容」を止める仕組みではありません。
たとえば、文字起こしの行に無い担当者名や誤った期限表現が入る可能性は残ります。
そこで失敗時は、次のように切り分けると早いです。
- 応答が正常完了したか:stop_reasonと本文の有無を先に確認します。拒否や出力打ち切りの場合は抽出結果を確定せず、原因を確認します。
- JSONを読めるか:正常終了でもjson.loadsが失敗したら処理を止め、応答と指定したスキーマを確認します。失敗した応答から推測で値を補いません。
- 意味が合っているか:JSONを読めても、全項目の担当者・期限・決定内容を元の発言へ照合します。quoteと行番号は、その確認箇所を探す手掛かりです。
- 期限が相対表現か:「明日」「来週の木曜」などは原文の表現を残します。具体日付への変換は、会議日と発言の意味を確認してから人が判断します。
ここで得た3項目のJSONには、照合に必要なquoteとline_numberがありません。次章では2項目を加え、そのスキーマを実際のAPI呼び出しに渡します。応答のJSONを読み込んだ後、同じ文字起こしを使って引用を照合します。
---
5. 抽出結果へ引用と行番号を加える
配布教材:引用照合デモとAPI接続例
ZIPにはREADME、通信なしで試せるverify_quotes_demo.py、API抽出から照合へつなぐapi_extract_and_check.pyが入っています。2つのPythonファイルを同じフォルダーに置き、READMEの順に進めてください。APIを使う段階では別途利用料がかかります。
なぜStructured OutputsとCitationsは同時に使えないのか
議事録の抽出でよくやりたいのが、「JSONで厳密に出す(Structured Outputs)」かつ「根拠の引用を添える(Citations)」という両立です。しかし結論から言うと、 Structured Outputs と Citations は併用できません。
公式ドキュメントでは次の趣旨で明記されています。
- 「Citations and structured outputs are incompatible」
- Citationsを有効にし、さらに `output_config.format`(または旧 `output_format`)を併用するとAPIが 400エラーを返す
- 理由は、Citationsが回答中に引用ブロックを“テキストに挟み込む”構造を要求し、それがStructured Outputsの“厳密なJSONスキーマ制約”と両立しないため
つまり、Citationsは「回答の途中に citation blocks を挿入する」方式です。
一方 Structured Outputsは「回答の全体を、指定したJSON Schemaの構造だけで埋める」方式です。
両者の出力形式が競合するため、同時指定ができないと考えてください。
ここを理解せずに実装を進めると、出力は欲しいがAPIエラーで止まる、という状態になります。
ですので設計段階で「JSON厳密抽出」と「根拠の提示」を別の層に分けます。
代替設計:quote(逐語)と行番号をJSON Schemaに入れる
Citationsを使えないなら、根拠の提示を別手段に置き換えます。
ここでの方針はシンプルです。
- JSON Schemaの各項目に、
- 根拠となる逐語引用(quote)
- 元発言の行番号(line_number)
を追加する
- そして後工程で、quoteが文字起こしの該当行に“本当に存在するか”を機械照合する
このやり方の根拠は、幻覚を減らす公式ガイドにあります。
そこでは、長文では先に本文から逐語の引用(direct quotes)を抜き出させて、その引用に基づいて回答させる手法が挙げられています。
また「引用が見つからない主張は撤回する」検証工程も推奨されています。Citationsが提供する“自動引用ブロック”の代わりに、アプリ側で逐語引用を取り出す設計にすることで、同じ方向性のガードレールを再現できます。
スキーマ変更例:quoteとline_numberを必須化する
次のコードが、引用付き抽出から照合までをつなぐ完成例です。教材のapi_extract_and_check.pyと同じ内容です。第6章の3コードを順にまとめたverify_quotes_demo.pyも同じフォルダーに置きます。まず第6章の通信なしのデモを試し、その後APIキーと公式Python SDKを準備して、python3 api_extract_and_check.pyを実行してください。第4章のAPI例を先に実行する必要はありません。
- `quote` は「根拠となる逐語の一節」を入れる(抽象的な要約ではなく、元文の一部)
- `line_number` は文字起こし側で付けた行番号(例:`[行2]` の2)
- `required` と `additionalProperties:false` を維持し、根拠情報の欠落を防ぐ
- 不明な場合に“推測で埋める”挙動を避ける(プロンプト側でも方針を明示し、後工程で未確認に回す)
例として、決定要素を次の形にします。
- `item`(決定事項)
- `owner`(担当者)
- `deadline`(期限表現)
- `quote`(逐語引用)
- `line_number`(該当行番号)
"""同じ行番号付き原文で、API抽出から引用照合まで進める教材。"""
import json
import os

from verify_quotes_demo import transcript_lines, verify_quotes

schema_with_evidence = {
    "type": "object",
    "properties": {
        "decisions": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {
                    "item": {"type": "string"},
                    "owner": {"type": "string"},
                    "deadline": {"type": "string"},
                    "quote": {"type": "string"},
                    "line_number": {"type": "integer"}
                },
                "required": ["item", "owner", "deadline", "quote", "line_number"],
                "additionalProperties": False
            }
        }
    },
    "required": ["decisions"],
    "additionalProperties": False
}


def extract_and_check(client):
    # APIへ送る原文と、引用照合で参照する原文を同じ辞書から作る。
    transcript = "\n".join(
        f"[行{number}] {text}"
        for number, text in sorted(transcript_lines.items())
    )
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=900,
        messages=[
            {
                "role": "user",
                "content": (
                    "次の会議の文字起こしから、決定事項・担当者・期限を抽出してください。"
                    "決定していない事項は含めず、不明な担当者と期限は文字列の「未確認」にしてください。"
                    "担当者や期限は前後の発言も確認し、決定事項との関係を推測で補わないでください。"
                    "「明日」「来週」などの期限表現は具体的な日付へ変換しないでください。"
                    "各項目にquoteとline_numberも付けてください。"
                    "quoteは根拠となる1行から文字を変えずに抜き出し、[行N]の表示は含めないでください。"
                    "line_numberはその行の番号を整数で指定してください。"
                    "引用を特定できない項目はquoteを空文字、line_numberを0とし、引用を創作しないでください。"
                    "出力は指定したJSON Schemaに従ってください。"
                ),
            },
            {"role": "user", "content": transcript},
        ],
        output_config={
            "format": {
                "type": "json_schema",
                "schema": schema_with_evidence,
            }
        },
    )

    # 拒否や出力打ち切りを正常な抽出結果として照合へ進めない。
    if response.stop_reason != "end_turn":
        raise RuntimeError(f"抽出が正常完了していません: {response.stop_reason}")
    text = next((block.text for block in response.content if block.type == "text"), None)
    if text is None:
        raise RuntimeError("JSON本文がありません")
    data = json.loads(text)
    summary, results = verify_quotes(data, transcript_lines)
    return {"summary": summary, "results": results}


def main():
    api_key = os.environ.get("ANTHROPIC_API_KEY")
    if not api_key:
        raise RuntimeError("ANTHROPIC_API_KEYを環境変数に設定してください")
    import anthropic

    # 1回の起動で1リクエスト。失敗時の自動再送はしない。
    client = anthropic.Anthropic(api_key=api_key, max_retries=0)
    result = extract_and_check(client)
    print(json.dumps(result, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()
接続の要点は、output_config.format.schemaにschema_with_evidenceを渡し、json.loadsで読み込んだdataをverify_quotesへ渡すことです。APIへ送る行番号付き原文と、照合に使うtranscript_linesは同じ辞書から作ります。API用教材は手作りのextracted_jsonを使いません。引用が一致しても、値の意味や担当の割り当ては人が前後の発言を読んで確認します。
quoteと行番号を追加するだけで、本当に幻覚を見つけられるんですか?
見つけられるのは、引用がその行にないといった不整合だよ。一致しても内容が正しいとは限らない。担当者・期限は全件、人が原文で確認してから確定する。
期待結果と確認方法:引用の判定と内容の確認を分ける
代替設計の期待結果は次の通りです。
- 抽出結果に、決定事項・担当者・期限と、確認に使う引用・行番号を保存する
- 照合スクリプトで、引用の空欄、行番号の不備、指定行との不一致を見つける
- 引用が一致した場合も内容確認待ちとし、全担当者・期限・決定内容を人が原文と照合する
次章の関数は、引用の不整合を見つけるための小さな照合処理です。
人は不一致の理由を直したうえで、一致・不一致の両方を含む全項目の担当者・期限・決定内容を確認します。
機械判定だけで確認対象を除外しないでください。
なお、業務上よくある落とし穴は「quoteが短すぎて照合が不安定になる」ことです。
対策として、quoteは意味が確定できる最小単位(ただし長すぎない範囲)で抜き出すようにプロンプトで指示します。
ここは運用の最適化が必要ですが、基本方針は変えません。
失敗時の対応:根拠不整合は撤回対象に回す
line_numberが文字起こしの行と対応しない、またはquoteがその行に含まれない場合、引用の対応を確認できていません。内容の創作とは限らず、行番号のずれや引用範囲の違いも考えられます。原因を調べるまで、その項目は未確認のままにします。
実装では、完全自動で削除するのではなく、次の運用が安全です。
- 一致しない項目に、行番号や引用が合わない理由を付ける
- 人が引用箇所と前後の発言を確認し、引用や行番号を直す
- 一致した項目も含め、担当者・期限・決定内容の意味を確認する
- 根拠が足りない値は未確認のままにし、人が確認した内容だけを確定議事録へ反映する
この工程で取り除けるのは、確認によって発見できた誤りです。
引用照合に通った項目にも意味の取り違えが残るため、機械の一致判定を「議事録の確認済み」という意味で使わないでください。
---
6. 3件の架空データで照合処理を試す
目標:JSONのquoteを文字起こしの行に機械照合する
ここでは、前章で設計した quote と line_number を使って、抽出結果の妥当性をチェックするPythonスクリプトを示します。
狙いは、空の引用や存在しない行番号、引用文の不一致を先に見つけることです。
担当者の割り当てや期限の意味はこの関数では判定せず、全項目を内容確認待ちとして返します。
具体的には、次の2つを入力します。
- 決定事項を含むJSON。decisions配列の各項目にquoteとline_numberがある。
- 行番号を正の整数、その行の原文を文字列とする辞書。まずは掲載の架空データをそのまま使う。
指定行に引用文が含まれるかを調べ、引用一致・不一致を返します。
どちらでも内容の確認状態は「未確認」のままです。
担当者や期限を自動承認する処理ではありません。
入力データ例:抽出JSONと会議文字起こし(オフライン例)
まず、架空の文字起こしと手作りの抽出JSONで照合だけを試します。以下の3つのコードを掲載順に1ファイルへまとめたものが教材のverify_quotes_demo.pyです。同じフォルダーでpython3 verify_quotes_demo.pyを実行すると、APIキーや公式SDKなしで結果を確認できます。第5章のAPI用教材も、このファイル内の文字起こしと関数を読み込みます。
会議文字起こし(例)
transcript_lines = {
    1: "では次の施策を決めます。",
    2: "Aさんが明日までに調査レポートをまとめてください。",
    3: "次回のレビューは来週の木曜にしましょう。",
    4: "Bさんはデザイン案を提出する担当でお願いします。",
    5: "期限は再来週の金曜日です。"
}
抽出結果JSON(例)
ここでは、あえて一部を不一致にして、未確認が出るケースも作ります。
extracted_json = {
    "decisions": [
        {
            "item": "調査レポートをまとめる",
            "owner": "Aさん",
            "deadline": "明日まで",
            "quote": "Aさんが明日までに調査レポートをまとめてください",
            "line_number": 2
        },
        {
            "item": "デザイン案を提出する",
            "owner": "Bさん",
            "deadline": "再来週の金曜日",
            "quote": "Bさんはデザイン案を提出する担当でお願いします",
            "line_number": 4
        },
        {
            "item": "(意図的に不一致)期限の引用",
            "owner": "Bさん",
            "deadline": "再来週の金曜日",
            "quote": "次回のレビューは来週の木曜にしましょう",
            "line_number": 5
        }
    ]
}
3件目はline_numberが5なのに、quoteには行3の内容が入っています。この引用の不一致を検出できるかを確認します。2件目の引用には期限が含まれていないため、引用が一致しても、期限との対応は行5を含む文脈を読んで確かめる必要があります。
照合関数:引用の状態を判定し、全件を内容確認待ちにする
以下の関数は、上のtranscript_linesとextracted_jsonに続けて使います。verify_quotes_demo.pyを直接実行すると手作りJSONを照合し、第5章のapi_extract_and_check.pyを実行するとAPIが返したJSONを同じ関数で照合します。関数の役割は引用の所在の確認です。JSON全体のスキーマ検証や、人による確認結果の保存は含みません。
- 入力のdecisionsが配列か、各要素が辞書かを確認する
- line_numberが正の整数で、文字起こしに存在するかを確認する
- quoteが空白だけではない文字列で、指定行に部分一致するかを確認する
- 引用の判定をstatusへ保存し、一致時もreview_statusを「未確認」とする
- 照合件数、引用一致件数、引用不一致・入力不備件数、内容確認待ち件数を集計する
def verify_quotes(extracted, transcript_lines):
    if not isinstance(extracted, dict):
        raise ValueError("抽出結果は辞書にしてください")
    decisions = extracted.get("decisions")
    if not isinstance(decisions, list):
        raise ValueError("decisionsは配列にしてください")
    if not isinstance(transcript_lines, dict):
        raise ValueError("transcript_linesは行番号と本文の辞書にしてください")

    results = []
    quote_match_count = 0

    for d in decisions:
        if not isinstance(d, dict):
            results.append({
                "raw_item": d,
                "status": "入力不備・要確認",
                "review_status": "未確認",
                "reason": "決定事項の要素が辞書ではありません",
            })
            continue

        line_no = d.get("line_number")
        quote = d.get("quote")
        status = "入力不備・要確認"
        reason = ""

        # boolはPythonではintの一種なので、型を厳密に確認する
        if type(line_no) is not int or line_no < 1:
            reason = "line_numberは正の整数にしてください"
        elif not isinstance(quote, str) or not quote.strip():
            reason = "quoteは空白だけではない引用文にしてください"
        elif line_no not in transcript_lines:
            status = "引用不一致・要確認"
            reason = f"行番号が文字起こしに存在しません: {line_no}"
        elif not isinstance(transcript_lines[line_no], str):
            reason = "参照先の行本文が文字列ではありません"
        elif quote not in transcript_lines[line_no]:
            status = "引用不一致・要確認"
            reason = "quoteが該当行に含まれていません"
        else:
            status = "引用一致・内容要確認"
            reason = "担当者・期限・決定内容を原文の前後関係と照合してください"
            quote_match_count += 1

        out = dict(d)
        out["status"] = status
        # 引用が一致しても、内容を確認済みにしない
        out["review_status"] = "未確認"
        out["reason"] = reason
        results.append(out)

    summary = {
        "照合件数": len(results),
        "引用一致件数": quote_match_count,
        "引用不一致・入力不備件数": len(results) - quote_match_count,
        "内容確認待ち件数": len(results),
    }
    return summary, results


if __name__ == "__main__":
    summary, results = verify_quotes(extracted_json, transcript_lines)
    print(summary)
    for r in results:
        print(r["status"], r["review_status"], r.get("owner"), r.get("deadline"))
期待される判定の考え方
- 空でないquoteが指定行に含まれるなら、statusは「引用一致・内容要確認」
- 行が存在しない、またはquoteが含まれないなら「引用不一致・要確認」
- 行番号や引用の型、空引用などに問題があれば「入力不備・要確認」
- どの判定でもreview_statusは「未確認」。人の原文確認を自動で省略しない
ここで“部分一致”にしているのは、逐語引用の長さが運用によって変わり得るためです。
逆に厳格にやる(完全一致のみ)と、句読点や前後の省略で誤判定しやすくなります。
まずは部分一致で一次ゲートを作り、人が最終確認します。
全項目の担当者・期限・決定内容を人が確認するフロー
関数は引用照合のstatus、内容確認待ちを示すreview_status、理由のreasonを返します。人による確認結果を記録する機能は含まないため、運用先の確認表などへ別に残してください。
- 抽出結果と引用・行番号を用意する
- 関数で引用の一致、不一致、入力不備を確認する
- 不一致や入力不備の理由を調べ、引用・行番号を修正する
- 一致した項目も含め、全担当者・期限・決定内容を引用と前後の発言に照合する
- 確認した人と根拠、未確認の点を記録し、確認できた内容だけを議事録として共有する
たとえば「Aさんは担当しません」という実在の引用にowner="Aさん"を付けても、引用の文字列だけなら一致します。
期限の引用が別の議題に属する場合も同様です。
このため、引用一致の項目も人の内容確認が必要です。
例データの判定と、引用照合で分からないこと
掲載の架空データ3件をこの照合関数で実行すると、引用一致2件、不一致1件、内容確認待ち3件になります。
これは引用の位置を確認した件数です。
議事録の正確さやモデルの検出精度を示す値ではありません。
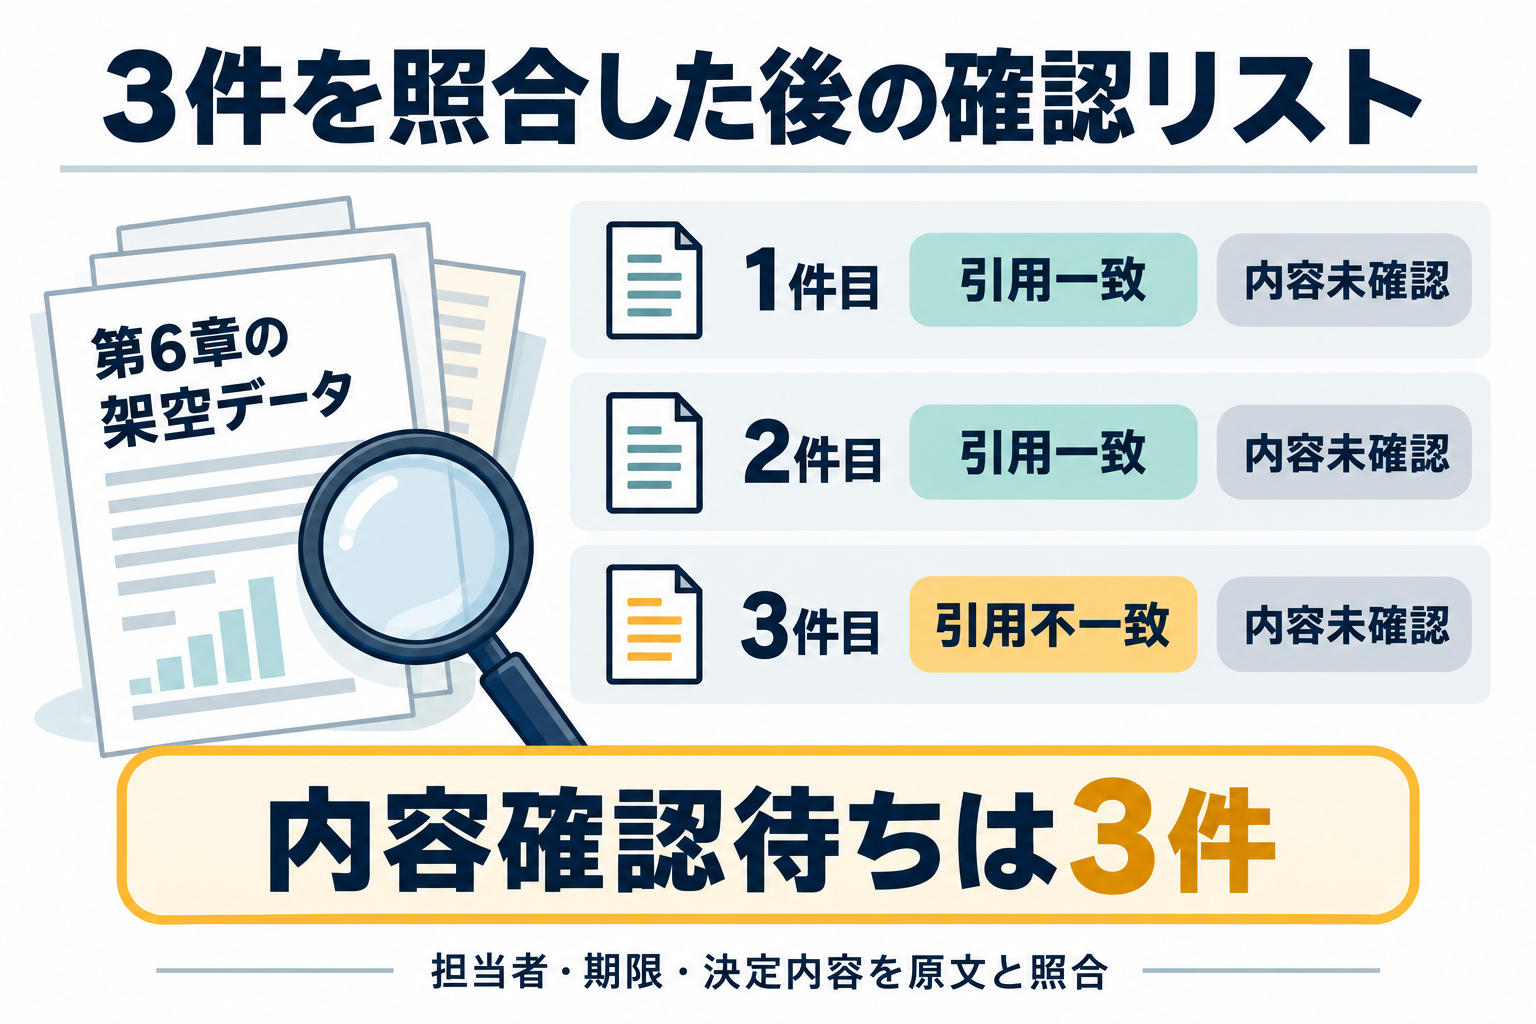
1件目と2件目はquoteが指定行に含まれ、3件目は行5に行3の引用が含まれないため不一致です。
ただし2件目のdeadlineは行4の引用だけでは確認できません。
行5がどの作業の期限かを人が文脈で確かめ、判断できなければ未確認のまま残します。
ただし、ここで重要な注意があります。実運用では、モデルが抜き出す `quote` の切り取り範囲(短すぎる/長すぎる/句読点の揺れ)や、文字起こしの行番号付与ルールが変わる可能性があります。
そのため、検証スクリプトの一致条件(部分一致か、許容する前後文字範囲をどうするか)は調整が必要です。
機械は引用の不整合を見つけ、人は全項目の意味を確認します。
この役割を分け、quoteの一致数を「正しい決定事項の数」と読み替えない運用にしてください。
7. 長い会議や未定の話題では何を足す?
条件が変わると設計も変わります。
ここでは3つの場面を扱います。
- 長い会議:先に逐語引用を整理し、人が原文へ戻る手掛かりを作る
- 複数話者・複数決定事項:引用と行番号を残し、担当者の結び付きを人が文脈で確認する
- 未定・検討中の事項:決定状況と担当・期限の有無を分けて記録する
長い会議では、決定内容、担当者の返答、期限の相談が離れた場所に出てくることがあります。
短くまとまった一覧だけでは、そのつながりが見えません。
引用と前後の発言に戻れる形を作りましょう。
そこで判断基準として、2万トークン超の長い会議では、先に逐語引用(direct quotes)を抜き出させてから、引用に基づいて抽出を行う運用に切り替えます。ポイントは「最初から決定事項だけをJSONで当てに行かない」ことです。
逐語引用を作る工程を挟むことで、後段のStructured Outputsが“根拠のある材料”を参照して組み立てやすくなります。
次に、複数話者・複数決定事項が入り混じる会議では、担当者の紐付けミスが起きやすくなります。
たとえばAさんが「担当は私ではない」と言った直後に、別のBさんの発言が続き、モデルが“直近の人”を勝手に担当としてしまうケースです。
このミスを抑える工夫として、スキーマ設計で「決定事項」そのものと「根拠となる発言(quote)」を1セットとして扱います。
各項目にquote(該当発言の逐語引用)とline_number(行番号)を残し、owner(担当者)がその発言でどの作業を引き受けた人なのかを確認します。引用内に名前があることだけでは、担当の合意を確認したことにはなりません。
6章の関数が調べるのはquoteと指定行の一致だけで、ownerとの意味的な対応は調べません。
担当者名が引用に含まれていても、否定や別の作業への言及の場合があるため、人が確認します。
さらに重要なのが、未確定事項を確定事項と誤って抽出させない設計です。
会議では「未定」「検討中」「後日連絡」「決まり次第共有」のような語が自然に出ますが、Structured Outputsの“形式は正しいJSON”が出るだけだと、値がうまく確定してしまう方向に寄ることがあります。
応用するなら、決定状況を表すdecision_statusに「決定」「未確定」「検討中」などのenumを設けます。これは6章の引用照合statusや、人が確認したかを示すreview_statusとは別の情報です。
enumが制約するのは返せる値の候補です。
「決定」と返っても、担当者や期限まで決まったとは限りません。
決定状況と各フィールドの整合性は、抽出後にアプリ側と人の確認工程で扱います。
たとえば議題自体は決定していても、担当者や期限は未定というケースを許容します。
文字列型を使うなら不明値を「未確認」に統一し、決定状況だけを根拠に氏名や日付を埋めないでください。
期限の種類を分ける応用では、具体日付・相対表現・未定などを別に記録できます。
本文のAPI例と6章の関数にはこの追加分類は含まれないため、導入する場合はスキーマと後処理をそろえて設計してください。
どの形式を選んでも、不明な期限をAIに補完させず、原文にある表現と人の確認結果を残すことが必要です。
3つの応用に共通するのは、確認に使う根拠を残すことです。
長い会議は引用を整理し、複数話者の会議は各項目と引用を結び付け、未確定事項は決定状況と担当・期限の有無を分けて記録します。
これらの工夫は、根拠をたどりやすくするための設計です。
自動で確定事項になる仕組みではなく、人が原文との対応を確認した内容だけを確定扱いにします。
引用照合では、行番号が実在し、quoteが含まれるかを調べます。
不一致の修正後も、一致した項目を含む全件について、担当者・期限・決定状況を原文の前後関係と照合します。
失敗時の対応はシンプルで、quoteが弱い(行が違う・見つからない)項目ほど「未確認」に倒して、再抽出は“引用抽出”の品質を上げる方向で行います。
---
8. 不一致・期限の取り違え・APIエラーを切り分ける
現場で起きる失敗は大きく3系統です。
1つ目は「存在しない担当者名が生成される」タイプ、2つ目は「期限の日付が別の日付に書き換えられる」タイプ、3つ目は「CitationsとStructured Outputsを同時指定して400エラーになる」タイプです。
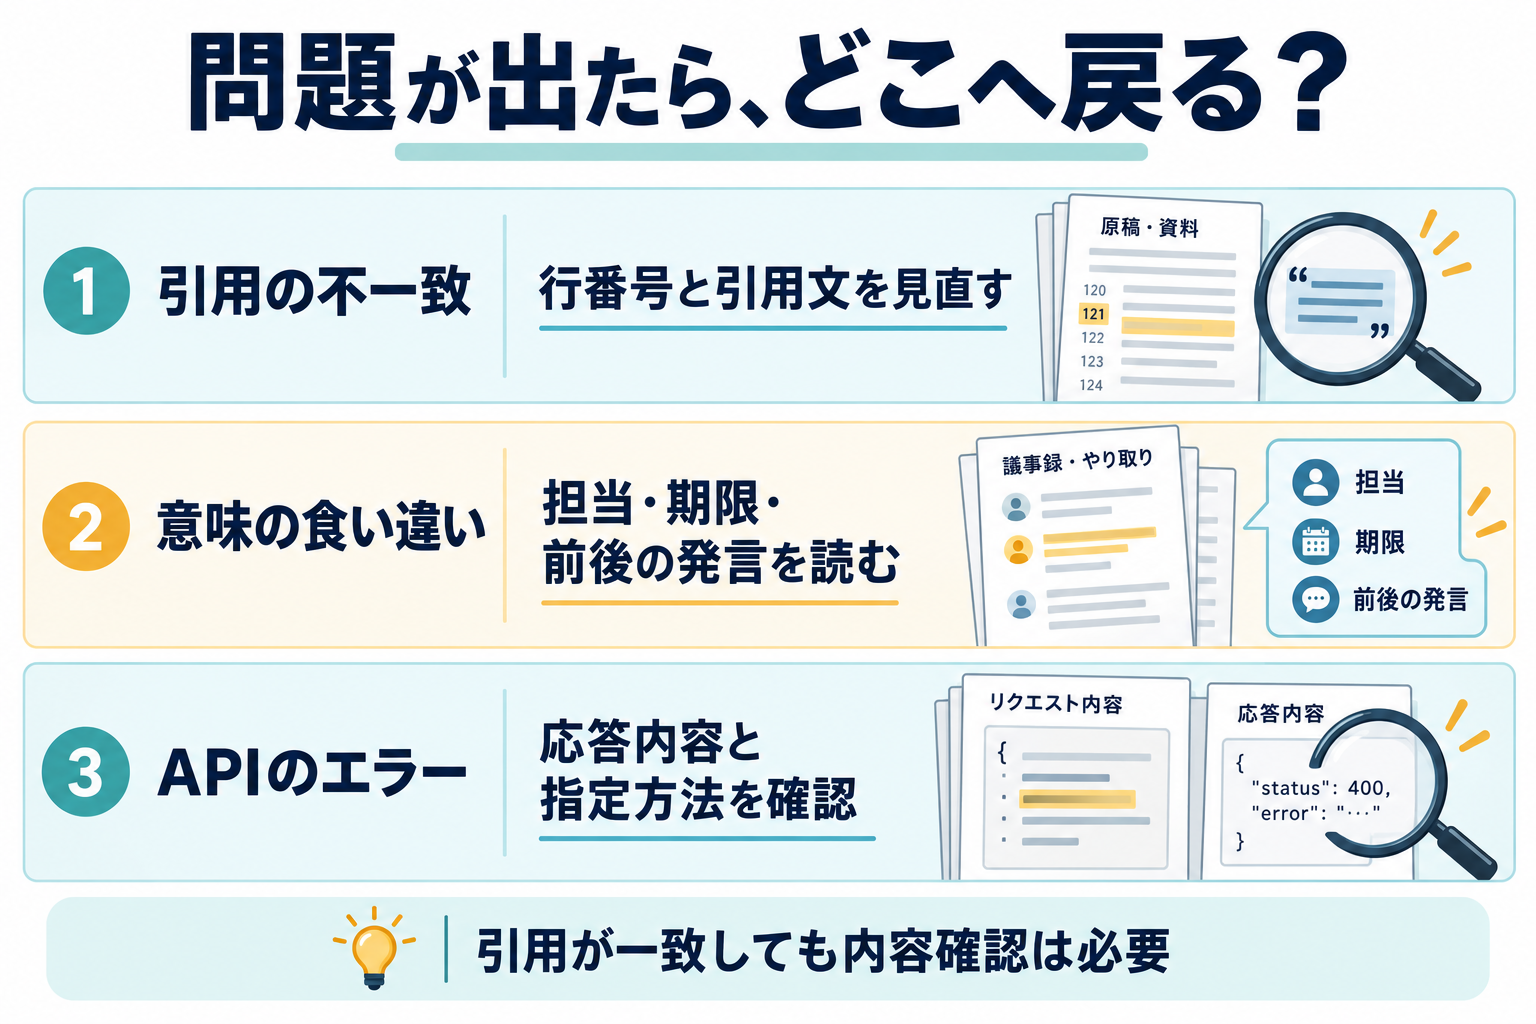
引用の不一致、意味の食い違い、APIエラーでは、確認する場所が異なります。
次の図で切り分けます。
引用の不一致は行番号と引用文へ、意味の食い違いは前後の発言へ、APIエラーは応答内容と指定方法へ戻ります。
確認する場所を分けると、原因を調べる順番を決められます。
最初の失敗、存在しない担当者名の検出方法です。Structured OutputsはJSON Schemaに厳密に従いますが、値の正しさまでは保証しません。
機械で確かめるのは、指定された行に引用文が存在するかです。
担当者がその決定事項を引き受けたかは、否定・提案・決定の違いも含めて前後の発言を人が確認します。
担当者名の文字列が引用に含まれるかは確認の手掛かりですが、それだけでは担当の合意を確認できません。
6章の関数には担当者名を調べる処理はありません。
引用と前後の発言を人が読み、誰がどの作業を担うと決まったかを確かめます。
引用と行番号は、人が確認を始める箇所を探す手掛かりになります。
では、担当者名が存在しない場合の直し方はどうしますか。まず、その項目の `quote` が見つからない、または担当者名の文字列が該当行に含まれないなら、その項目は“確定”扱いにしません。
本記事の文字列型スキーマを使う場合、原文で担当者を確認できなければownerを「未確認」にします。
nullを使う設計へ変えるなら型定義も変更が必要です。
引用照合のstatusと決定状況を混同せず、人の確認結果を別に記録してください。
たとえば文字起こしの行番号粒度が粗くて、複数話者が同一行に混ざっている場合は、引用抽出の粒度(行番号定義)を見直します。
失敗の根が“照合できない”にあるなら、出力側ではなく参照できる根拠側(quoteと行番号)の品質を上げるのが筋です。
次の失敗は、期限の日付が別の具体的な日付に書き換えられるケースです。
典型例として、フォローアップの「2週間後」などの相対表現や、その場で確定していない表現が、モデル側で“具体日付へ変換”されてしまうことがあります。
日付の文字が合っていても、別の作業の期限を取り出している場合があります。
「どの作業の期限か」と「確定した期限か」を元の発言で確認します。
本記事の期限フィールドはdeadlineです。
対応するquoteが原文に実在するかに加え、その発言が同じ作業の期限を示しているか、前後に訂正や条件がないかを人が確認します。
たとえばquoteに「木曜日」とだけあり、モデルが具体的な別の日付へ書き換えているなら、書き換えの兆候です。
まずは本文のスキーマどおり、deadlineに原文の期限表現を文字列で残します。
「2週間後」を根拠なく具体日付に変換しません。
具体日付・相対表現・未定を分類したい場合は、別の補助フィールドと後処理を追加する応用になります。
期限の型や文字列を調べる拡張は考えられますが、6章の関数は日付の数字やdeadlineとquoteの対応を調べません。
原文と異なる日付や、別の議題の期限が入っていないかを、人が確認してください。
原文にない日付や、別の作業の期限が入っていたら、人が原文の表現へ直します。
どの作業の期限なのか判断できなければ、deadlineは「未確認」のまま残します。
そして3つ目の失敗が、CitationsとStructured Outputsを同時に指定して400エラーになるケースです。
これは意味の誤りではなく、API側の組み合わせ仕様によるエラーです。
公式の説明として、「Citations and structured outputs are incompatible」であり、Structured Outputs(`output_config.format`)とCitations(`citations.enabled=true`)を同時に使うと400エラーが返ります。
理由は、Citationsが回答内に引用ブロックを挿入する必要があり、Structured Outputsの厳密なJSON schema制約と両立しないからです。
直し方は原因の切り分けから始めます。まずエラーが返ったら「Citationsを有効化しているdocumentブロック(document/search_result)と、output_config.format(json_schema)を同時に送っていないか」を確認します。
対処の順番としては次のどちらかに決めます。
A案は“Structured Outputsを優先する”で、Citationsは使わず、代わりにquoteと行番号照合で検証します。
B案は“引用ベースで根拠を見せる”で、Structured Outputsで厳密JSONを取りに行かず、別の設計(引用を表示するテキスト出力中心)に寄せます。
本記事の前提は「議事録の決定事項・担当者・期限をJSONで回す」なので、実務ではA案が自然です。
直した後の確認も役割ごとに分けます。
引用の不一致はスクリプトでもう一度調べます。
担当者が誤っていた場合は、人が発言の意味を確認してownerを修正し、根拠を確認できなければ「未確認」にします。
期限の取り違えは、人が同じ作業に対する発言かを確認して直します。
APIの400エラーは応答で原因を確認し、Citationsとの併用が原因なら、同時指定を外して設計を選び直します。
一般の400エラーをすべて併用問題と扱わないでください。
機械照合は引用の不整合を探す補助になります。
人による確認件数を自動で減らす根拠にはせず、すべての担当者・期限・決定内容を確かめる工程を残してください。
これにより、議事録(決定事項・担当者・期限)の品質を運用で守れます。
3パターンとも、結局は"分からなければ確定させない"ってことですね。
引用が一致していても、全件を内容確認待ちにしておこう。担当者・期限・決定事項を原文で確認した記録と一緒に管理すると、後から根拠をたどれるよ。
---
9. 共有する前の確認表
Structured OutputsとCitationsの使い分けと、6章の引用照合関数が扱う範囲をまとめます。
機械が調べる引用の所在と、人が確かめる内容の意味を分けて読んでください。
重要なのは、判断を迷わないことです。
迷うと、結果として“たまたま動いた設定”が混ざり、再現性が落ちます。
最初の早見表は、`output_config.format`(新しいStructured Outputsの指定)と、従来の `output_format`、さらにCitationsの関係です。
ポイントは「Citationsとstructured outputsは併用不可」である点です。
ここでは、読者が迷いやすい組み合わせを“可/不可”で整理します。
なお、`output_format`は非推奨であり、Python SDK v1.0以降では`output_format={...}`を`client.beta.messages.create()`へ渡すとTypeErrorになるため、実装上は`output_config.format`へ統一するのが前提です(公式仕様に基づく整理)。
| 目的 / 設定 | Structured Outputs(output_config.format: json_schema) | Citations(citations.enabled=true) | 結果の見込み |
| JSON Schemaに厳密準拠して議事録を抽出 | あり | なし | 可能 |
| 根拠の引用を回答に埋め込む(citationsで表示) | なし | あり | 可能 |
| JSON Schemaの厳密性と、引用(citations)を同時に欲しい | あり | あり | 400エラー(併用不可) |
| 旧ベータAPIへoutput_formatを直接指定する例 | 旧形式 | 組み合わせに依存 | 現行SDKの対応を確認。この記事はoutput_config.formatを使う。 |
次の表は6章の関数の確認範囲です。
担当者・期限の意味確認や確認結果の永続保存は、別の工程として用意します。
関数は、line_numberが正の整数として指定行を参照するか、quoteが空ではなくその行に含まれるかを調べます。owner・deadline・itemの意味や、原文全体からの抽出漏れは判定しません。
引用の判定結果は確認作業の手掛かりです。
原文にあるのに抽出されなかった決定事項もあり得るため、最終確認では抽出された項目に加え、原文の決定箇所からの漏れも確認してください。
| 確認対象 | 6章の関数が行うこと | 別途必要な確認 |
| line_number | 正の整数か、指定行が存在するかを確認 | 原文の行番号付与が正しいか |
| quote | 空引用を拒否し、指定行との部分一致を確認 | 引用の前後に否定や条件がないか |
| owner・deadline・item | 内容の正誤は判定しない | 全項目の担当・期限・決定内容と原文の対応 |
| status・review_status | 引用の判定と内容確認待ちを区別 | 人が確認した根拠と結果の記録 |
| 集計 | 引用一致、不一致・入力不備、内容確認待ちの件数 | 抽出漏れや内容の誤りを別に点検 |
続いて運用上の注意点です。
まず制限事項として、ここで扱う照合は文字起こしに前提があります。
つまり、画像やホワイトボード議事録のような“テキストで行番号照合できない入力”は対象外です。議事録の抽出を自動化するなら、入力を行番号付きテキスト(文字起こし、テキスト化された発話ログ)に揃えましょう。
次にモデル依存です。
Structured Outputsは形式面(JSONの構文、必須フィールド、型)を厳密化しますが、値の意味(実在する担当者名や正しい日付)までは保証しません。
このため、幻覚(hallucination)対策は必ず“根拠照合”とセットで考えます。
また、2万トークン超の長い会議では、引用抽出を先に行う運用に切り替えることを再確認します。
公式ガイドでは、長文では先に逐語引用を抜き出し、その引用に基づいて回答させることで幻覚を減らす考え方が示されています。
本記事の設計でも、この発想をquote抽出工程と行番号照合に落とし込みます。
最後に、Structured OutputsとCitationsは併用不可です。
引用を見せたい欲求が強いほど同時指定を試したくなりますが、ここは仕様として400エラーになるので、用途に応じて切り替えます。
JSONで処理系を作るならStructured Outputs寄り、引用を人に提示するならCitations寄り、という役割分担にすると運用が安定します。
まとめとして、行動指針を箇条書きにします。
- 長い会議は、先に逐語引用を整理して原文へ戻る手掛かりを作る。
- 各項目に引用と行番号を残し、根拠が複数行にまたがる場合は前後の発言も確認する。
- 未定・検討中を区別し、担当者や期限が不明なら「未確認」として残す。
- 引用一致は内容確認済みを意味しない。担当者・期限・決定内容は全件を人が原文と照合する。
- 抽出された項目の確認に加え、原文の決定箇所から漏れがないか確認する。
- CitationsとStructured Outputsを同時指定せず、APIの拒否や出力打ち切りも正常結果として扱わない。
参考にした公式情報のURL一覧は次のとおりです。
- https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- https://platform.claude.com/docs/en/build-with-claude/citations
- https://platform.claude.com/docs/en/test-and-evaluate/strengthen-guardrails/reduce-hallucinations
初心者にも分かりやすいAI活用情報をこれからもお届けします。
この記事が少しでも参考になったら、AI実用ラボをフォローしていただけるとうれしいです。
 この記事の販売者