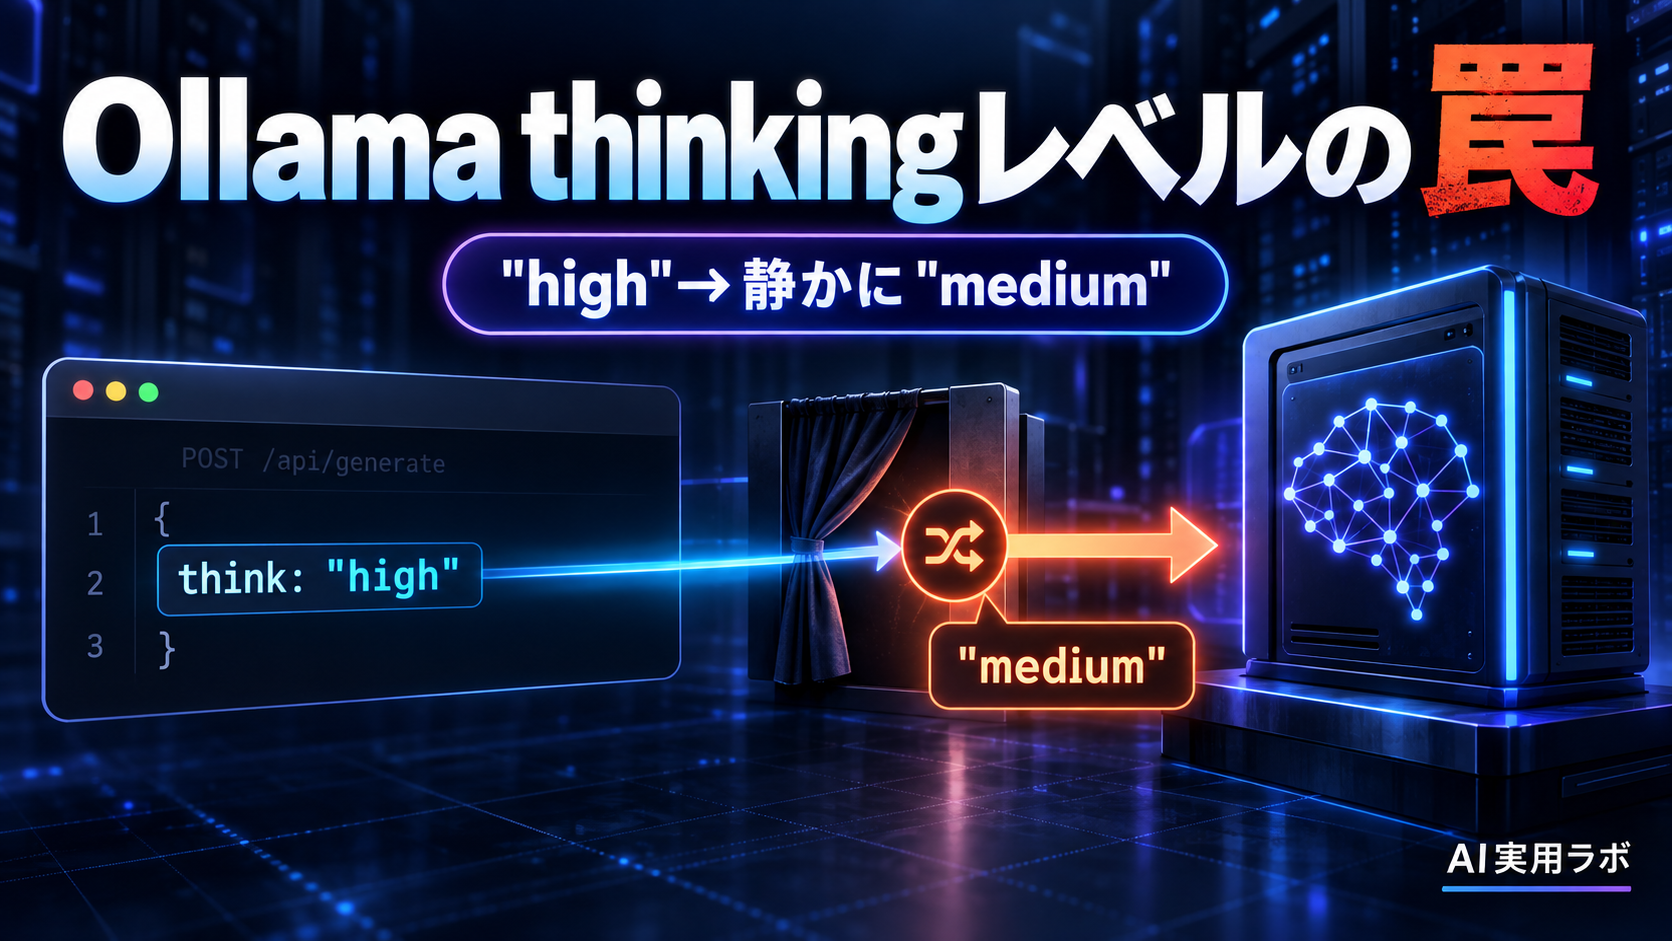
"high"を指定したのに変わらない?Ollama新APIでthinkingレベルを検出してもQwen3.8では罠がある
AI実用ラボ
Ollamaで複数のモデルを切り替えるエージェントを作っていて、モデルごとに「思考の深さ(thinkingレベル)」を自動で切り替えたいと思ったことはないだろうか。2026年9月19日公開のOllama v0.34.3で、まさにそれを可能にする新機能が/api/showに追加された。
ところが、Qwen3.8ではこの仕組みを素直に使うと、"high"や"max"を指定してもエラーが出ないまま何も変わらない、という罠が報告されている。実測データとあわせて中身を見ていく。
Ollama v0.34.3から/api/showがモデルごとの対応thinkingレベルと既定値を返すようになった。ただしQwen3.8:27bでは"high"/"max"/存在しない文字列を指定してもエラーにならず、静かに既定の"medium"が使われる(GitHub Issue #18632、2026-09-25時点でopen)。回避策は、/api/showが返すthinking.valuesの文字列をそのまま渡すこと(Qwen3.8なら"xhigh")。TL;DR
Ollamaの新しいAPIでモデルごとに使えるthinkingレベルが分かるようになったって聞いたので、さっそくthink: "high"を送ってみたんですけど…エラーは出ないのに、なんだか結果が変わってない気がするんです。
それ、Qwen3.8で報告されている罠かもしれません。エラーが出ないぶん気づきにくいんですが、順番に見ていきましょう。
この記事でできること
- Ollama v0.34.3で追加された/api/showのthinking自動検出機能の使い方が分かる
- thinkパラメータに指定できる値の種類と、それぞれの意味が分かる
- Qwen3.8で"high"/"max"を指定しても効かない具体的な症状と実測データが分かる
- 今すぐ使える回避策と、この問題の現状(2026-09-25時点で未解決)が分かる
対象読者
【中級者向け】Ollamaで複数モデルを切り替えて動かすエージェントやクライアントを実装している方を想定している。APIレベルでthinking(推論)の深さを制御しようとしている方向けのため、curlでのAPI呼び出しに抵抗がない中級者向けとした。
確認環境・確認日
- 確認日: 2026-09-25
- 対象: Ollama v0.34.3(2026-09-19公開)、Qwen3.8:27bのthinkingレベル自動検出機能
- 本記事は公式GitHubリリースノート、実装・ドキュメント追加PR、公式ドキュメント、GitHub Issueの原文を直接確認して作成。GitHub Issue内の実測データ(報告者の環境: Windows 11、NVIDIA CUDA、Ollama 0.34.4)はそのまま引用している
背景:なぜ「thinkingレベルの自動検出」が必要になったのか
Ollamaではgpt-ossやgemma4、qwen3.8のように、思考過程(thinking)を出力できるモデルが増えている。ただしモデルによって対応しているthinkingレベルの名称や段階数はバラバラだ。あるモデルはtrue/falseの2択、別のモデルは"low"/"medium"/"high"のような複数段階、というように仕様が統一されていない。
これまでは、クライアント側(エージェントやデスクトップアプリ)がどのモデルにどのレベルが使えるかを知る手段がなく、決め打ちで実装するしかなかった。この状況を解消するために追加されたのが、/api/showでモデルごとの対応レベルと既定値を返す機能である。実装したOllama開発者は、Pull Request本文で次のように述べている。
Expose supported thinking values and defaults through /api/show and ollama show, so clients can offer controls that match each model. Codex CLI and desktop configuration use this metadata to populate available reasoning levels.PR #18473 本文より
「クライアントがモデルごとに合った操作を提供できるように、対応するthinking値と既定値を/api/showとollama showから公開する。Codex CLIやデスクトップ設定は、このメタデータを使って選べる推論レベルを表示する」という趣旨だ。実際にCodex CLIのようなクライアントが、モデルを切り替えるたびに「このモデルはどのレベルまで選べるか」を表示するために、このメタデータを使っている。
この機能は2026-09-18にPR #18473としてマージされ、翌週2026-09-23にはドキュメント追加のPR #18501もマージされた。9月19日公開のv0.34.3リリースノートには、次のサンプルが載っている。
curl http://localhost:11434/api/show -d '{"model": "glm-5.3-flash:cloud"}'

{
  "thinking": {
    "values": ["low", "high", "max"],
    "default": "max"
  }
}
使ってみる:/api/showの呼び出し方とthinkパラメータの仕様
/api/showにモデル名を渡すと、レスポンスのthinkingフィールドに、そのモデルが対応する値の配列(values)と既定値(default)が入って返ってくる。
curl http://localhost:11434/api/show -d '{"model": "gpt-oss"}'レスポンス例(公式ドキュメントより)。
{
  "thinking": {
    "values": ["low", "medium", "high"],
    "default": "medium"
  }
}
このvaluesに含まれる文字列を、/api/chatや/api/generateを呼ぶときのthinkパラメータへそのまま渡す。公式ドキュメントではthinkパラメータの意味を次の4通りに整理している。
- true:thinking(思考過程)の出力をリクエストする
- false:thinking出力をリクエストしない(モデルが許可する場合)
- 未指定(null):モデルの既定値(/api/showのdefault)を使う
- 文字列:thinking.valuesに含まれるサポート対象レベルの中から1つを選ぶ
推論内容と回答は別フィールドで返る。/api/chatならmessage.thinkingとmessage.content、/api/generateならthinkingとresponseだ。ここまでが「仕様どおりに動けば」の話である。次の節で、Qwen3.8ではこの仕様どおりに動かない具体例を見ていく。
罠:Qwen3.8では"high"/"max"を指定しても"medium"のまま
2026-09-25(本記事作成の数時間前)に報告されたGitHub Issue #18632は、Qwen3.8:27bで/api/showが返すthinking.valuesと、実際に/api/chatが受け付ける値が食い違っていることを指摘している。2026-09-25時点でこのIssueはopenのまま、Ollama側の修正は行われていない。
報告によると、qwen3.8:27bに対して/api/showを呼ぶと、thinkingレベルは次のように返ってくる。
{"thinking": {"values": [false, "low", "medium", "xhigh"], "default": "medium"}}つまり、Qwen3.8で公式に対応しているのはfalse・"low"・"medium"・"xhigh"の4つだけで、"high"や"max"はこのモデルの対応リストに含まれていない。ところが、他の多くのモデルでは"high"や"max"が一般的な段階名として使われているため、クライアント側はつい"high"や"max"を送ってしまう。報告者の検証によると、Qwen3.8でこれらの値を送ってもエラーにはならず、HTTP 200が返り、中身は既定値"medium"を指定した場合と完全に同じだった。存在しない文字列(報告では"banana"という値でテストしている)を送った場合も同様に、エラーにならず"medium"と同じ結果になったとされている。
実測比較表で見る:出力が完全に同じになる証拠
報告者は同一プロンプト・temperature: 0・seed: 1という条件を固定した上で、thinkパラメータだけを変えて5パターンを比較している。HTTPステータス、thinking部分の文字数、evalトークン数、thinking内容のSHA-1ハッシュ値を並べたものが次の表だ(GitHub Issue #18632の実測値をそのまま引用)。
| think値 | HTTPステータス | thinking文字数 | evalトークン数 | thinking内容のSHA-1 |
| "medium" | 200 | 13,252 | 4,585 | dc2c173362 |
| "high" | 200 | 13,252 | 4,585 | dc2c173362 |
| "max" | 200 | 13,252 | 4,585 | dc2c173362 |
| "banana" | 200 | 13,252 | 4,585 | dc2c173362 |
| "xhigh" | 200 | 45,367 | 12,185 | 4d06ef4288 |
この表の読み解き方はシンプルだ。"medium"・"high"・"max"・"banana"の4行は、文字数もトークン数もSHA-1ハッシュ値も一字一句まで完全に一致している。つまりOllamaは"high"や"max"、意味のない"banana"という文字列を受け取っても、内部では黙って"medium"として処理しているということだ。一方"xhigh"だけは、thinking文字数が3倍以上(45,367字)、evalトークン数も倍以上(12,185)に増え、SHA-1ハッシュ値も別の値になっている。Qwen3.8の最上位レベルである"xhigh"を実際に引き出せるのは、この表の中では"xhigh"という文字列を直接指定した場合だけだった、ということになる。
HTTPステータスが200のままなんですね…エラーになってくれた方が、まだ気づけたのに。
そうなんです。エラーなら実装のどこかで気づけますが、成功扱いで既定値にすり替わるので、出力の中身まで比較しないと分かりません。次の実例を見てください。
気づけない実害:OpenClawの例
この問題が厄介なのは、クライアント側が気づく手段がないことだ。HTTPステータスは200(成功)のままで、エラーメッセージも出ない。報告では、別のOSSプロジェクトであるOpenClawの実例が挙げられている(openclaw/openclaw#157762として報告)。OpenClawは「High」設定と「Maximum」設定の両方でthink: "high"を送信する実装になっていたが、Qwen3.8に対しては両方とも実質的に"medium"のまま動いており、設定を変えても何も変わっていないことに開発者が気づけていなかった、という内容だ。汎用的な段階名(low/medium/high/max)に頼ったクライアント実装が増えている中、Qwen3.8は"high"という段階名を持たない最初の主要モデルであるため、同じ落とし穴に気づかずにいるクライアントが他にもある可能性がある。
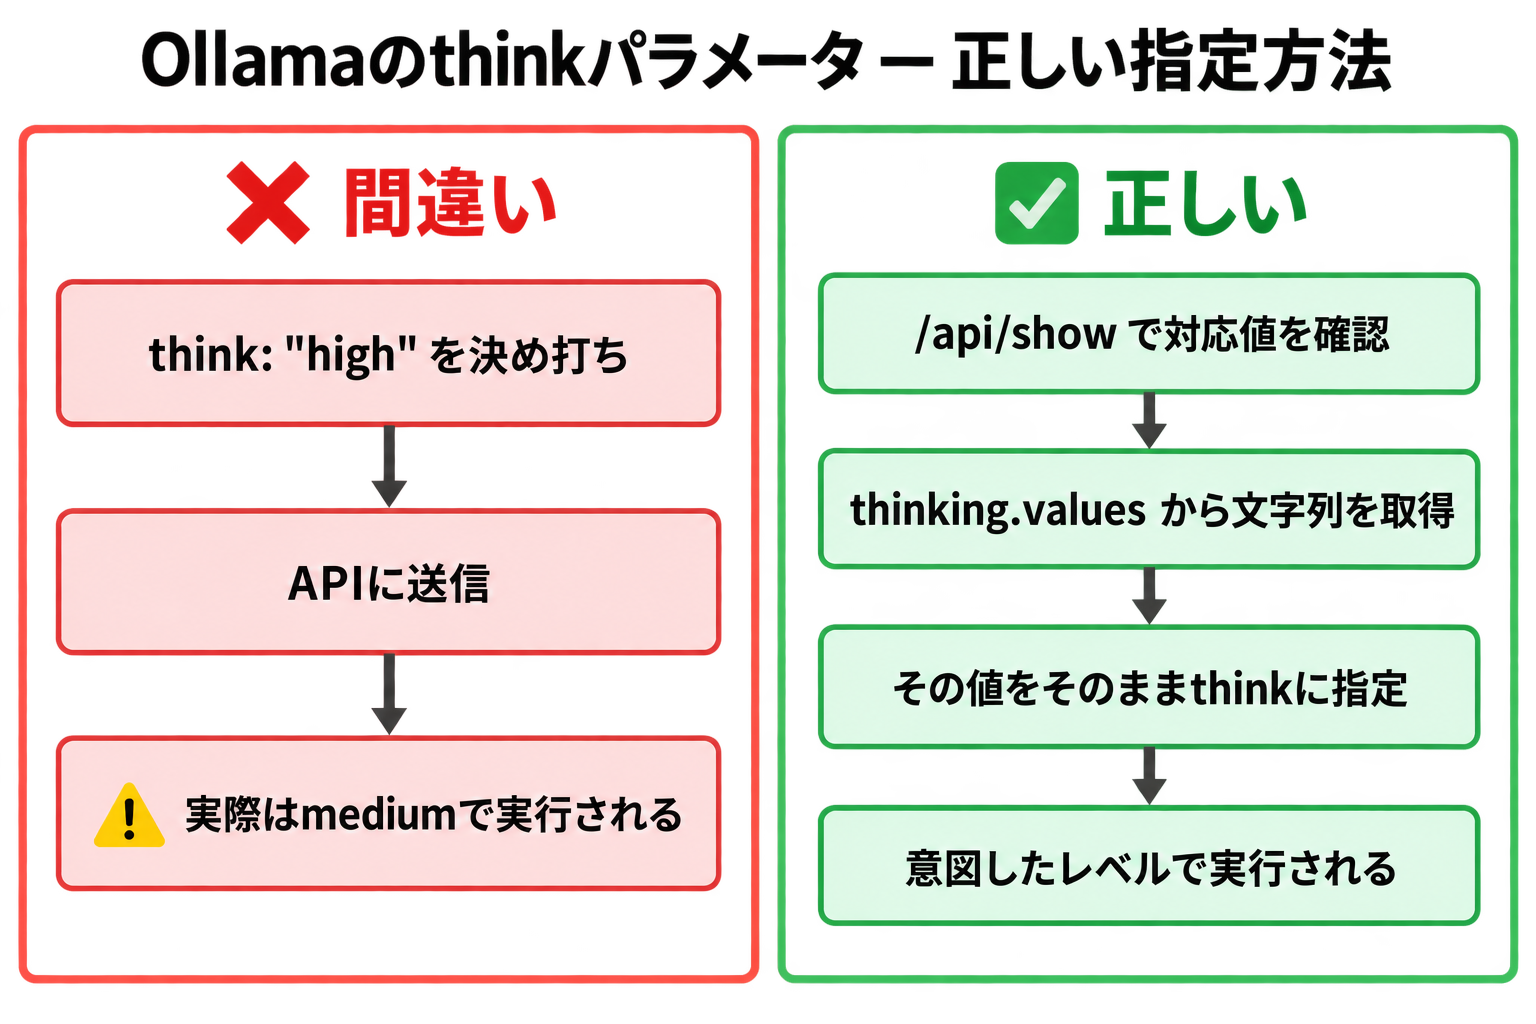
今すぐできる回避策
Ollama側の修正を待たずに今すぐできる対処は、汎用的な段階名を決め打ちで送るのではなく、/api/showが返すthinking.valuesに含まれる文字列をそのまま使うことだ。Qwen3.8の場合は次の手順になる。
- 対象モデルに対して/api/showを呼び、thinking.valuesを取得する(Qwen3.8なら[false, "low", "medium", "xhigh"])
- 最上位のthinkingレベルが欲しい場合は、"high"や"max"ではなく、取得した配列の中の最後の文字列(Qwen3.8では"xhigh")をそのままthinkパラメータに渡す
- "low"/"medium"などの中間レベルも、配列に含まれる文字列だけを使い、含まれない段階名を推測で送らない
つまり、モデルをまたいでlow/medium/high/maxという固定の4段階を決め打ちにするのではなく、モデルごとに/api/showで対応レベルを確認してから値を組み立てる実装にすることが、現時点での確実な回避策になる。
この問題は直っているのか
GitHub Issue #18632は、本記事の確認時点(2026-09-25)で「open」のまま、Ollama側の修正はまだ行われていない。報告者は解決案として、(1)Qwen3.8用のレンダラー内で"high"/"max"を"xhigh"へ変換して対応させる、(2)thinking.valuesにない文字列は400エラーで拒否し、対応する値の一覧を返す、という2つの案を提示しているが、どちらを採用するかはまだ決まっていない。
なお、Qwen3.8の"xhigh"をどう指定すればよいかという疑問自体は、今回のIssueより1か月近く前の2026-08-28に報告されたIssue #18091(「Does Ollama Qwen3.8-27B uses reasoning "xhigh"?」)から存在していた。thinkingレベルを外部から確認できる仕組みがなかった当時から、Qwen3.8の"xhigh"にどうアクセスすればよいのか分かりにくい状態が続いていたことになる。
早見表
| thinkに渡す値 | Qwen3.8での実際の挙動(2026-09-25時点) |
| "xhigh" | 対応。最上位のthinkingレベルで動作する |
| "medium" | 対応。既定値と同じ動作 |
| "low" | 対応(thinking.valuesに含まれる) |
| false | 対応(thinking.valuesに含まれる。thinking出力なし) |
| "high" | 非対応の文字列。エラーにならず"medium"と同じ結果になる |
| "max" | 非対応の文字列。エラーにならず"medium"と同じ結果になる |
| thinking.valuesに無い任意の文字列 | エラーにならず"medium"と同じ結果になる |
分かりました、これからは決め打ちのhigh/maxじゃなくて、必ず/api/showで確認してから値を組み立てるようにします。
それが確実です。Issueはまだopenなので、修正されたら早見表も更新しますね。
まとめ
- Ollama v0.34.3(2026-09-19公開)から、/api/showがモデルごとの対応thinkingレベルと既定値を返すようになった
- Qwen3.8:27bではthinking.valuesが[false, "low", "medium", "xhigh"]で、"high"/"max"はこの中に含まれない
- "high"/"max"や存在しない文字列をthinkに渡してもエラーにならず、静かに"medium"が適用される(GitHub Issue #18632、2026-09-25時点でopen)
- 実測データでは"high"/"max"/"banana"/"medium"の出力が完全に一致し、"xhigh"だけが別の結果になっていた
- 回避策は、汎用的な段階名を決め打ちにせず、/api/showが返すthinking.valuesの文字列をそのまま使うこと
 この記事の販売者