長時間動かしていたリサーチエージェントが、モデルIDをclaude-fable-5-1に書き換えた翌日から時々400エラーで落ちるようになった——ログを見るとthinkingブロックがどうとか、signatureが違うとか、見慣れないメッセージが並んでいる。コードは何も壊していないはずなのに、会話の途中から急に失敗する。そんな症状に心当たりがあるなら、この記事はそのものずばりの話をする。
Claude Fable 5.1が2026年9月1日にリリースされた。入力・出力価格はFable 5のまま、キャッシュ読み取りだけ4分の1(1MTokあたり$1.00→$0.25)に下がった。ただし3つの破壊的変更(強制ツール使用の禁止・thinkingブロックのモデル間非互換・履歴編集による思考ブロック無効化)のうち、履歴編集による無効化は自分でmessages配列を組み立てているコードだけが対象で、Claude Code等の上で動かしている場合はほぼ関係ない。残り2つはAPIを直接呼ぶ利用形態全般に関わる。TL;DR
キャッシュが4分の1になるなら、とりあえずモデルIDだけ書き換えて様子見しようと思ってるんですけど
自分でmessages配列を組み立てて会話履歴を編集しているコードなら、それだけだと途中から400エラーが出ます。Fable 5.1のthinkingブロックは、それより前のsystemプロンプトやtools配列、会話履歴に紐づいているので
この記事でできること
- Claude Fable 5.1で追加された3つの破壊的変更(強制ツール使用禁止・thinkingブロックのモデル間非互換・履歴編集による無効化)の具体的な発生条件とエラーメッセージが分かる
- 自分のコードが影響を受けるかどうかを、公式推奨の手順に沿った診断スクリプトで確認できる
- キャッシュ読み取り価格が4分の1になったことで、実際のエージェントセッションのコストがどれだけ変わるかをpythonで計算できる
難易度は【中級者向け】。Claude API(Messages API)でリクエストを組んだことがあり、tool_choiceやthinking、会話履歴(messages配列)を直接操作した経験がある人を想定しています。Claude CodeやClaude Agent SDK経由でしか使っていない場合、3つの破壊的変更のうち履歴編集による無効化は基本的に関係しません(理由は本文で説明します)。
対象読者
Claude APIを使って、自分でmessages配列を組み立てるエージェント・チャットボット・バッチ処理を運用している開発者。特に、会話履歴を要約で差し替えたり、古いツール結果を削除したり、systemプロンプトやtools配列を会話の途中で書き換えたりしているコードがあるなら、今日から関係のある話です。
Claude Code・claude.ai・Claude Managed Agents・Claude Agent SDKだけを使っている場合は、これらが会話履歴のプレフィックスを自動的にそのまま保持してくれるため、影響は限定的です。
確認環境・確認日
- 確認日: 2026年9月24日
- 対象バージョン: Claude Fable 5.1(モデルID claude-fable-5-1、Claude API)
- 本記事の情報源: Anthropic公式ドキュメント(モデル概要・What's New・移行ガイド)、Anthropic公式発表
- 「5万トークンのキャッシュを200ターン再読み込みする」条件は計算例です。実際のワークロードに合わせて値を置き換えてください
背景:なぜ「thinkingブロック」が会話を壊すのか
Claude Fable 5.1は、Fable 5から常時オンだったAdaptive thinking(モデルが自分で考える深さを判断する仕組み)をそのまま引き継いでいる。ここまではFable 5と同じだ。変わったのは、生成されたthinkingブロックの扱い方だった。
Fable 5.1の各thinkingブロックには、内部的に「どのモデルが」「どの会話のどの時点で」生成したかという情報が紐づけられている。これはsignatureと呼ばれる検証用の値としてブロックに埋め込まれており、次のリクエストでそのブロックを送り返すとき、APIは「このsignatureは今のリクエストの中身(systemプロンプト・tools配列・それより前の会話履歴)と矛盾していないか」を検証する。矛盾があれば、エラーを返すか、そのブロックを黙って捨てるかのどちらかになる。
なぜこんな仕組みを入れたのか、公式ドキュメントは理由そのものを明言していない。ただ、動作から逆算すると、thinkingブロックの中身(モデルの推論過程)は、それが生成された文脈と切り離すと意味が変わってしまう、という前提があるように読める。Claude Code・claude.ai・Managed Agents・Agent SDKは、会話履歴を追記専用(append-only)で扱うことがすでに前提になっているため、この検証に引っかかることがない。一方、自分でmessages配列を組み立てて、要約やトリミングのために履歴を書き換えているコードは、この前提を破ってしまいやすい。
うちは自前でエージェントのフレームワークを組んでるんですけど、会話が長くなると古いツール結果を消して短くしてます
それがまさに引っかかるパターンです。今まではエラーにならなかったので気づきにくいと思いますが、Fable 5.1ではその『消す』操作が原因で、次のリクエストが400エラーになる可能性があります
何が便利なのか
価格面では、Fable 5.1はFable 5と比べてキャッシュ読み取りだけが大きく変わった。
| 項目 | Claude Fable 5 | Claude Fable 5.1 | 変化 |
| 入力価格 | $10 / MTok | $10 / MTok | 変化なし |
| 出力価格 | $50 / MTok | $50 / MTok | 変化なし |
| 5分キャッシュ書き込み | $12.50 / MTok | $12.50 / MTok | 変化なし |
| キャッシュ読み取り | $1.00 / MTok | $0.25 / MTok | 75%減 |
| コンテキストウィンドウ | 1M トークン | 1M トークン | 変化なし |
| 強制ツール使用(tool_choice: any/tool) | 可能 | 不可(400エラー) | 破壊的変更 |
| thinkingブロックの互換性 | — | モデル間で一方向のみ | 破壊的変更 |
キャッシュ読み取りが基本入力価格に対して占める割合で見ると分かりやすい。Fable 5を含む大半のClaudeモデルは入力価格の10%、Claude Opus 5.5は5%なのに対し、Fable 5.1は2.5%まで下がっている。Anthropicは公式発表で「典型的なワークロードでFable 5比25%減、複雑なコーディング・エージェント作業では最大45%減」と説明しているが、これはキャッシュ読み取り以外のコスト(新規入力・出力)が変わらないことを踏まえた数字だ。どれだけ効くかはワークロード次第であり、具体的な試算は後半の応用・実践パターンで行う。
価格が下がったところだけ見て、いいことづくめかと思ってました
キャッシュ読み取りが安くなるのは間違いなく恩恵です。ただそれを受け取るには、まず3つの破壊的変更を踏まずに移行を終える必要があります
必要なもの
- Claude APIでFable 5(またはOpus 5、それ以前のモデル)を使っている既存のコード。特に、自分でmessages配列を組み立てて会話履歴を管理している箇所
- tool_choice、thinkingのいずれかを直接指定している箇所の心当たり(Claude Code・Agent SDKのみで使っている場合、この記事の破壊的変更2・3は基本的に対象外)
- 移行前にテストできるステージング環境、またはAPIキーを使ってprefix_mismatch_behaviorの挙動を試せる環境(本記事の診断スクリプトを動かす場合)
全体像
Fable 5.1への移行は、次の3段階で進めると事故が少ない。
- 棚卸し:自分のコードが「Claude Code/Agent SDK任せ」なのか「自分でmessages配列を組み立てている」のかを切り分ける。後者は3つの破壊的変更すべてが対象になりうるが、Claude Code/Agent SDK任せの場合でも、tool_choiceを直接指定していれば変更1(強制ツール使用)は関係する。履歴編集による無効化(変更3)だけは、Claude Code/Agent SDK任せなら公式に「影響を受けない」と明記されている
- 3つの破壊的変更ごとに対応:該当する箇所だけを、公式が示すBefore/Afterの形に書き換える
- キャッシュ経済性を再計算:読み取り価格が4分の1になったことで、自分のワークロードでどれだけコストが変わるかを試算し直す
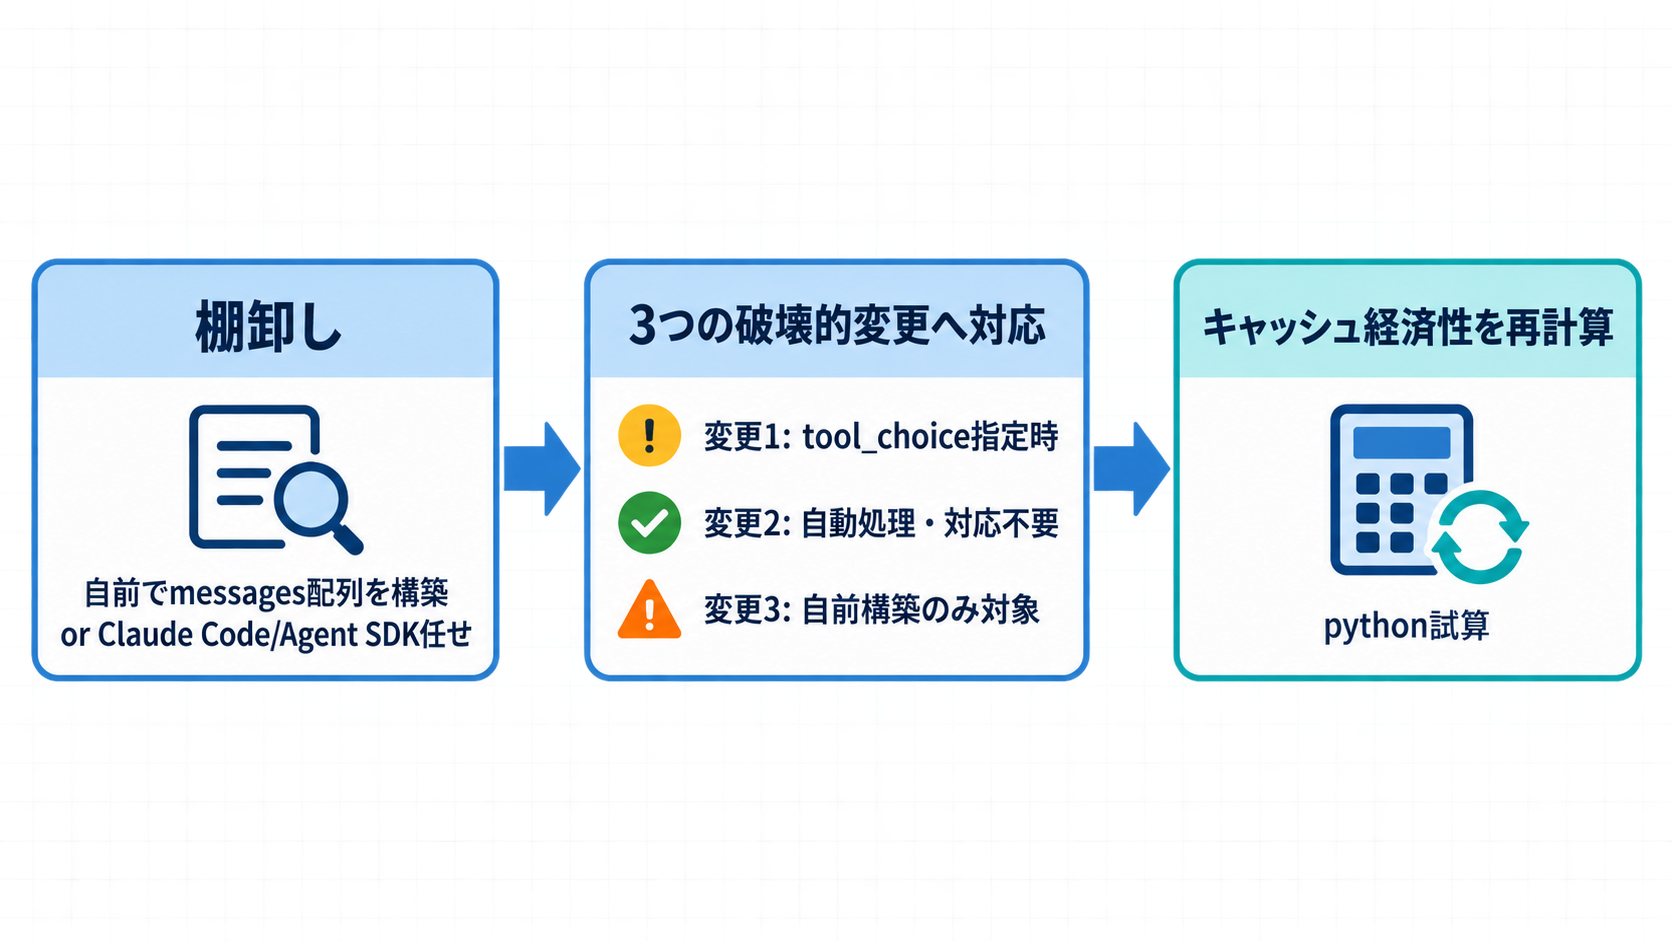
有料パートでは、この3段階それぞれを実際のコード・実際のエラーメッセージ(公式ドキュメントに記載された原文)付きで解説し、さらに「会話履歴が追記専用かどうかを診断するスクリプト」と「キャッシュ経済性を試算するコスト計算スクリプト」を添付として配布する。
 この記事の販売者